內容目錄
顯示
AGI 是通用人工智慧的英文縮寫,討論的是:一套人工智慧系統能否在廣泛任務上展現足夠的能力,而不只擅長某一類問題。看到新聞說 AI 考試得高分,還不能只憑這項成績判定它達到 AGI;要先看新聞採用什麼定義,以及實際測了什麼。
這篇從「通用」的意思開始,用一則假想新聞示範怎麼讀懂能力宣稱。你不需要懂程式,也不必先選邊相信哪家公司。
AGI 的「通用」是什麼意思?
人工智慧可以是協助電腦辨認文字、解題或做其他任務的系統。AGI 的英文全名是 Artificial General Intelligence,重點在「通用」:能力能否跨越多種不同任務,而不是所有事情都會、永遠不出錯。
例如,一套系統很會解數學題,換成整理郵件、讀懂新遊戲規則、處理沒有遇過的問題,表現如何仍要另外檢查。這些任務只是用來說明廣度,並不是公認的 AGI 必考清單。
判斷 AGI,要分開看廣度與表現
研究論文《Levels of AGI》把兩件事分開:廣度是能處理多少不同類型的任務;表現是各項任務做得多好。這是一種研究框架,不是全球統一的及格考試。原始研究也提醒,評估時要說明能力範圍與比較標準。
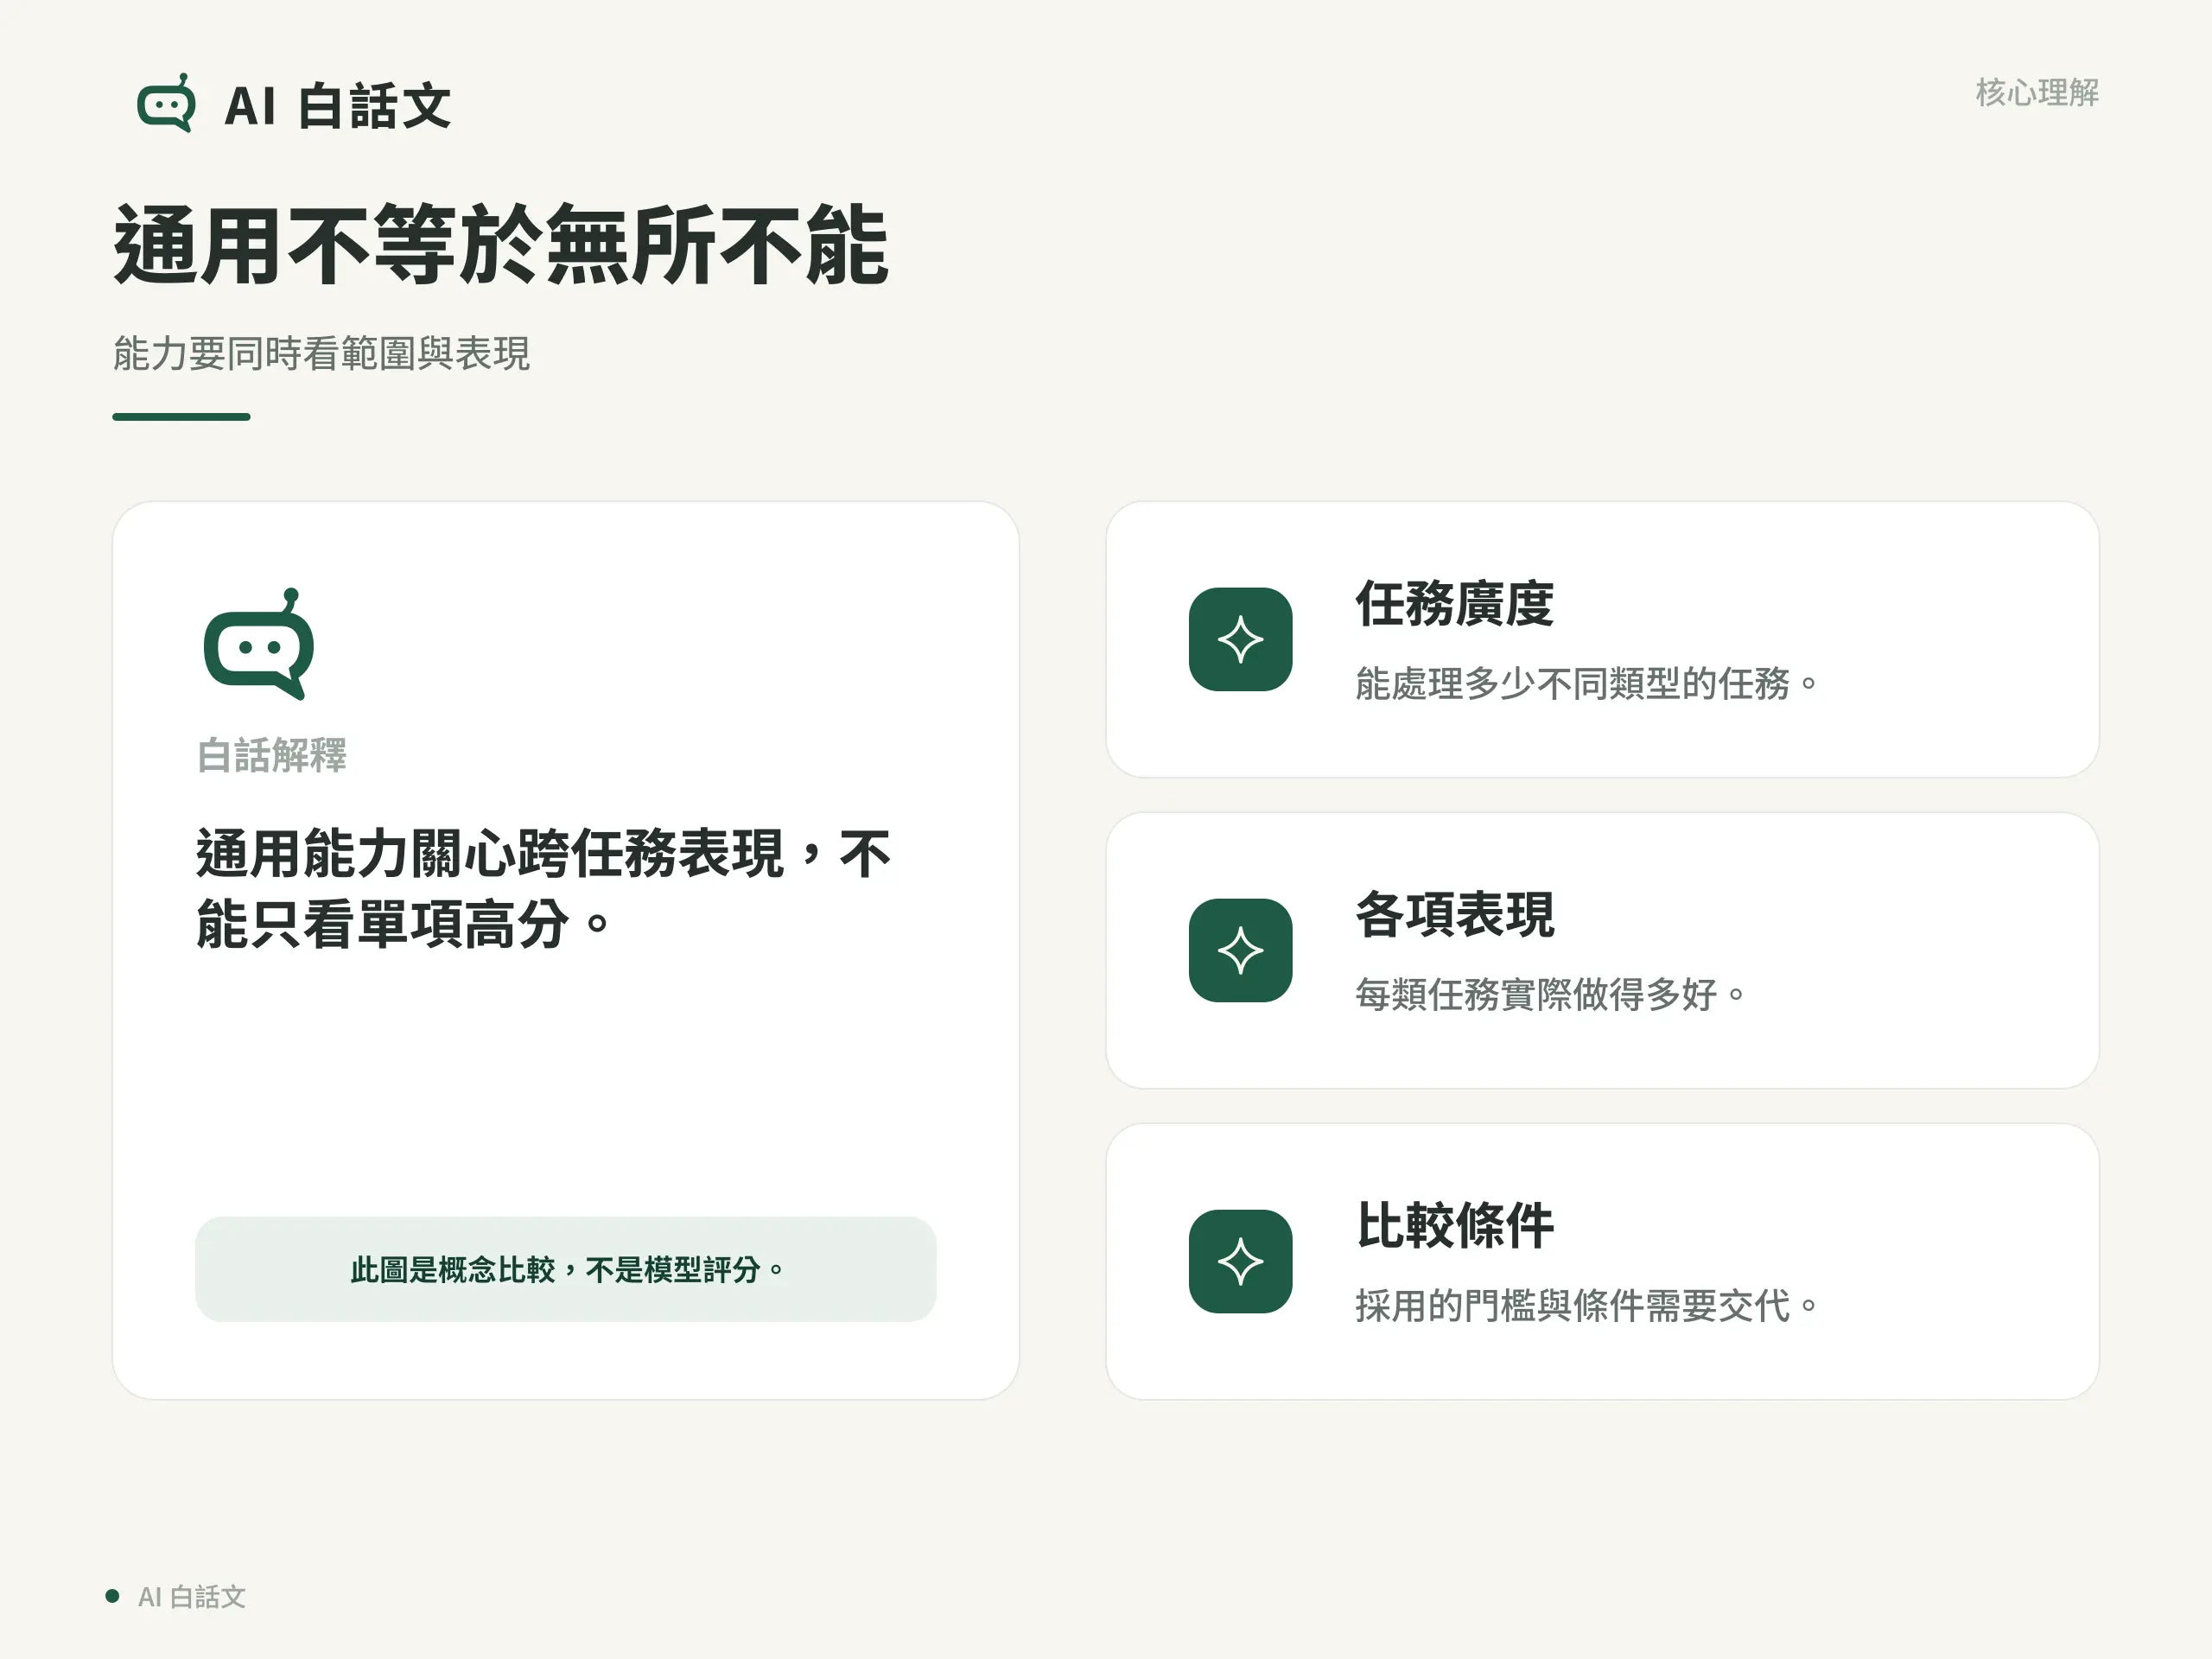
想像甲系統數學非常強,但其他任務沒測過;乙系統什麼都能回覆,卻常答錯。前者沒有證明廣泛能力,後者也不能用「會回答的項目很多」取代實際表現。只看其中一面,都不足以支持 AGI 的結論。
看到「已達 AGI」,先查這三件事
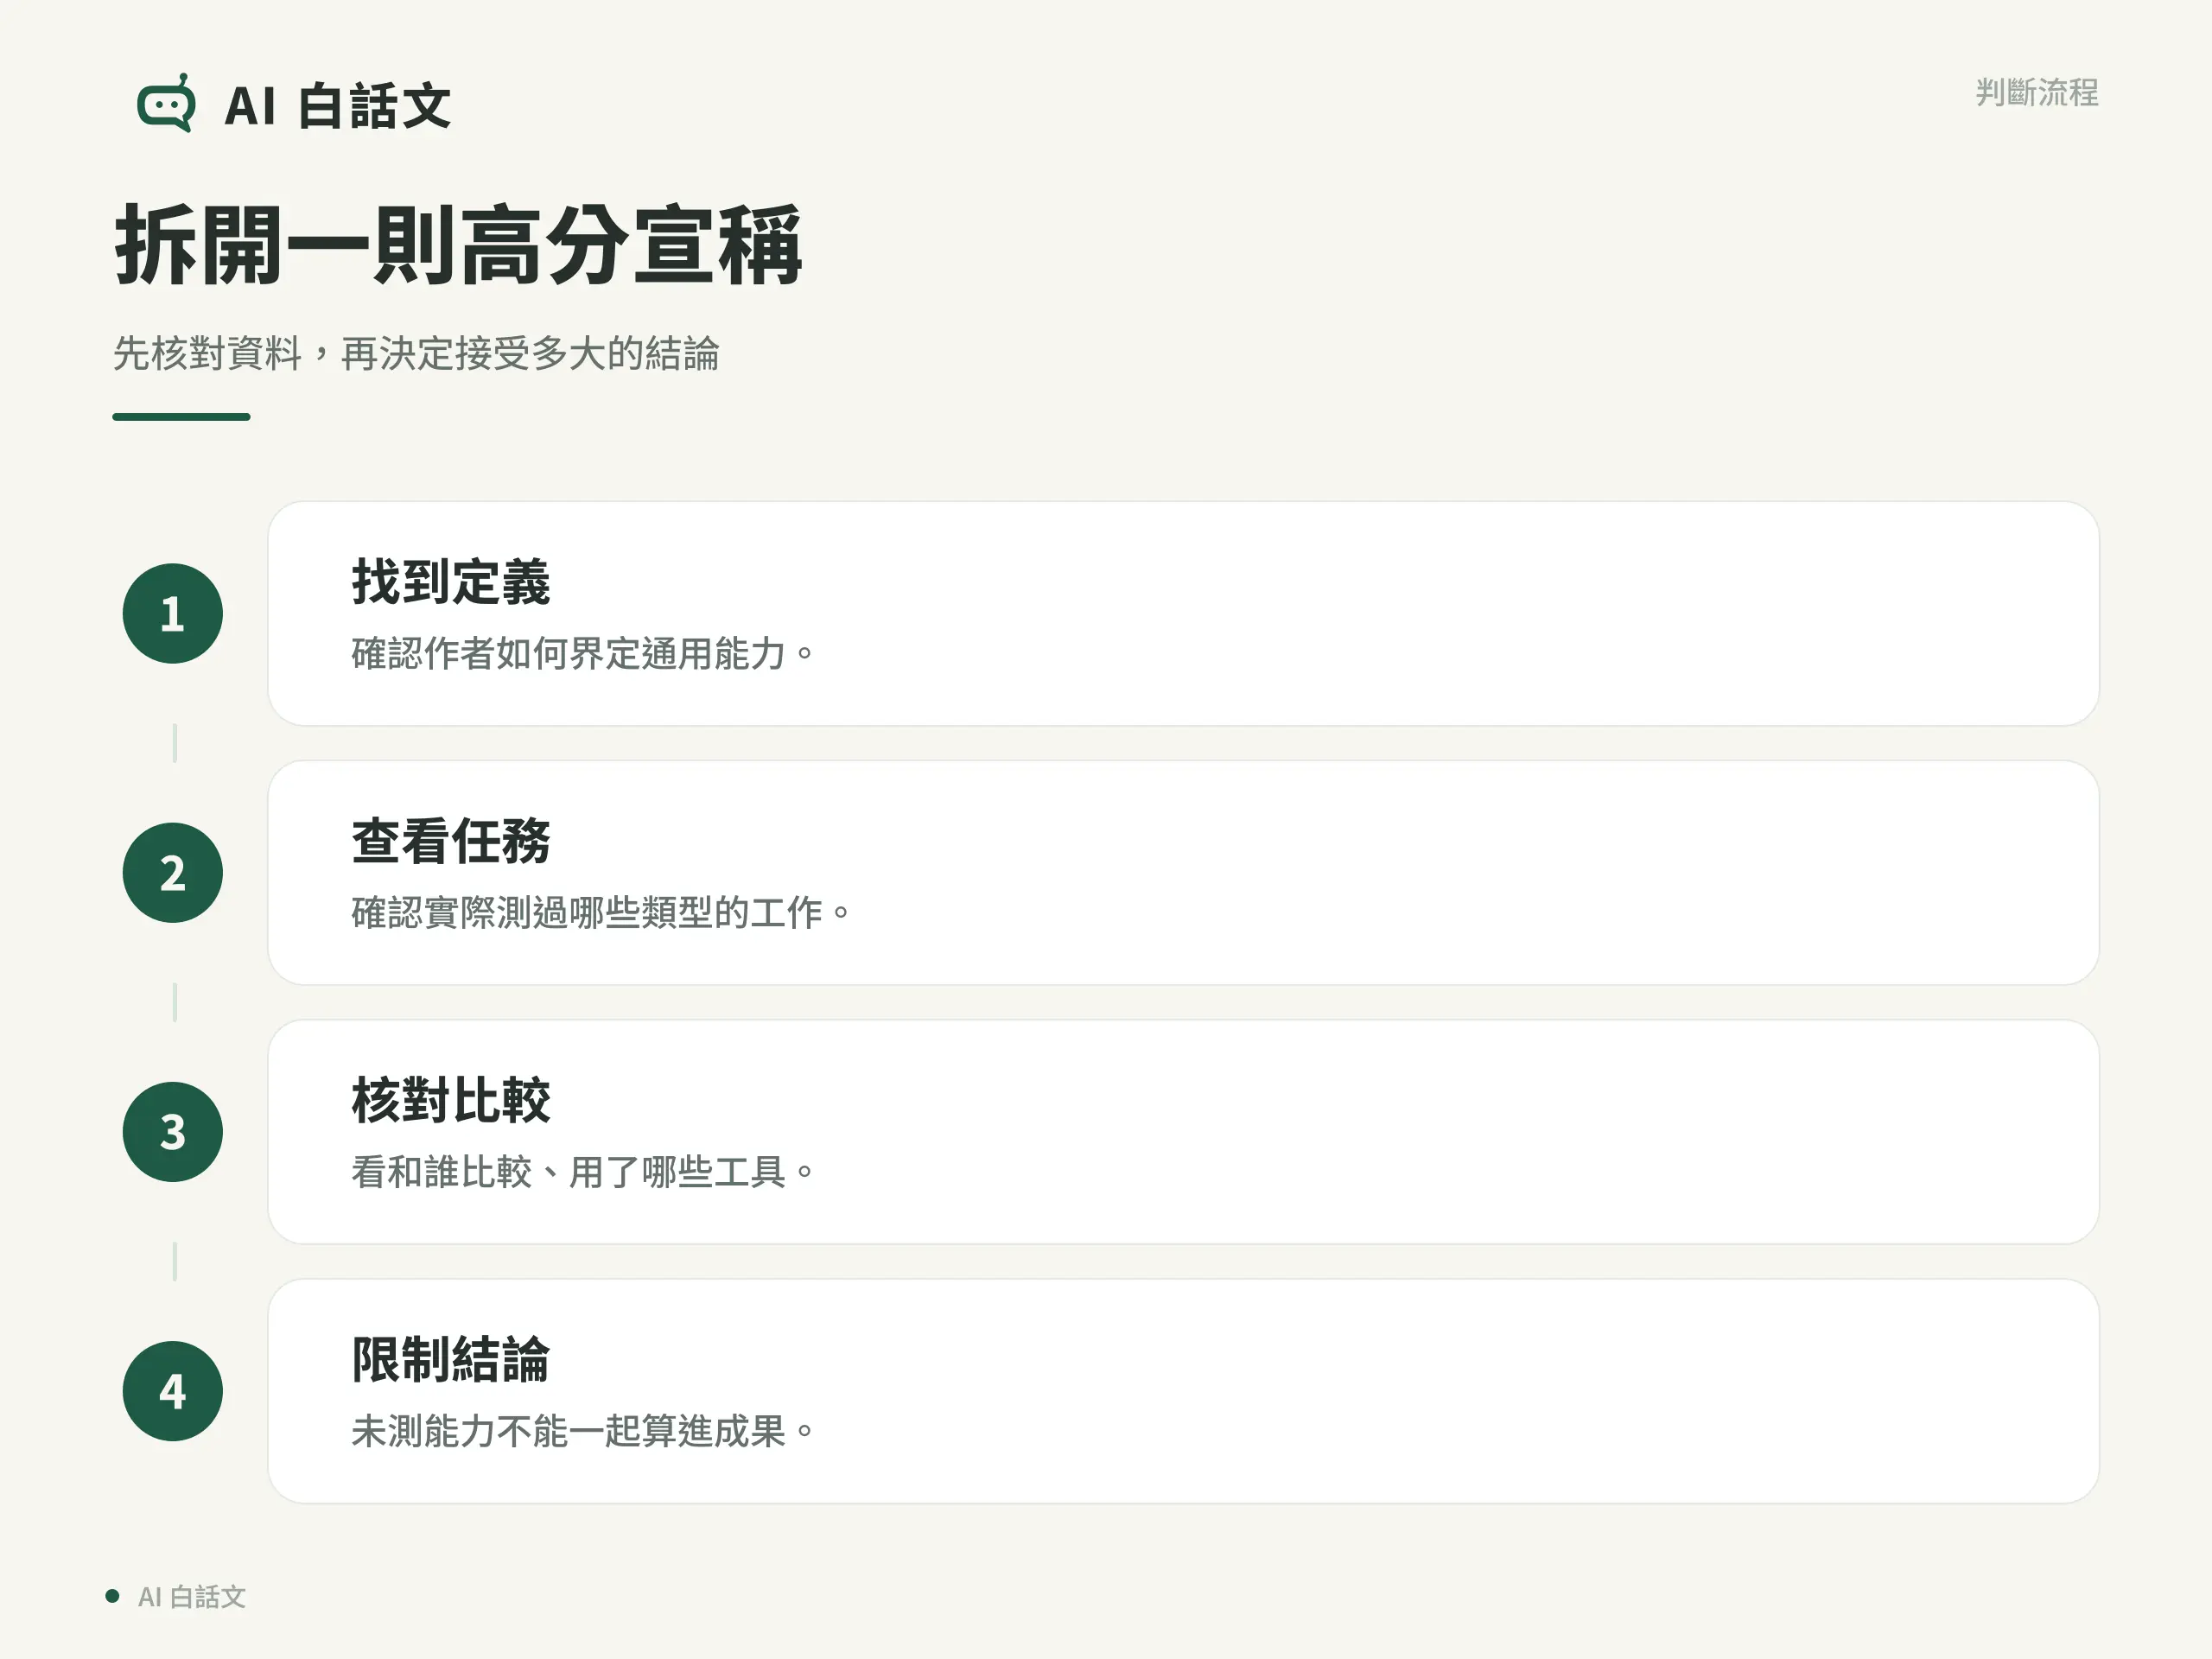
假設小安看到一則新聞:「AI 在數學測驗勝過人類,所以 AGI 已經來了。」這是本文自製的教學情境,不是對某個產品的測試報告。小安可以沿著三個問題往下查:
- 它把 AGI 定義成什麼?是單一測驗高分,還是跨多種工作的能力?定義沒有交代,結論就缺少判斷依據。
- 實際測了哪些任務?若只測數學,整理郵件與學習新規則等其他能力仍未得到證明;不能把沒測過的部分一起算進來。
- 「勝過人類」是跟誰、在什麼條件下比較?比較的是專家還是一般受試者?雙方是否有相同時間與工具?條件不同,分數的意義也不同。
查完後,小安能接受的結論可能只是:「這套系統在這份數學測驗、這些比較條件下表現較好。」這不是否定成績,而是讓結論停在證據支持的範圍。以上問題是閱讀方法,不是做完就能頒發 AGI 認證的程序。
同樣說 AGI,定義可能放重點在不同地方
OpenAI 的憲章把 AGI 描述為在多數具有經濟價值的工作上,表現超越人類的高度自主系統。這裡的「自主」是指做事需要多少人類介入,與能做多少種任務並不是同一個問題。
因此,同一則新聞即使交代了分數,也未必交代了完成過程需要多少人協助。OpenAI 的定義是該組織的取向,不能直接當成所有研究者的共同標準;讀不同的 AGI 宣稱時,先對齊定義才能比較。
AGI、單項超人與超級智慧差在哪?
「單項超人」只是在說某一類任務表現超越人類,例如特定棋類或某份測驗;它沒有同時說明其他能力。AGI 關心跨任務的廣度與能力門檻;「超級智慧」常以 ASI 表示,討論的是廣泛能力都達到超人水準的概念。
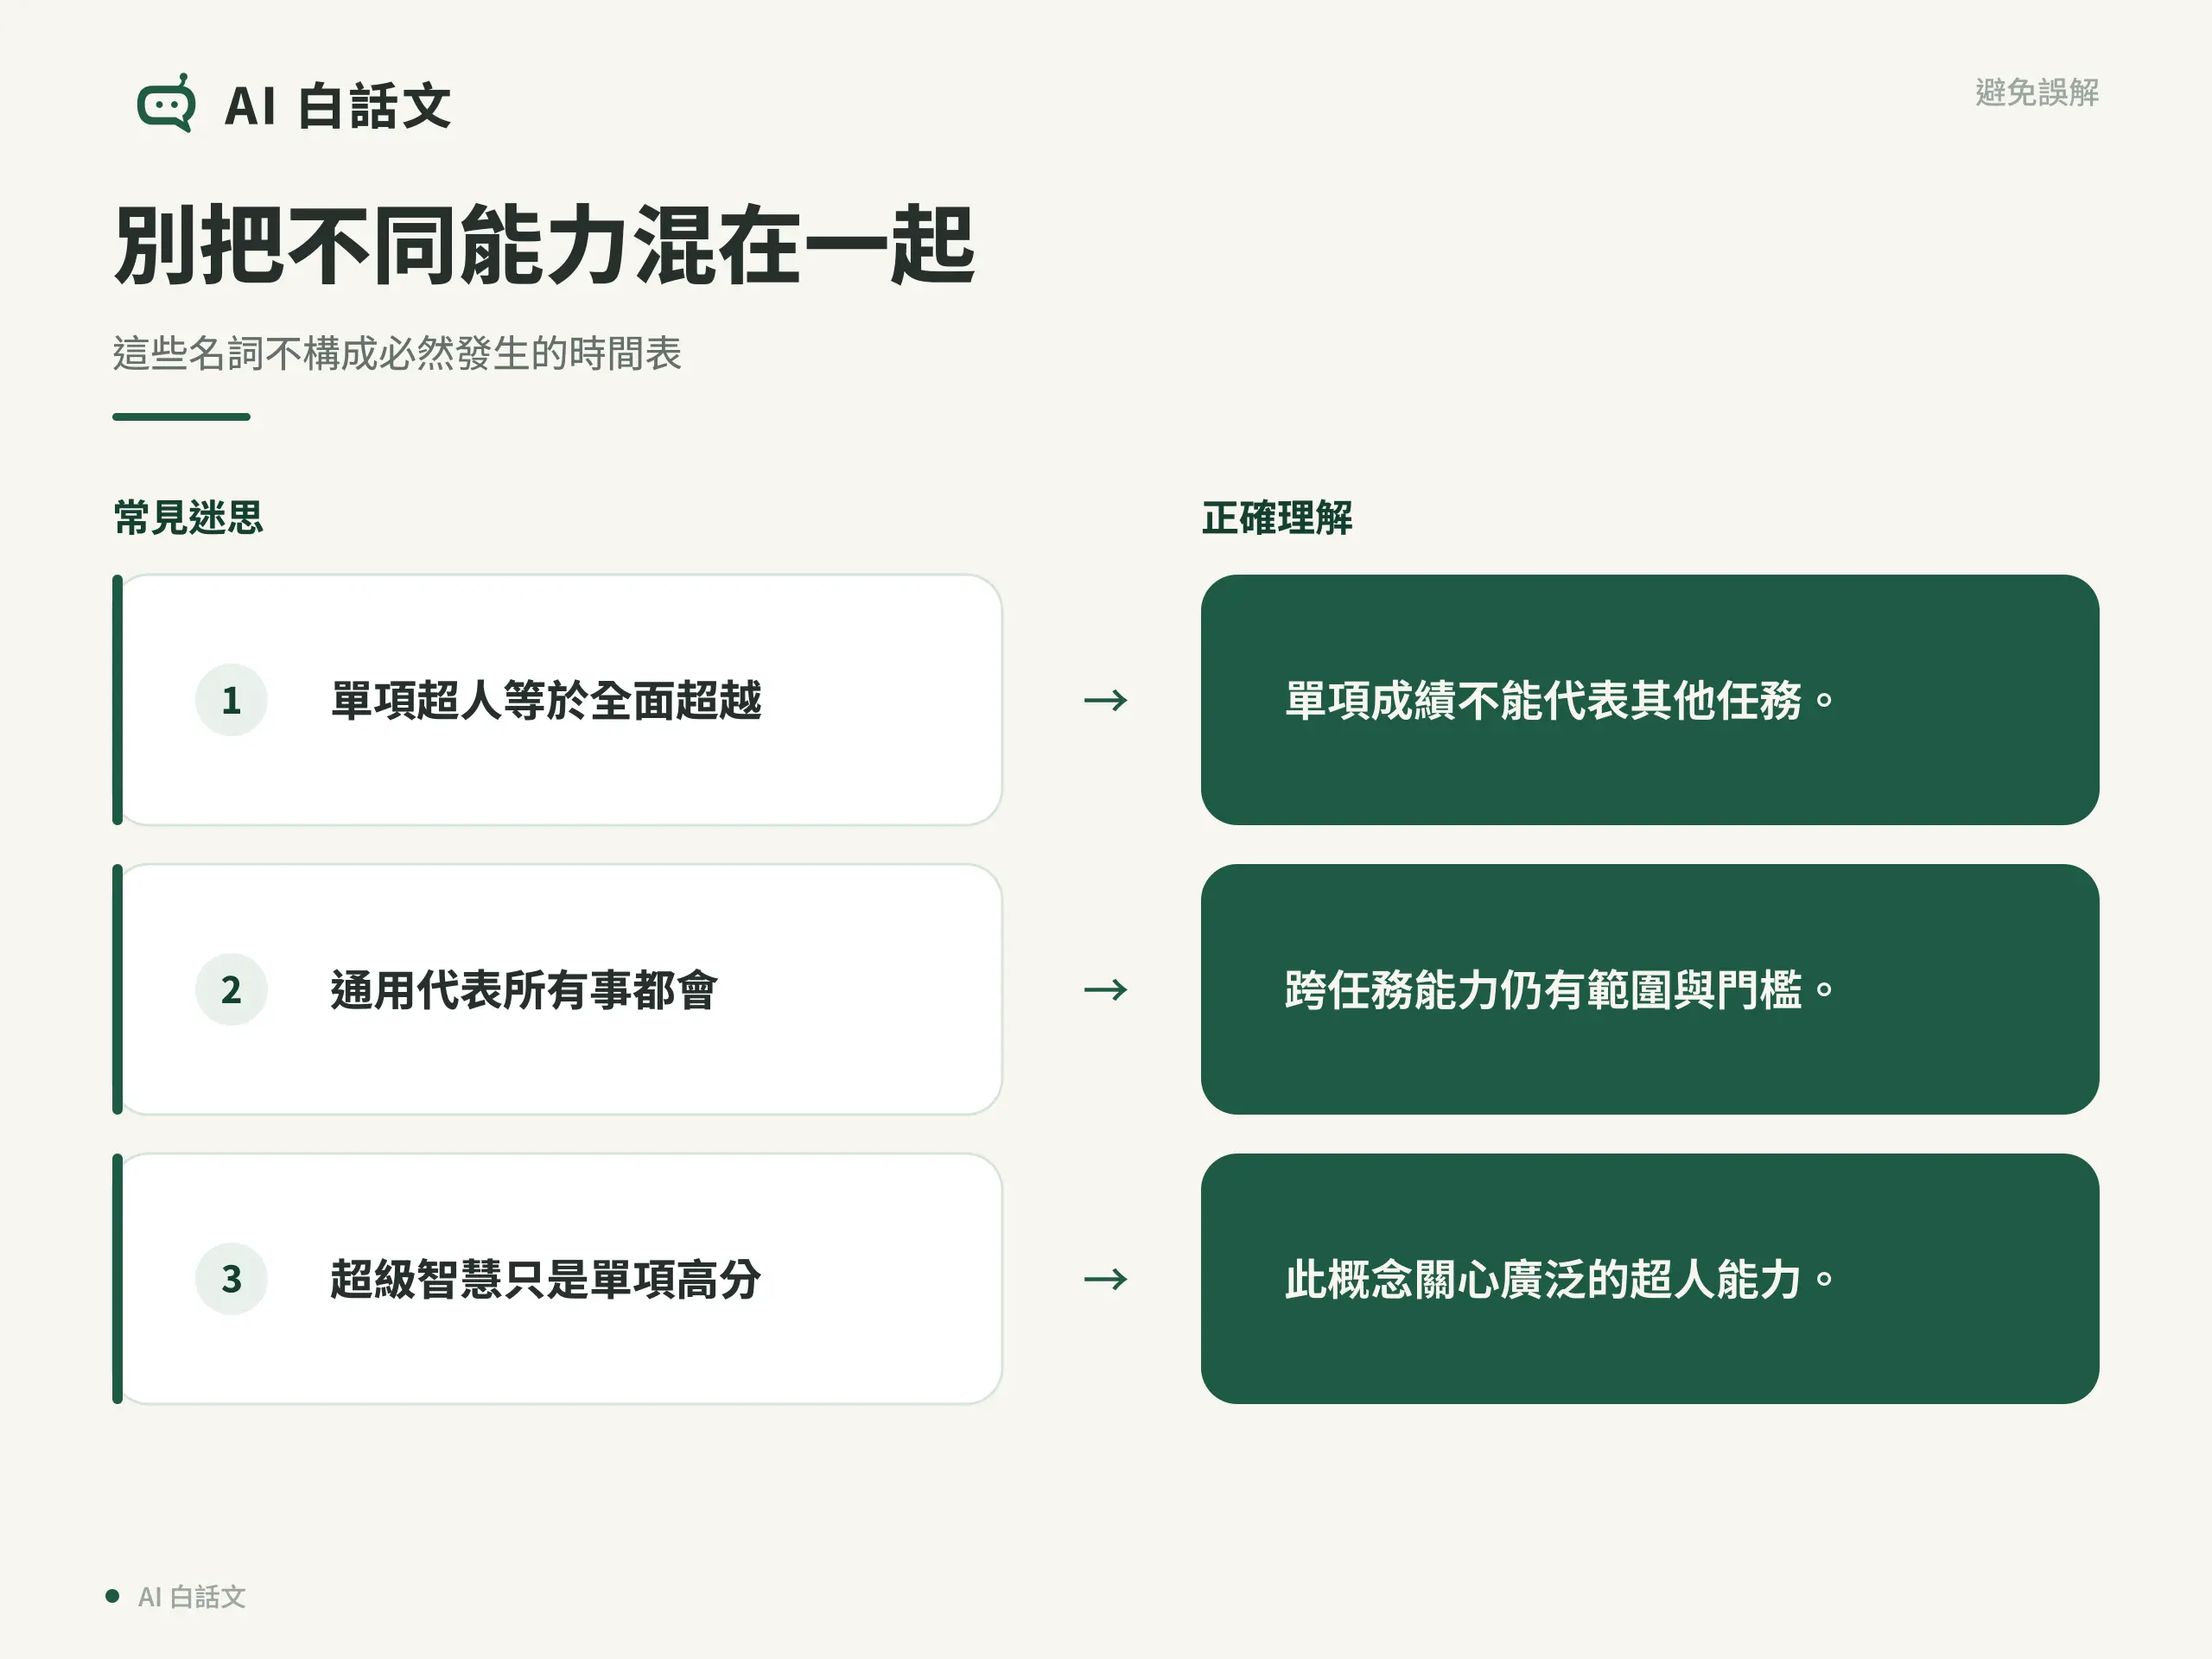
這三種說法承擔的主張不同。回到小安的新聞:數學測驗高分、具備廣泛能力、在廣泛任務超越人類,不能只因都用了「厲害」就互相替換。也不能把這些名詞畫成一定依序發生、每一步都有日期的進化表。
能力宣稱沒有回答哪些問題?
以可觀察能力為主的 AGI 定義,不一定把意識或感受當成先決條件。因此,一個系統表現很好,並沒有直接解答「它是否有自己的感受」;反過來,也不能僅憑這套能力框架宣判它一定沒有意識。
實現時間也是另一個問題。本文整理的定義與研究不能推出 AGI 必定在哪一年出現,也不足以替當下全世界的系統作統一認定。看到倒數年份時,要把它當成需要另查依據的預測,而不是已確認的時間表。
用證據判斷一句能力宣稱
理解 AGI,最有用的下一步是把「它很強」拆成可以核對的問題:採用什麼定義、會處理哪些任務、表現如何,以及完成時需要哪些協助。下次看到驚人的分數,先確認這個分數能支持多大的結論。
參考資料
資料查核日:2026 年 10 月 3 日。本文使用能力框架說明概念,未引用研究中的歷史模型評分作為現行排名。
重點整理
AGI 和現在使用的 AI 差在哪?
AGI 討論的是系統在廣泛任務上的能力目標。現有工具可能同時能寫作、解題或整理資料,但功能種類多,不等於已符合某套通用能力標準;仍要說明採用的定義、測試範圍與表現。
AGI 一定有自我意識嗎?
不一定以意識作為定義條件。以能力為主的 AGI 框架看的是系統能完成哪些任務、做得如何;這不能單獨證明它有意識,也不能單獨證明它沒有意識。
AGI 何時會出現?
本文引用的研究與組織定義無法給出可確認的年份。判讀時間預測時,先看預測者採用什麼定義、以哪些證據推估;不能把預測年份當成已確定的結果。