內容目錄
顯示
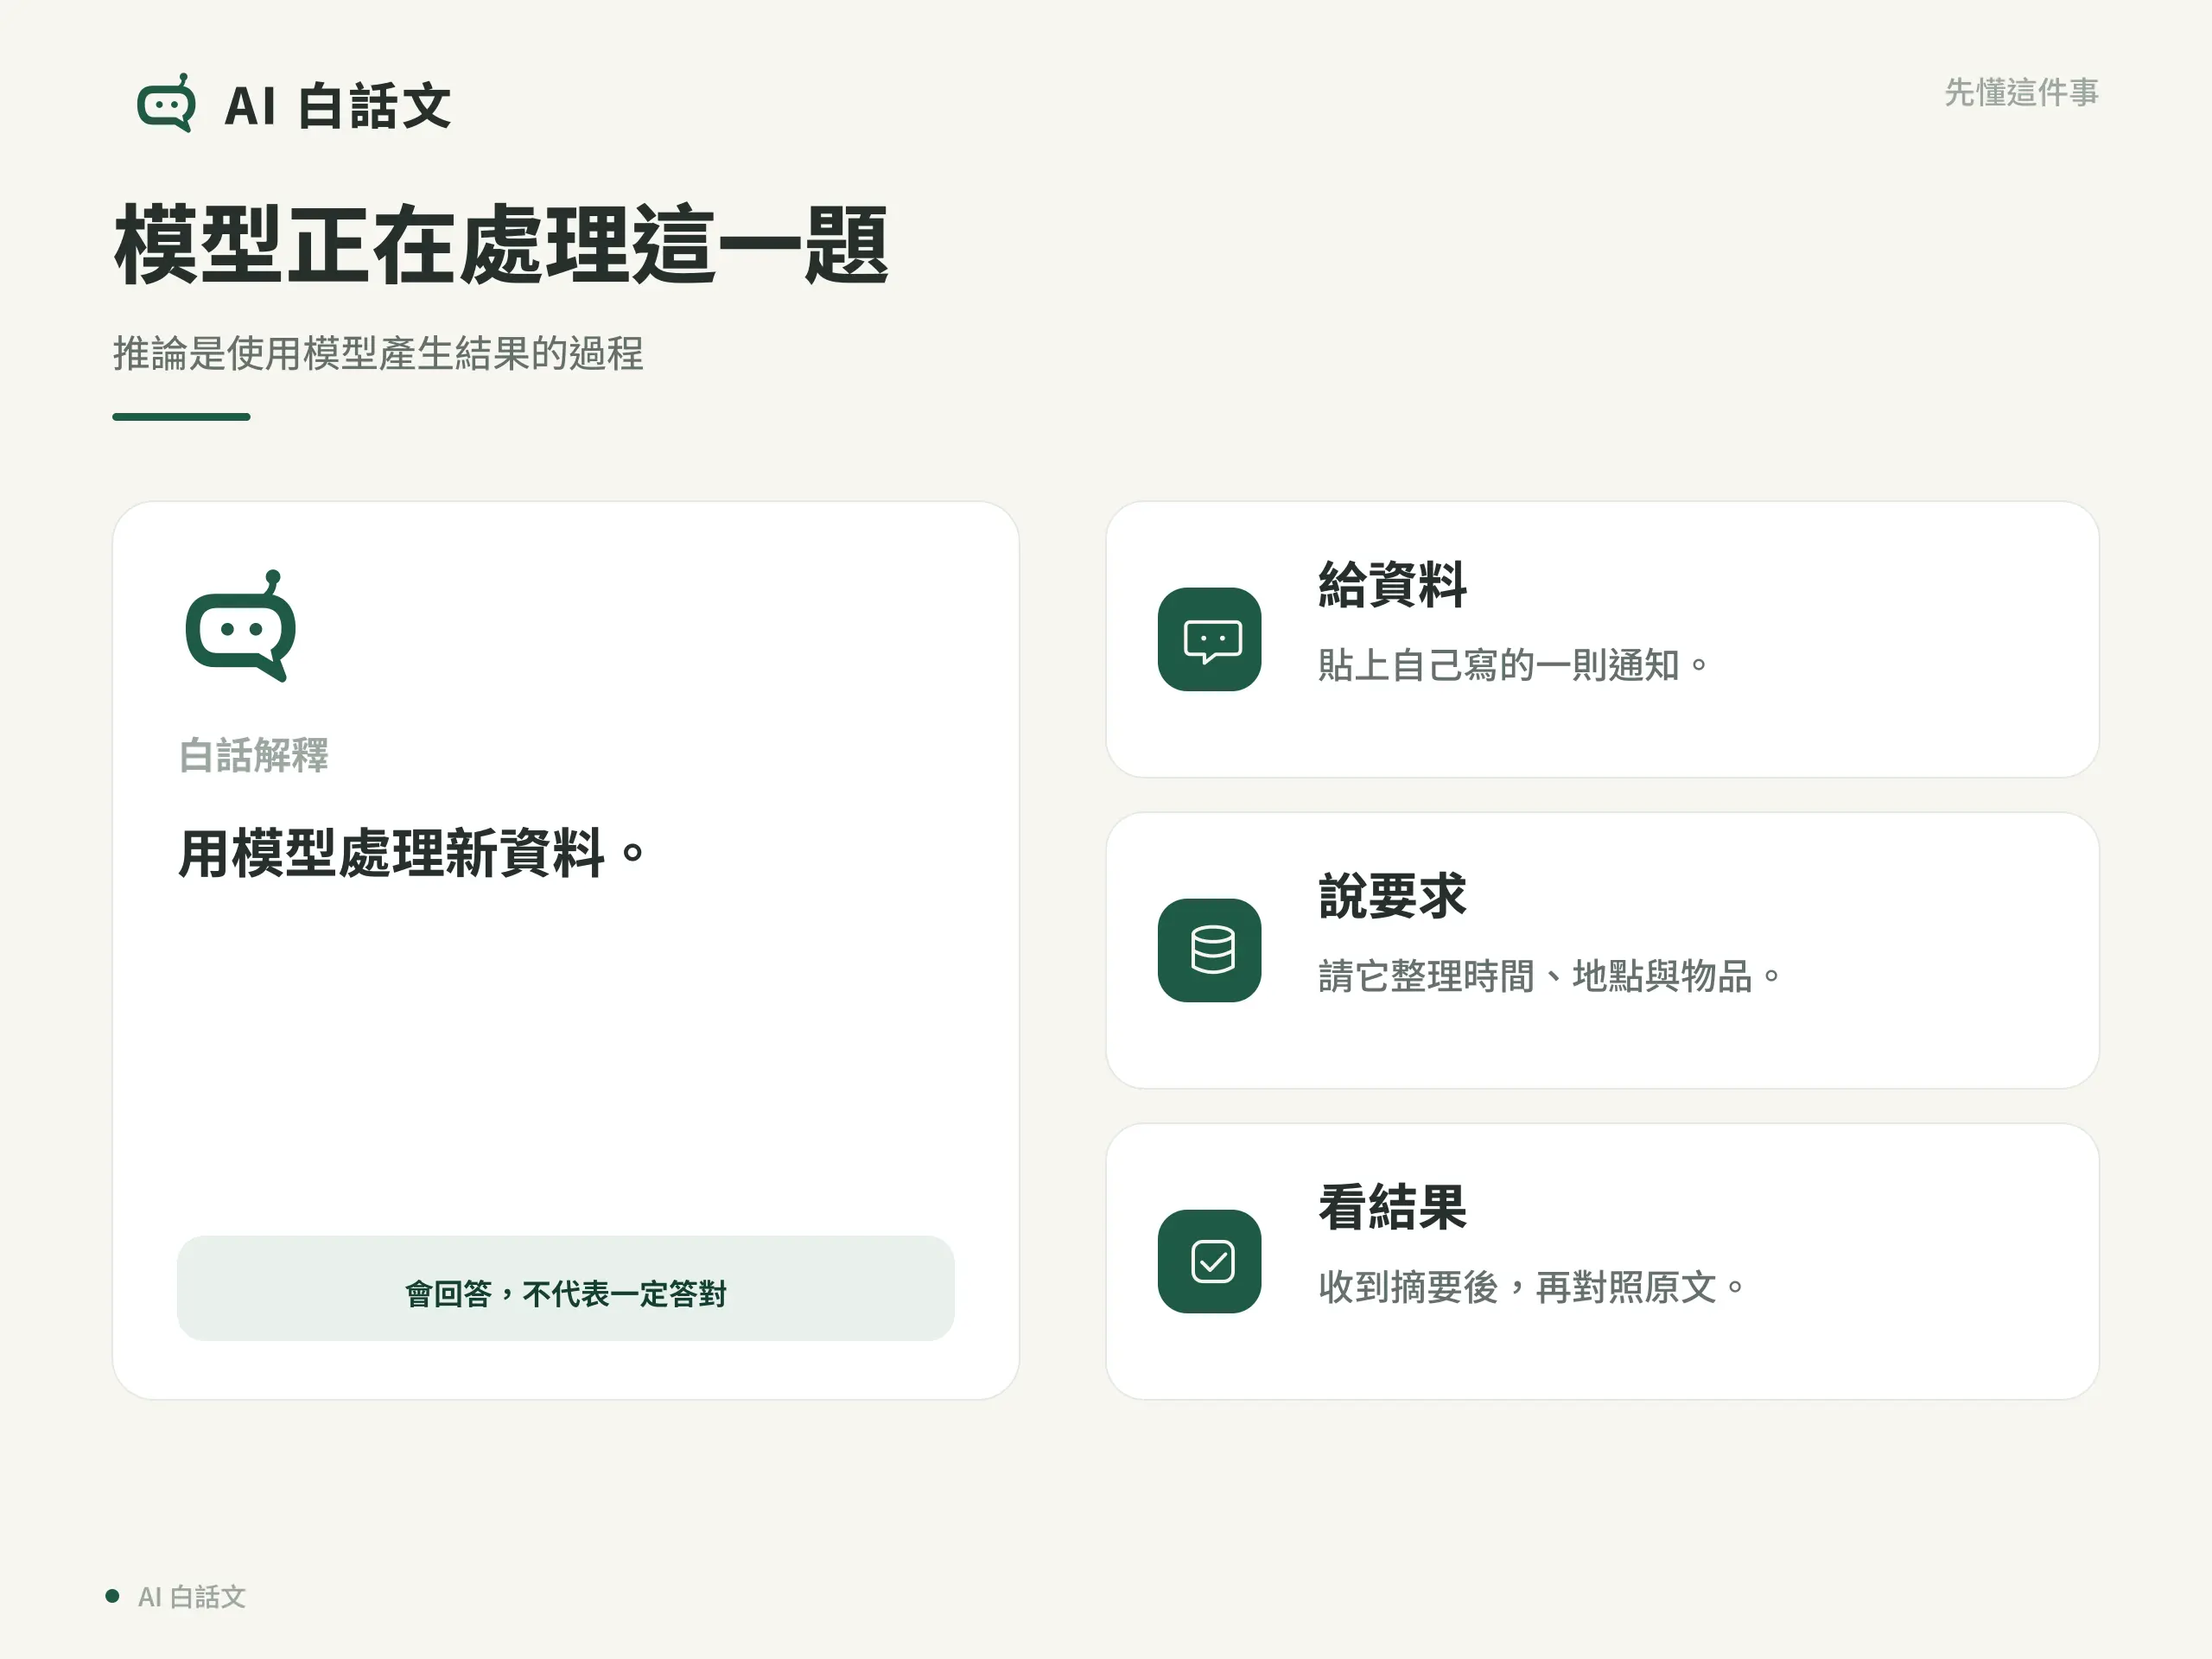
AI 推論(Inference)就是把新資料交給已經訓練好的模型,讓它產生回答、分類或預測。你貼上一段通知請 AI 摘要,或上傳照片請它辨認內容,都在使用模型做推論。
「推論」這個名稱聽起來很難,其實可以先理解成模型正在處理你眼前的這一題。它和重新訓練模型不同,也不表示答案一定正確。
AI 推論是什麼?先分清學習與使用
模型是 AI 用來處理資料的核心。訓練時,系統利用許多資料調整模型內部的數值,這些數值稱為參數;推論時,通常使用已調整好的參數處理新問題。
可以用練習與作答來比喻:訓練像長期練習,推論像拿已學到的方法處理新題目。但 AI 並不是人,這個比喻只是幫你分清兩個階段。
Google 的詞彙表也把文字模型的推論說明為:使用訓練好的模型,依輸入的提示產生回覆。
完整例子:把通知整理成一句話
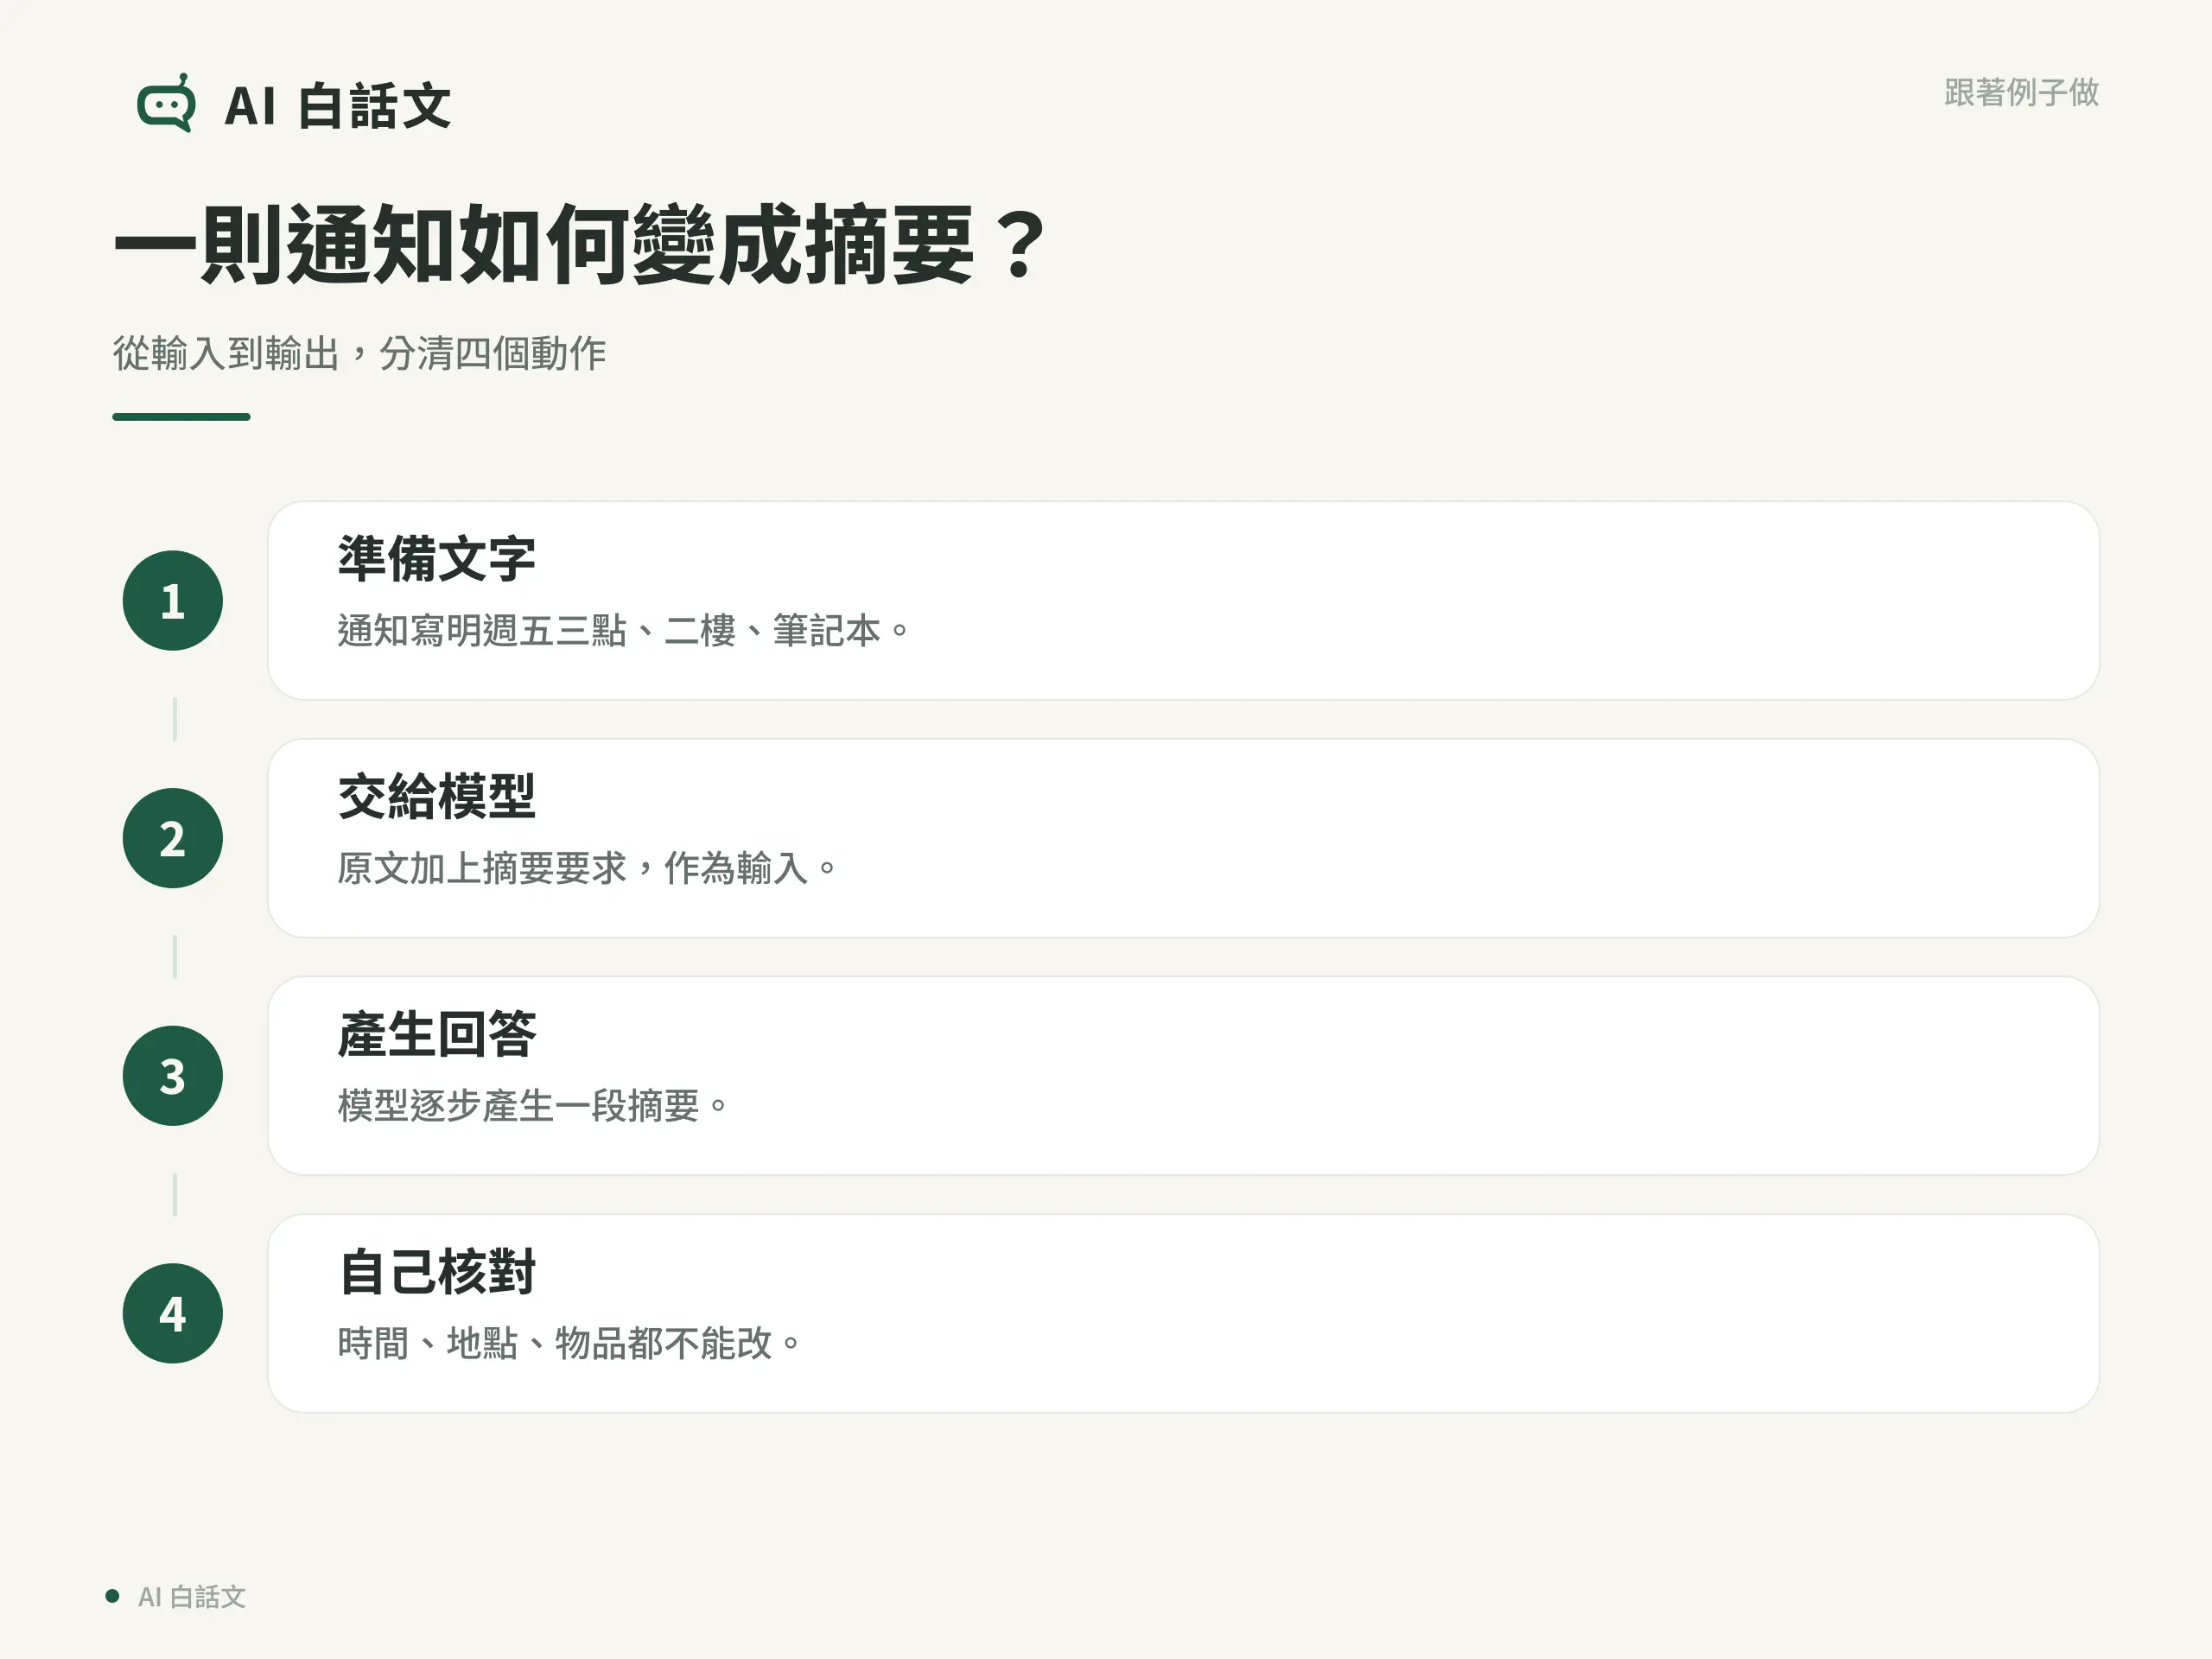
先準備這段自寫的虛構通知:「週五下午三點在二樓教室開讀書會,請帶筆記本。不必事先報名。」你可以貼上原文,再輸入:
請用一句話整理時間、地點與要帶的物品,只使用通知寫出的資訊。
符合要求的摘要是:「讀書會在週五下午三點於二樓教室舉行,請帶筆記本。」原文和要求是輸入,AI 產生的這句摘要是輸出,中間由模型處理的過程就是推論。
這是教學示例,不是特定工具的實測。自己核對三件事:時間沒改、地點沒改、沒有多出原文未提到的物品。
文字模型怎麼逐步產生答案?
以常見的文字生成模型為例,系統會先把文字切成較小的單位,稱為 Token。它可能是一個字、字的一部分或標點,不能直接當成中文字數。
模型根據輸入與前面已產生的文字,逐步選出後續的 Token,直到回答完成或達到限制。這能幫你理解為什麼答案常一段段出現;不同產品的畫面與內部做法仍可能不同。
本篇不需要自己計算 Token。若要理解長度與費用標示,可再讀Token 的白話介紹。
我貼了資料,模型就立刻學會了嗎?
AI 能在這次對話引用你貼的通知,不代表它當下已用通知重新訓練、永久改變模型參數。它通常只是把這段文字當成本次回答的參考資料。
至於平台是否保存對話,或日後用於改善模型,要看該服務的政策、方案與設定。這是另一個問題,不能因為「只是推論」就把個資或機密放心貼上去。
先用自己編的短文練習;真實文件可參考AI 隱私保護的上傳前檢查。
為什麼速度、答案與費用會不同?
問題長短、答案長度、模型、服務忙碌程度與使用的設備,都可能影響等待時間。較慢不一定代表比較仔細,較快也不保證更正確。
同一題有時會出現不同措辭,可能與模型選擇後續文字的方式、對話前文或設定有關。先看重要資訊是否一致,不必要求每次逐字相同。
費用可能按訂閱方案、用量或輸入輸出長度計算;沒有跨所有服務通用的「問一題多少錢」。使用前看自己工具的當前標示即可。
推論和推理是同一件事嗎?
本篇把 Inference 稱為推論,把 Reasoning 稱為推理。推論描述「使用模型產生結果」;推理描述「把條件連起來得出判斷」。
請 AI 把通知改成一句話會發生推論;請它比較三人的空檔、找出能開會的時段,還需要處理多項條件。中文資料有時會混用翻譯,看到不同說法時,可以確認英文原詞與上下文。
總結
把推論想成模型正在處理新輸入,就容易懂了。先用一段短通知試做摘要,對照原文檢查結果;別把會回答、回答得快,或記得本次對話,當成答案正確或永久學會的保證。
參考資料
重點整理
每問 AI 一題,都會發生推論嗎?
只要是模型接收新輸入並產生結果,就涉及推論。一個產品操作可能包含多次模型處理,計費也不一定按問題次數。
AI 推論一定需要網路嗎?
不一定。若模型和必要程式已在自己的設備上,部分工作可以離線完成;使用雲端 AI 服務通常需要連線。
AI 記得我剛貼的內容,就是重新訓練了嗎?
不一定。它通常是在本次對話中使用你提供的資訊,不等於模型參數已更新;對話是否另被保存或用於日後訓練,要看平台政策與設定。