內容目錄
顯示
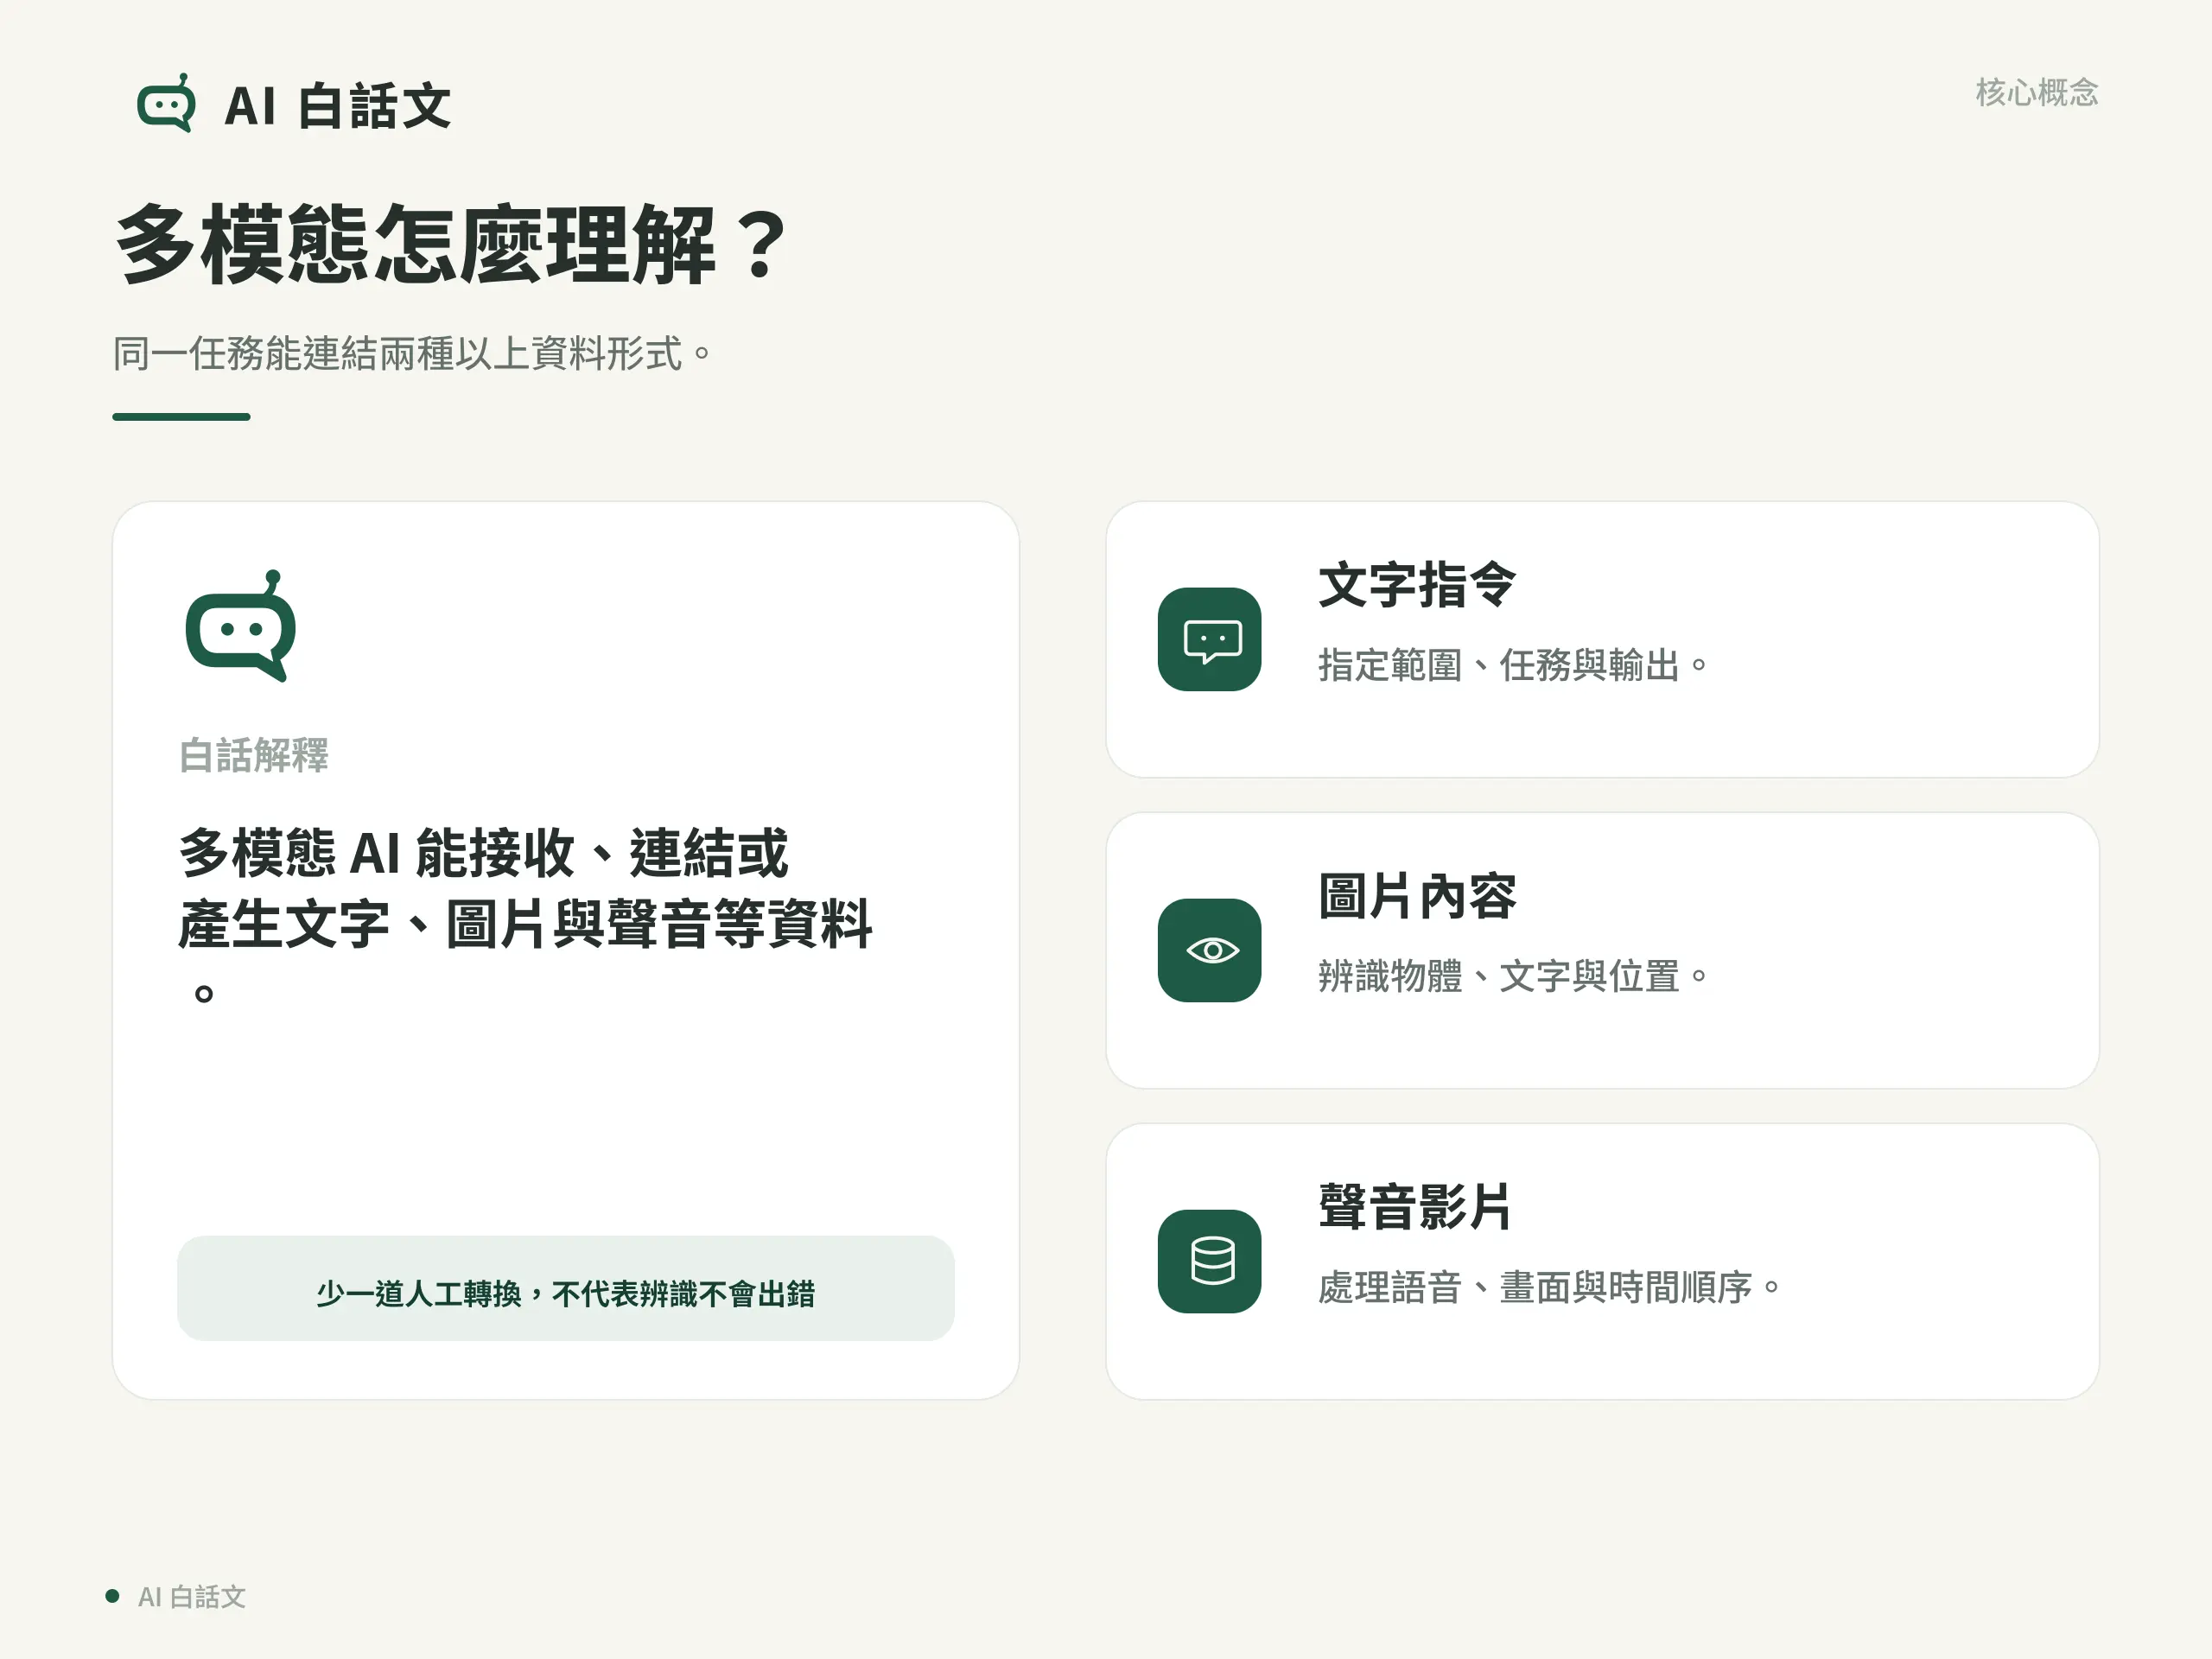
多模態 AI 是能在同一個系統或任務中處理兩種以上資料形式的 AI,例如同時接收文字與圖片,或把錄音轉成文字後再整理內容。這裡的「模態」就是文字、圖片、聲音、影片等資料形式。
多模態功能讓人不必先把所有內容手動打成文字,但少一道轉換不代表沒有錯誤。照片品質、遮擋、口音、小字與圖表結構,都可能影響 AI 的辨識結果,也會帶來隱私與著作權問題。
多模態 AI 是什麼?
多模態 AI(Multimodal AI)的定義:多模態 AI 是能在同一個系統或任務中接收、連結或產生兩種以上資料形式的 AI。這裡的「模態」就是資料形式,例如文字、圖片、聲音與影片。
例如你拍下冰箱裡的食材,問「這些材料可以做什麼早餐?」這個任務同時包含圖片和文字。AI 要先從照片找出可能的食材,再根據文字問題組織建議。
但它不是像人一樣真正看到、聞到和嚐到食物。它是把影像轉成可計算的資訊,再依學到的規律辨識與回答。因此,光線、角度、遮擋和照片品質都可能影響結果。
多模態 AI 跟文字 AI 差在哪?
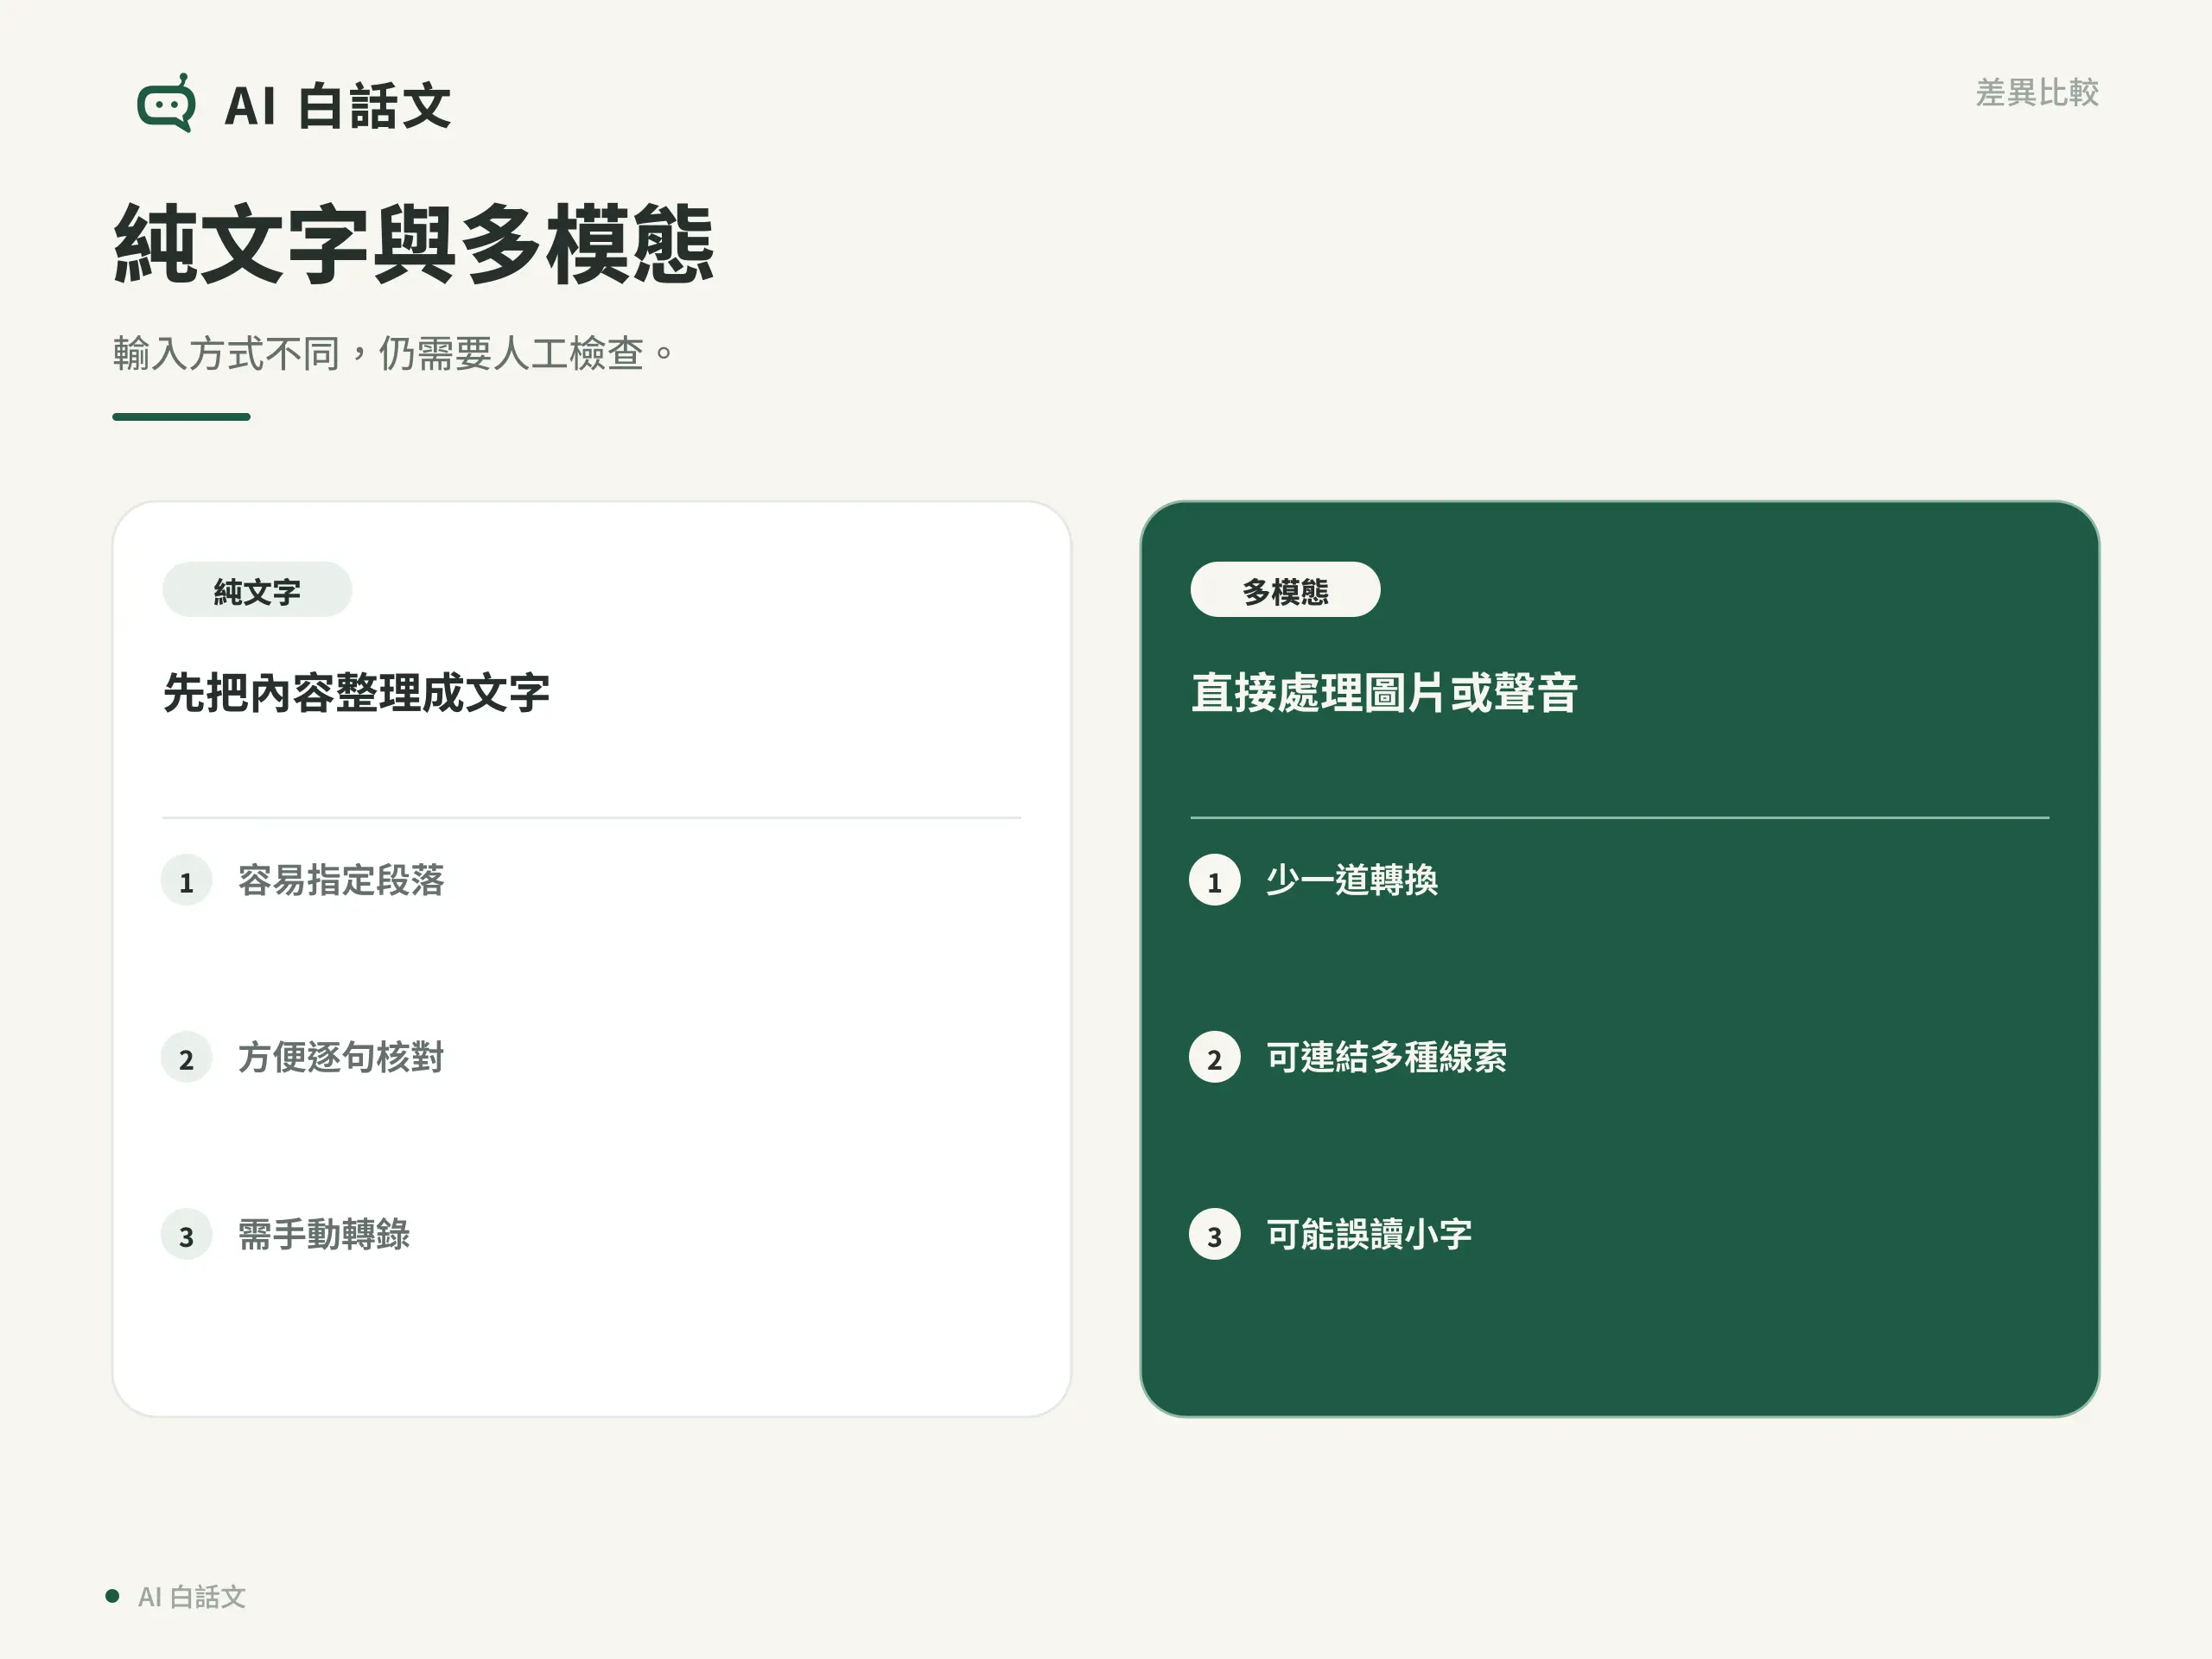
| 任務 | 只用文字 | 多模態做法 |
|---|---|---|
| 解釋題目 | 手動把題目打出來 | 上傳題目照片,再指定要解釋哪一步 |
| 整理會議 | 先取得逐字稿 | 直接處理錄音或影片,再整理重點 |
| 分析圖表 | 描述圖表內容 | 上傳圖表,要求讀取標題、座標與數值 |
| 檢查設計 | 用文字說明版面 | 上傳畫面,詢問層級、可讀性與問題 |
這些是多模態任務的例子,不代表每個聊天產品都支援全部格式。使用前先確認你的工具能否讀取這種圖片、錄音或影片。
多模態的優點是少一道人工轉換,但少一道轉換不等於沒有錯誤。AI 可能看錯小字、把圖例顏色配錯、漏聽人名,或只看畫面就猜測沒有出現的情況。
AI 如何處理圖片、聲音與影片?
對新手而言,不需要先學數學。你只要知道,AI 會把不同資料轉成它能比較和計算的表示,再把相關資訊連在一起。
圖片可以包含物體、文字、位置和顏色;聲音可以包含語音、音量、節奏和環境聲;影片則同時有連續畫面、聲音和時間順序。資料越複雜,遺漏和誤判的機會也越多。
因此,問法要配合資料形式。分析照片時要說明想看哪個區域;整理錄音時要說明要不要區分講者;分析影片時要指定時間範圍與任務,而不是只說「幫我看這個」。
五個新手最實用的情境
1. 看圖解題,但只要提示
可以上傳題目後說:「請先辨識題目文字,再告訴我第一步要用哪個概念,不要直接給答案。」這能把 AI 當家教,而不是代寫工具。
2. 讀取表格或收據
請 AI 把照片中的品項、日期和金額整理成表格,再逐列對照原圖。模糊字、手寫字和小數點特別容易出錯。
3. 整理錄音
先轉成逐字稿,再要求區分「已決定、待確認、負責人、期限」。重要姓名與數字仍要回放原音。
4. 解釋圖表
要求 AI 先列出圖表標題、資料期間、單位和來源,再做解讀。這能減少它跳過基本資訊就直接講故事。
5. 檢查畫面
上傳簡報或網頁截圖,指定「只檢查字級、對比和閱讀順序」,比要求「幫我改好看」更容易得到具體建議。
多模態提問怎麼寫?
提示詞就是交給 AI 的指令與背景。可以使用「資料是什麼+要看哪裡+要完成什麼+怎麼輸出+不確定時怎麼辦」的骨架:
這是一張學校午餐菜單照片。請先逐行讀出星期三的菜色,再分成主食、主菜、配菜和湯。看不清楚的文字請標示「無法辨識」,不要自行補字。最後用表格輸出。
假設照片中的星期三菜單清楚寫著「白飯、滷雞腿、炒高麗菜、玉米湯」,可核對的結果就是:主食白飯、主菜滷雞腿、配菜炒高麗菜、湯品玉米湯。這是示範用的菜單文字,不是實際圖片辨識紀錄;若照片上的主菜糊掉,正確做法是留下「無法辨識」,而非照常見菜色猜答案。
這段指令比「幫我整理這張圖」多了範圍、分類規則和錯誤處理,因此更容易檢查。
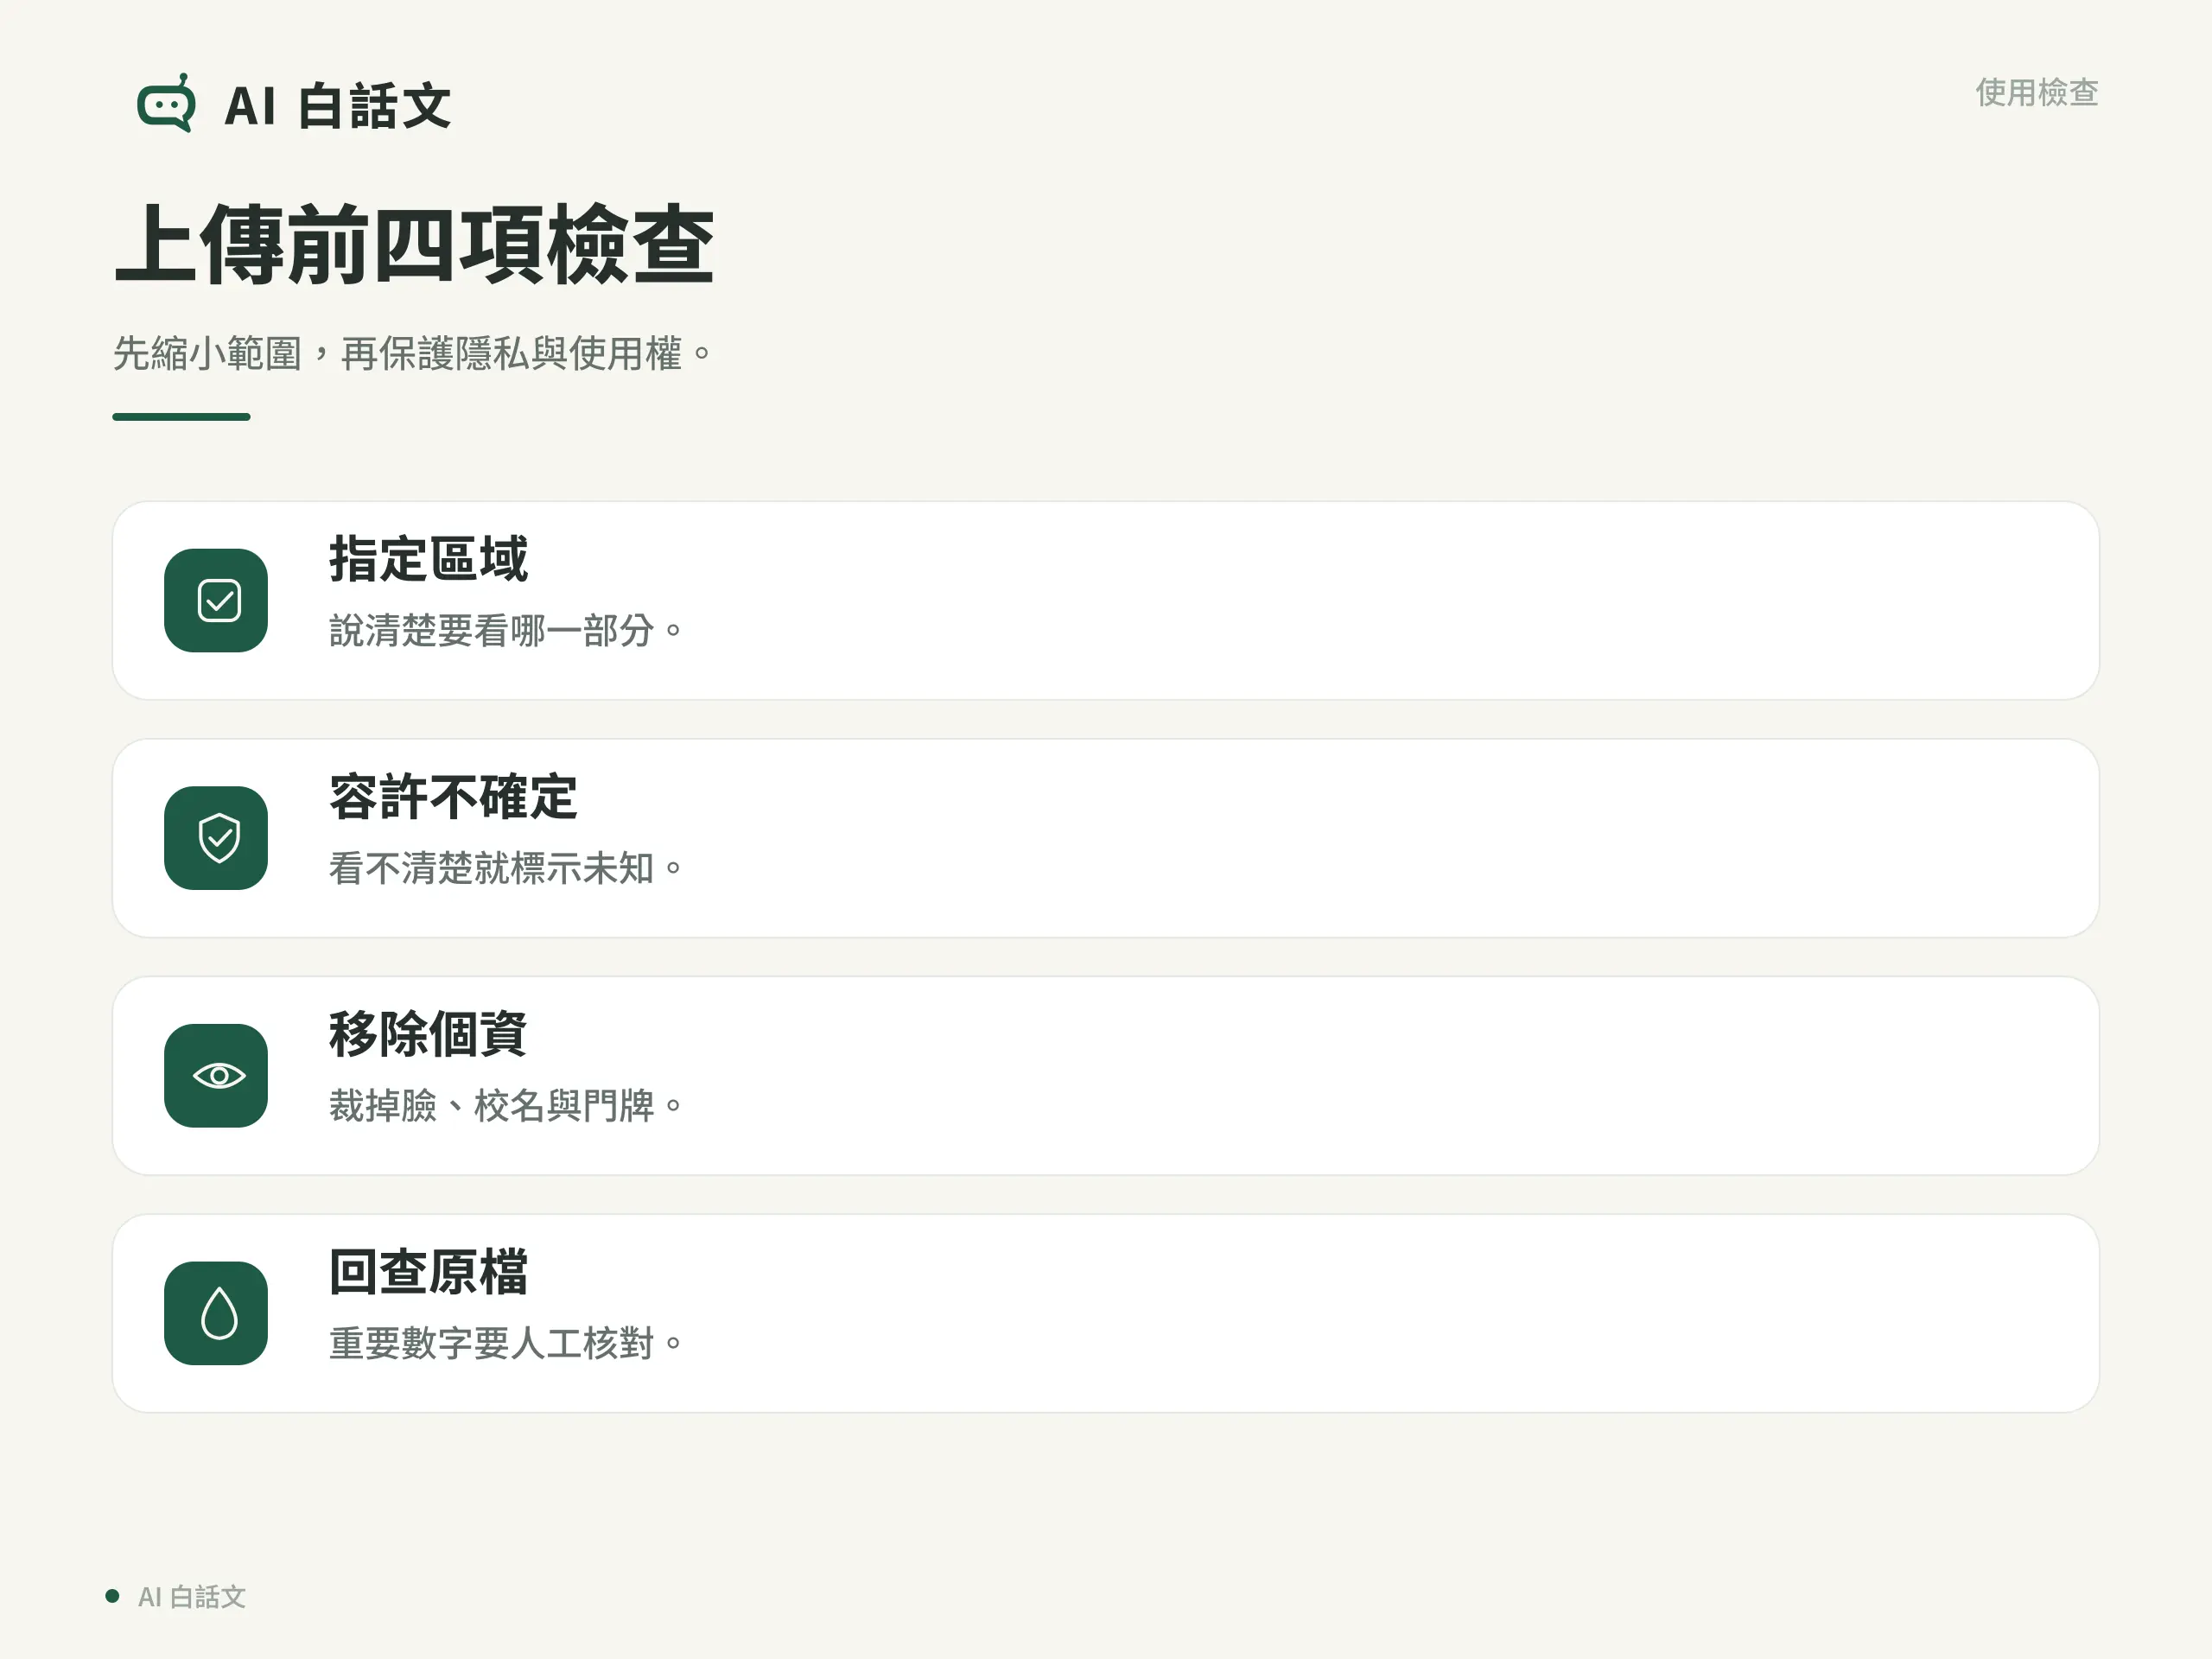
三種不能忽略的風險
辨識錯誤
AI 可能漏看、誤讀或從畫面做過度推論。醫療影像、身分文件、合約、考試答案與安全監控,不應只靠一般多模態聊天工具判斷。
隱私
照片可能帶出臉孔、制服、校名、門牌、車牌、病歷和地點資訊;錄音可能包含未同意被上傳的他人聲音。上傳前先裁切、遮蔽和刪除不必要資料。
著作權與使用權
上傳前先確認素材的來源與使用條件。付費課本、公司文件或客戶素材,要先確認是否允許交給外部 AI 服務處理;不確定就改用自己的示例。
總結
多模態 AI 讓文字、圖片、聲音與影片能在同一任務中互相配合。它的價值是讓輸入更貼近真實工作,不是讓人工檢查消失。指定資料範圍、說清楚任務、要求標示無法辨識的部分,再保護照片與錄音中的隱私,才是可靠的用法。
參考資料
重點整理
多模態 AI 會真的看懂圖片嗎?
它可以辨識與關聯圖片內容,表現可能很強,但仍是根據資料與模型做判斷。不要把自然的說明誤認為百分之百正確的「親眼看見」。
影片可以整支丟給 AI 嗎?
要看平台支援格式、檔案大小和處理上限。即使能上傳,也建議指定時間範圍和問題,長影片可先分段,重要內容回到原片核對。
上傳照片安全嗎?
沒有跨平台的絕對答案。先檢查照片是否含個資或他人資料,再查看服務的隱私、保留與訓練政策。敏感資料能不上傳就不上傳。