內容目錄
顯示
Token 是語言模型分割與處理文字時使用的小片段,不等於固定的一個字或一個單字。你的問題、貼上的資料、前文與 AI 準備產生的回答,都可能占用 Token。
Token 會影響上下文容量、長文件處理、回答長度、速度與部分平台的費用。不了解 Token,也很容易把「上下文視窗」「對話紀錄」與「跨對話記憶」混成同一件事。
Token 是什麼?
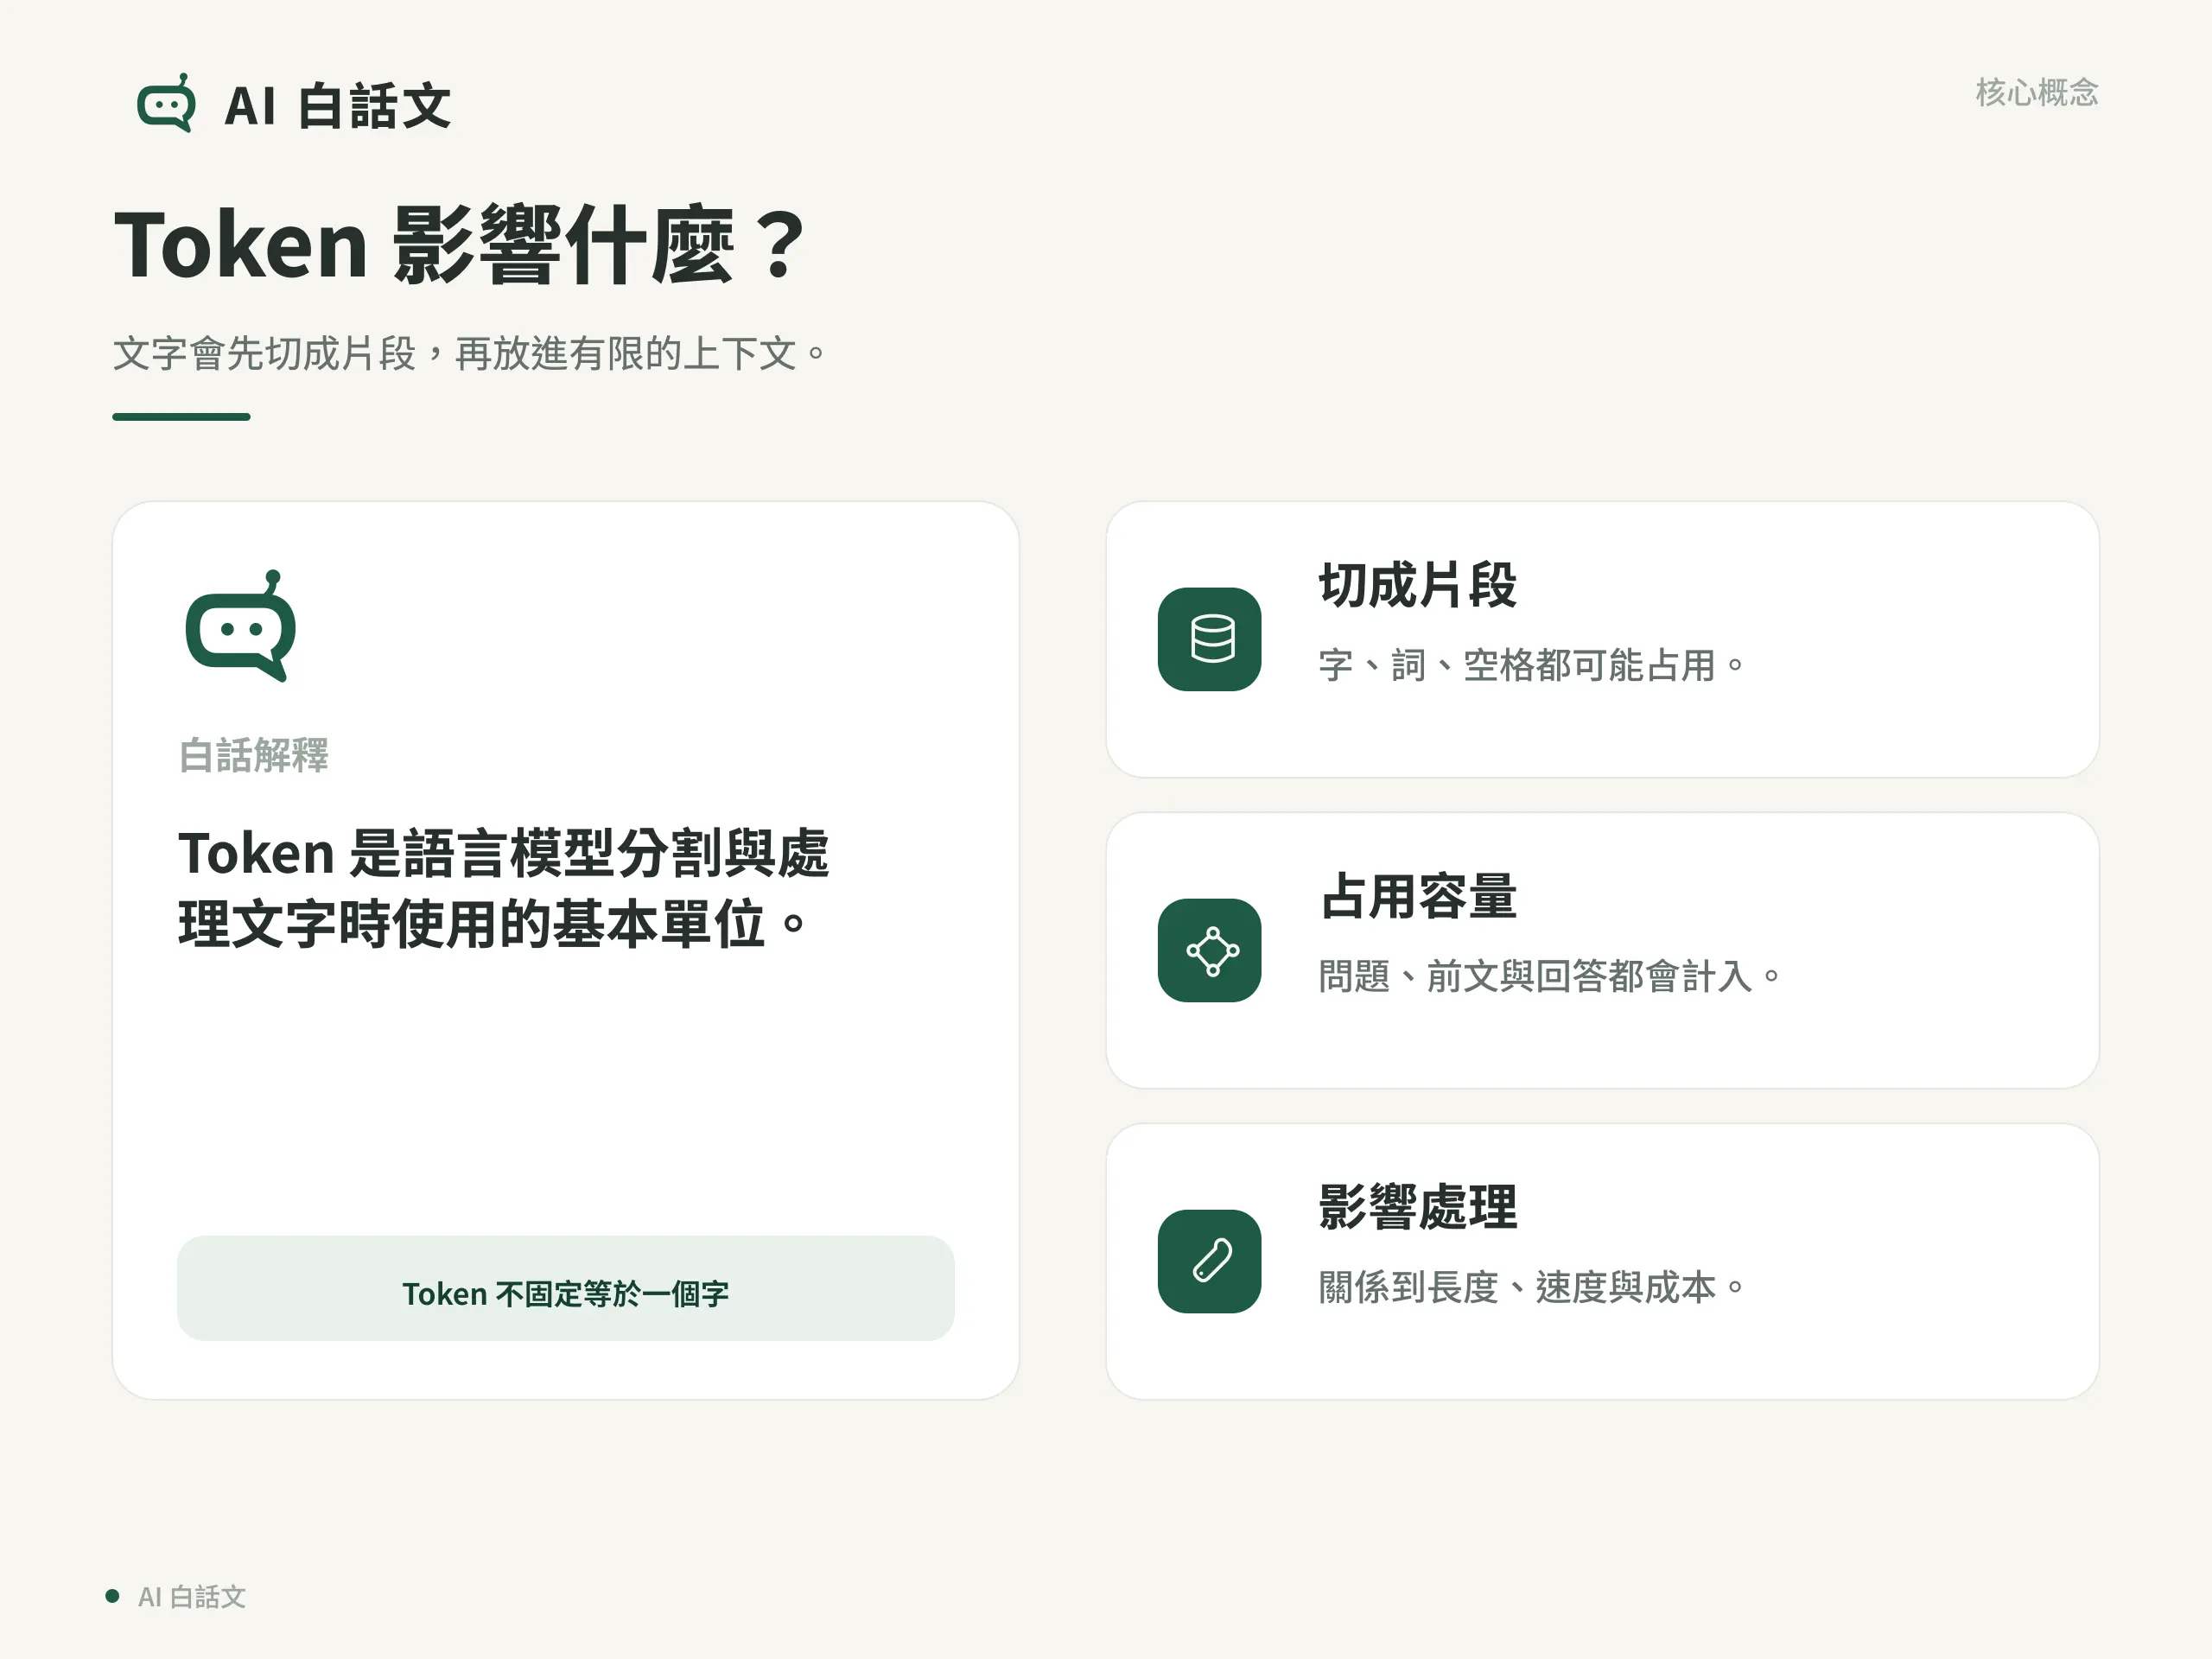
Token 的定義:Token 是語言模型分割與表示文字時使用的基本單位。模型會先把內容切成可計算的片段;片段可能是一個字、詞的一部分、完整詞、空格或標點,實際切法由各模型決定。
延伸來源:OpenAI的說明
例如「人工智慧很好用」在人眼中是七個中文字,但模型不一定剛好切成七個 Token。英文長單字也可能被拆成數個片段。因此,看到網路上的「一個 Token 等於幾個字」只能當粗略估計,不能當所有平台通用公式。
為什麼 AI 不直接算字數?
語言裡有常見字詞、變化形式、不同文字系統和程式符號。把文字切成可重用的小片段,模型比較能處理沒看過的新詞,也不需要替每個完整句子建立獨立項目。
對使用者而言,知道切分細節並不重要。真正重要的是:你放進去的每一段內容都會占空間,包括:
- 這一輪輸入的問題。
- 系統或產品預先放入的指令。
- 對話前面仍被保留的內容。
- 你上傳後被讀入的文件內容。
- 模型準備產生的回答。
上下文視窗是什麼?
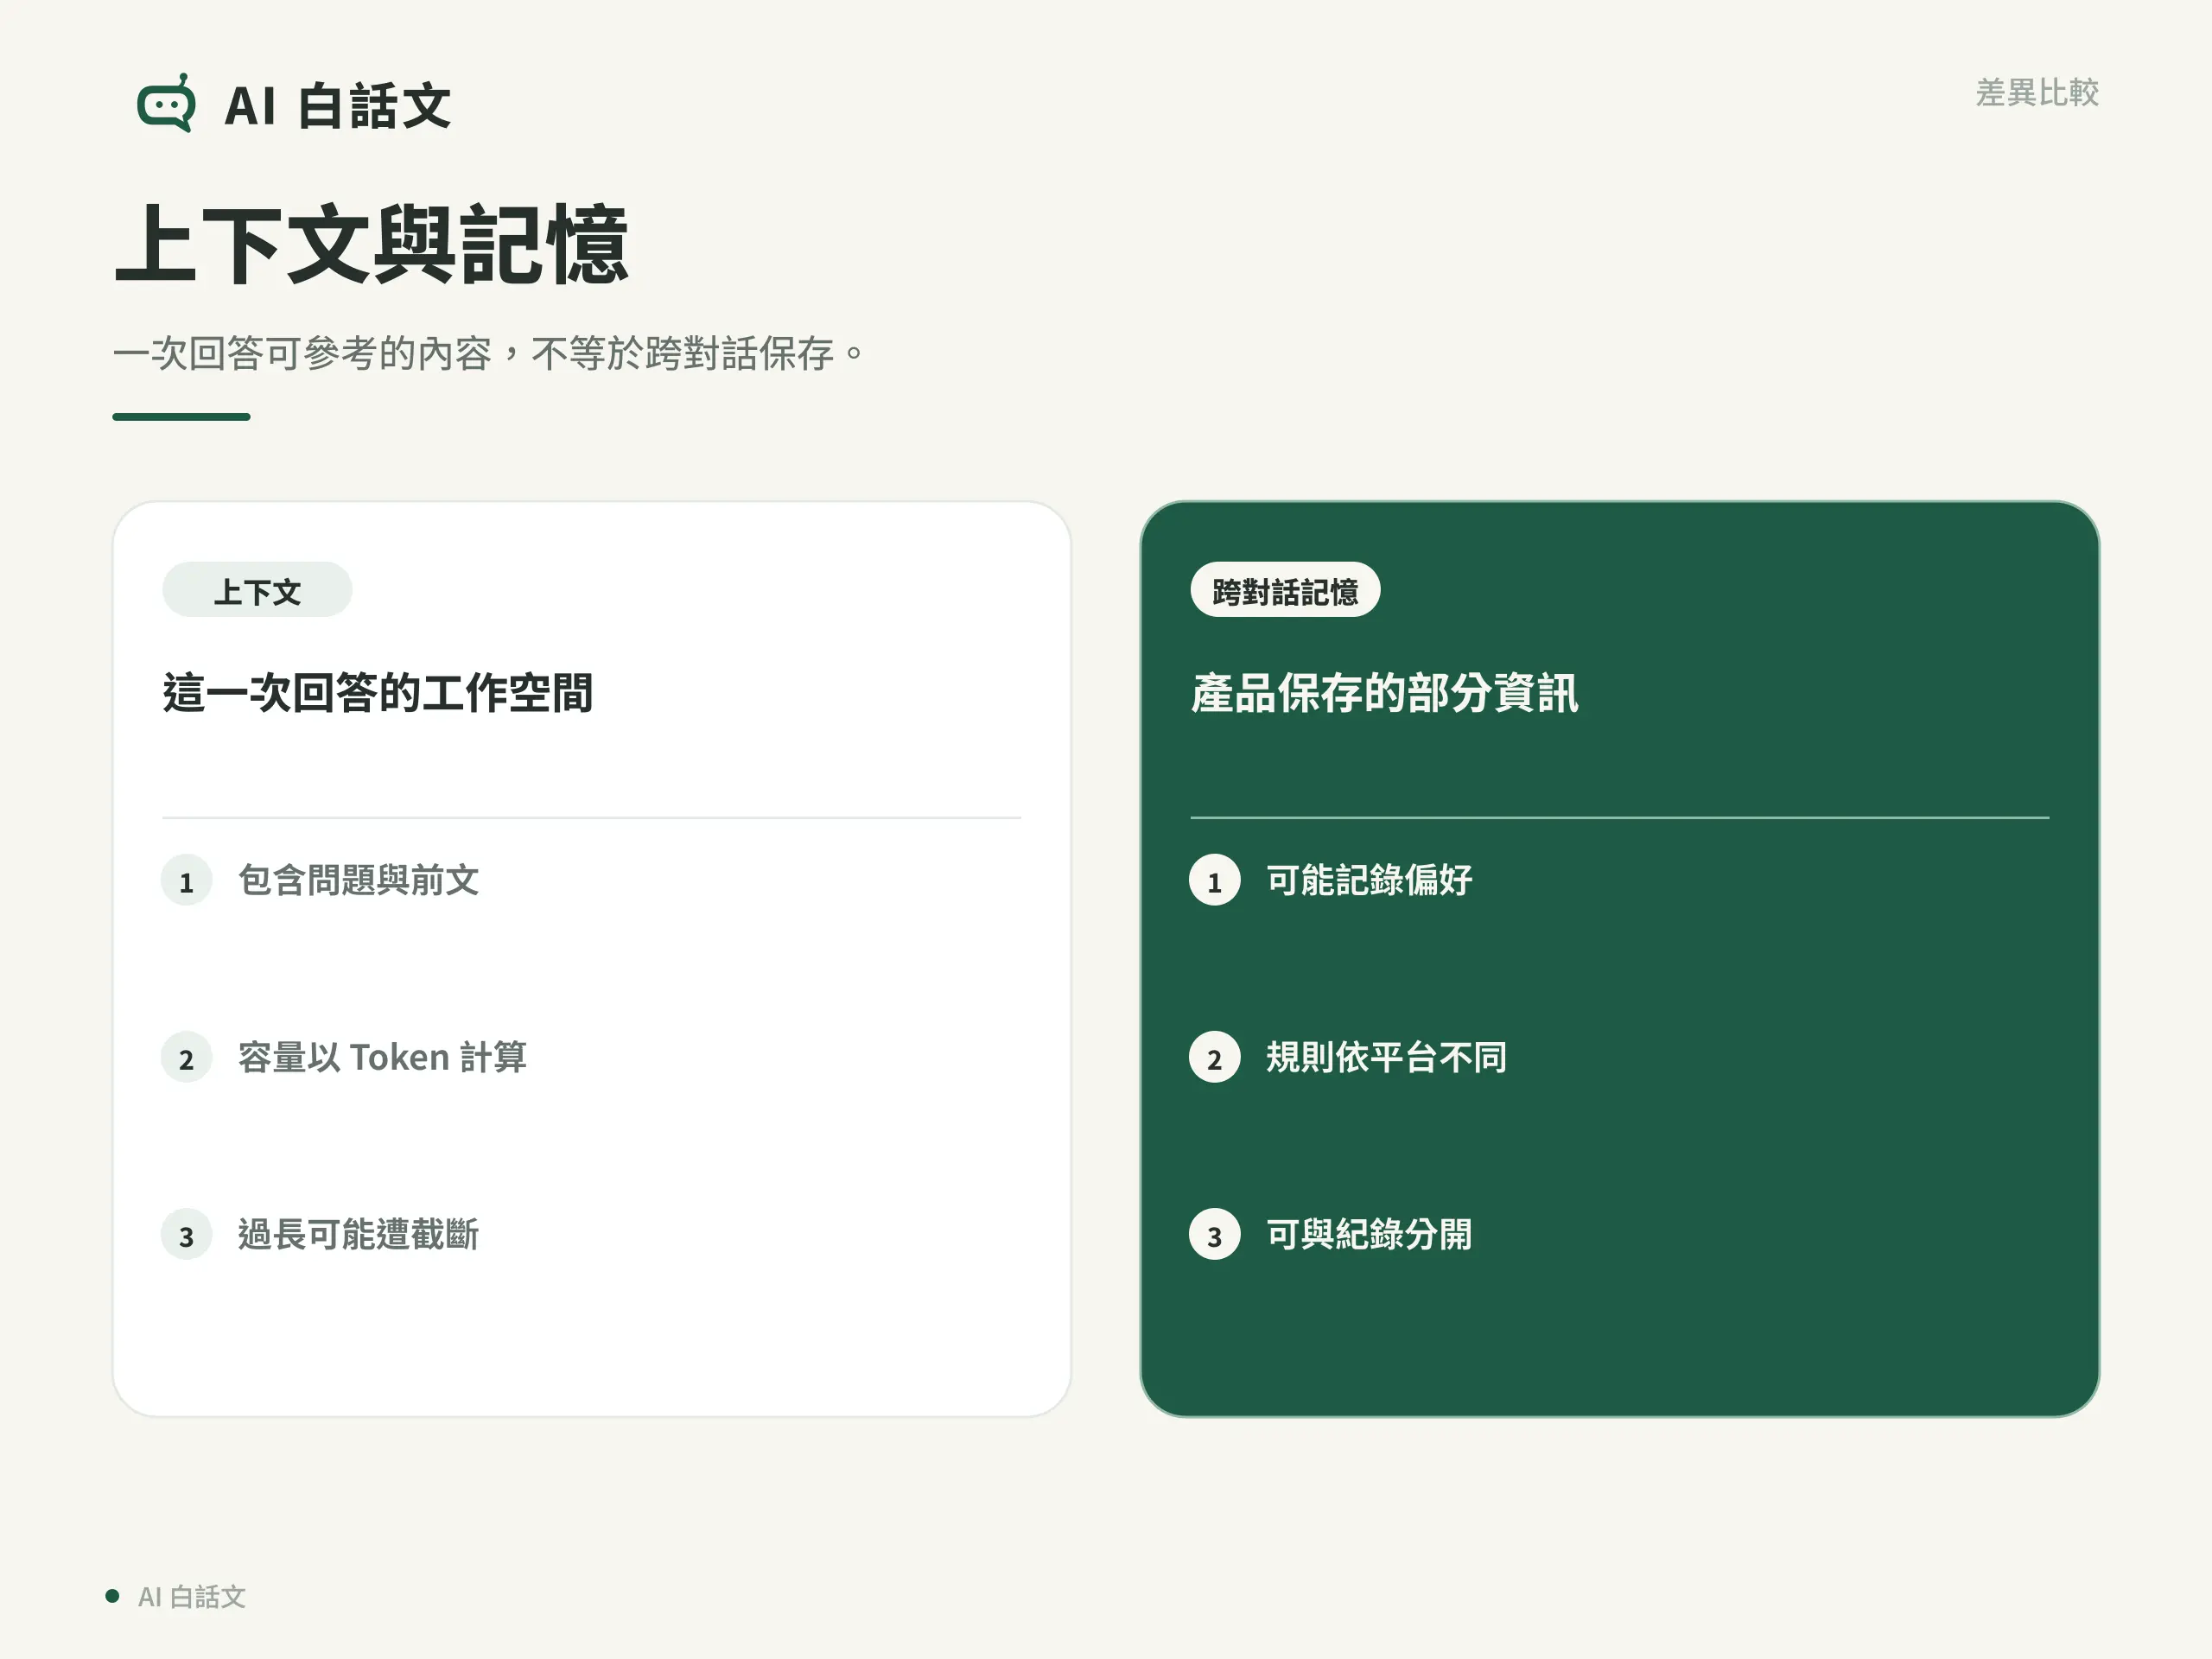
上下文視窗的定義:上下文視窗是模型一次處理問題時可容納的 Token 總容量,通常同時包含指令、對話、文件、工具結果與預留的輸出。若要用例子理解,它像 AI 這一次工作的桌面空間:桌面有限,資料太多就可能放不下。
當內容接近上限,產品可能截掉較早內容、只擷取文件片段、縮短回答,或直接提醒超過限制。不同工具怎麼處理不完全相同。
上下文視窗大,代表一次可以放更多內容,不代表模型一定會正確使用每一段。就像把二十本書全放上桌,不等於讀者能同時精準引用每一頁。內容的組織、相關性與指令仍然重要。
AI 記憶和上下文有什麼不同?
| 概念 | 主要用途 | 常見誤解 |
|---|---|---|
| 上下文 | 這次回答可參考的問題、前文與資料 | 以為視窗越大就一定越準 |
| 跨對話記憶 | 產品在不同對話間保存部分偏好或資訊 | 以為所有聊天內容都會永久記住 |
| 對話紀錄 | 帳號介面中保存過去聊天 | 以為看得到紀錄就等於模型每次都會讀取 |
三者可能由同一產品整合,但功能不同。刪除對話紀錄是否同時刪除記憶,要查看平台當下的設定與說明。
Token 如何影響費用、速度與答案?
API 是讓程式使用 AI 服務的介面。使用 API 時,服務常依輸入和輸出的 Token 數量計費;一般聊天方案也可能用訊息數、用量或其他方式限制。費率會變動,應以供應商官方價格頁為準。
內容越長,通常需要更多處理時間與計算資源。更重要的是,無關資料太多會讓真正重要的線索被淹沒。這不是 Token 越少越好,而是要讓每一段內容都對任務有用。
例如請 AI 從 100 頁報告找出「今年三個主要風險」,比起直接丟文件後只說「幫我看看」,更好的做法是交代年份、風險定義、輸出欄位和引用頁碼。你不是只在省 Token,也是在提高任務清晰度。
請只根據我上傳的 2025 年報,整理三項公司明確提到的營運風險。每項列出風險名稱、一句解釋和原文頁碼;找不到三項就說明不足,不要補造。
收到答案後,逐一打開它列出的頁碼,確認原文確實提到該風險。這段提問只是示範寫法,並非針對某份真實年報的查核結果。
長文件與長對話怎麼處理?
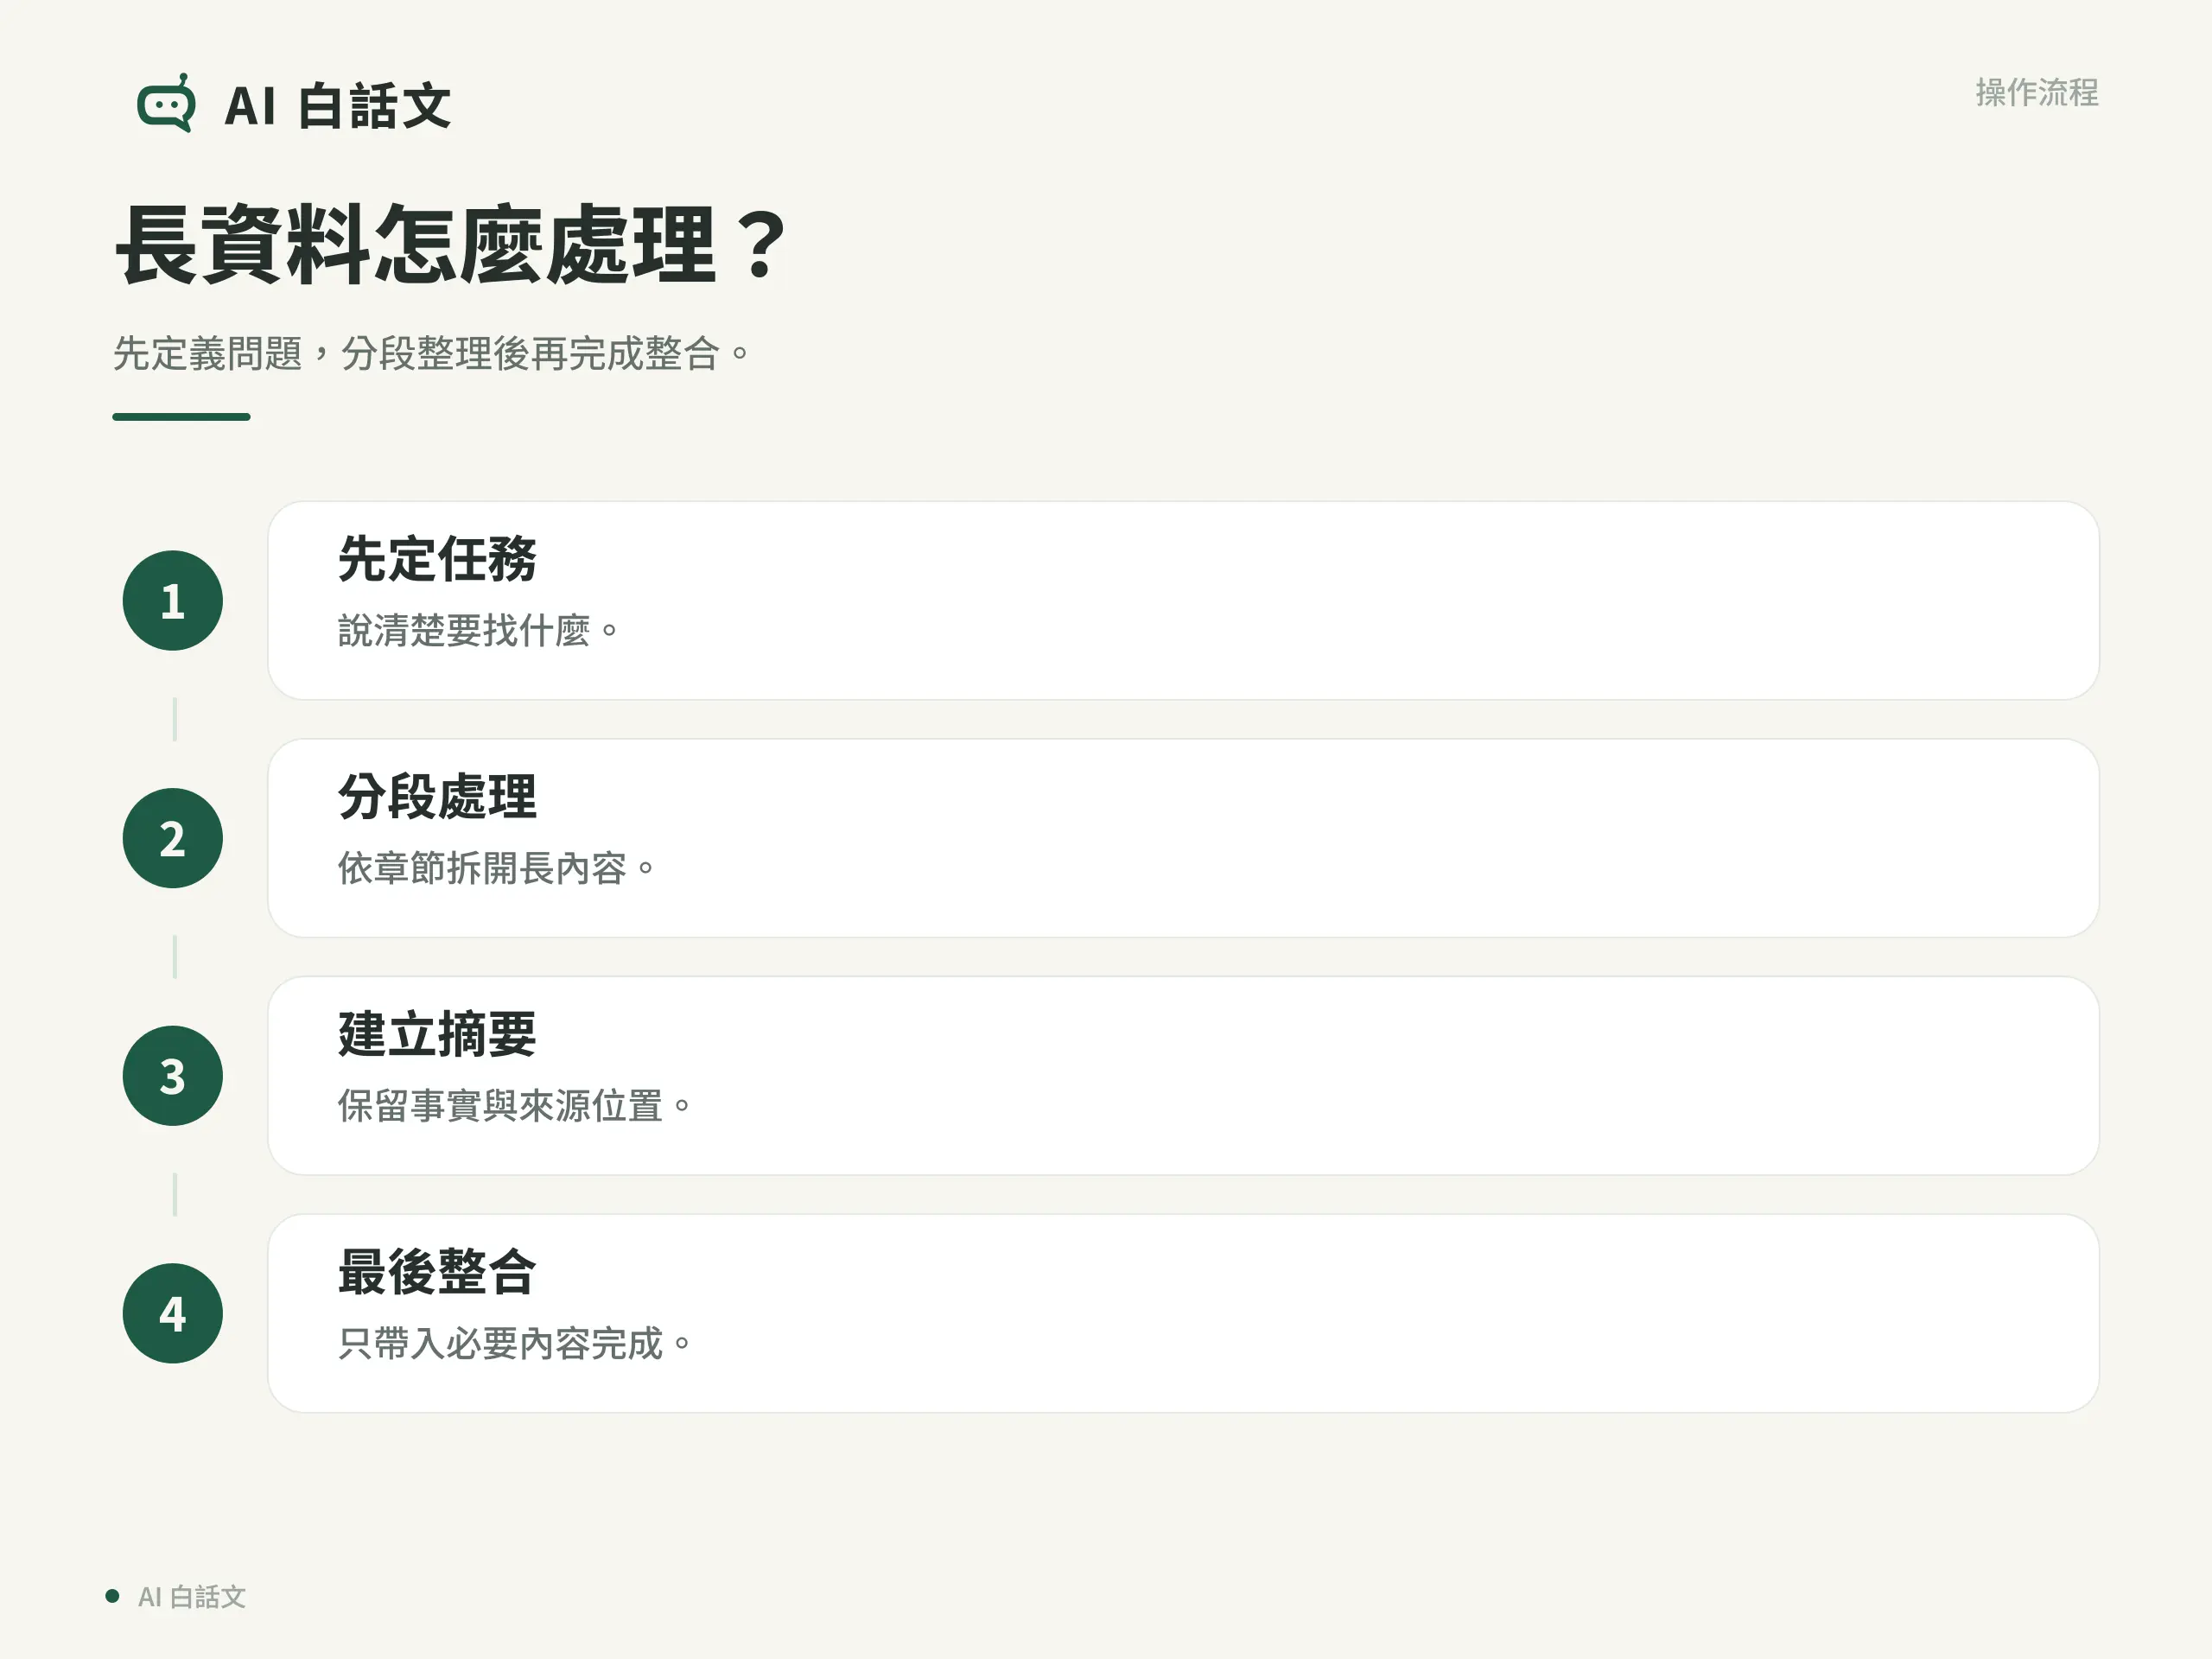
- 先說任務:在上傳資料前,先定義要找什麼、不要做什麼。
- 分段處理:依章節或主題拆開,不用把所有內容一次塞入。
- 建立中間摘要:每完成一段,整理出已確認事實、疑問與來源位置。
- 最後整合:只把必要摘要和關鍵原文帶進最後一輪。
- 抽樣核對:回到原文件檢查數字、引文與頁碼。
長對話若開始答非所問,可以請 AI 先整理「目前目標、已確認條件、尚未完成項目」,確認無誤後開新對話,把整理結果當成新的起點。這通常比一直在混亂對話裡補充更有效。
三個常見錯誤
把上下文上限當成建議容量
能塞進去,不代表應該塞滿。只提供完成任務需要的內容,通常更容易檢查。
只要求「不要忘記」
一句提醒不能擴大實際容量。重要條件應在關鍵步驟重新列出,或整理成重要條件清單。
為了省 Token 刪掉必要背景
省略對象、日期、資料範圍和輸出要求,會讓模型用猜的。重點是刪除無關內容,不是把任務說得含糊。
總結
Token 是模型處理文字的片段,上下文視窗是一次回答可參考內容的範圍,跨對話記憶則是另一項產品功能。處理長資料時,不要只追求塞得多;先定義問題、分段整理、保留來源位置,再用必要內容完成整合,會比把所有東西一次丟給 AI 更可靠。
參考資料
重點整理
一個中文字等於一個 Token 嗎?
不一定。切分方式受模型和語言影響,請勿用固定比例做精準費用估算。需要估算 API 成本時,使用供應商提供的計數工具或實際用量紀錄。
上下文越大就一定越準嗎?
不一定。容量大只表示能參考更多內容;資料若混亂、互相矛盾或與任務無關,答案仍可能變差。
刪除對話等於刪除記憶嗎?
不能一概而論。對話紀錄和記憶功能可能分開管理,請查看使用平台的記憶與資料控制說明。