內容目錄
顯示
LLM 是 Large Language Model 的縮寫,中文常譯為「大型語言模型」。它會根據目前文字與學到的語言規律預測後續內容,因此能處理問答、摘要、翻譯、分類與草稿生成。
ChatGPT、Claude、Gemini 等聊天產品都可能使用 LLM,但聊天介面不等於模型本身。理解 LLM 擅長產生語言、卻不自動保證事實正確,是安全使用這類工具的基礎。
LLM 是什麼?
大型語言模型(Large Language Model,LLM)的定義:LLM 是利用大量資料與計算資源建立的語言模型,會根據目前文字內容預測後續語言片段,因此能處理問答、摘要、翻譯、分類與草稿生成等任務。
延伸來源:Google的說明
「大型」主要描述模型規模與訓練範圍,不代表它像人一樣理解世界,也不保證每個答案都正確。你也可能在介紹中看到「參數」:它是模型在訓練時會調整的內部設定。
你看到的聊天產品是使用介面,LLM 則是背後負責處理語言的模型。就像你用導航 App 規劃路線,App 是你操作的產品,背後還有地圖資料、計算方法與定位服務。兩者有關,但不是同一個東西。
LLM 怎麼產生一句話?
先做一個小遊戲:「今天天氣很好,我們一起去公園__。」你可能猜「散步」「玩球」或「野餐」。因為你看過很多句子,知道哪些詞放在這裡合理。
LLM 也在做類似的預測,只是規模非常大。它把文字拆成較小的片段,根據目前對話,預測下一個片段,再繼續預測下一個。很多片段連起來,就變成完整回答。
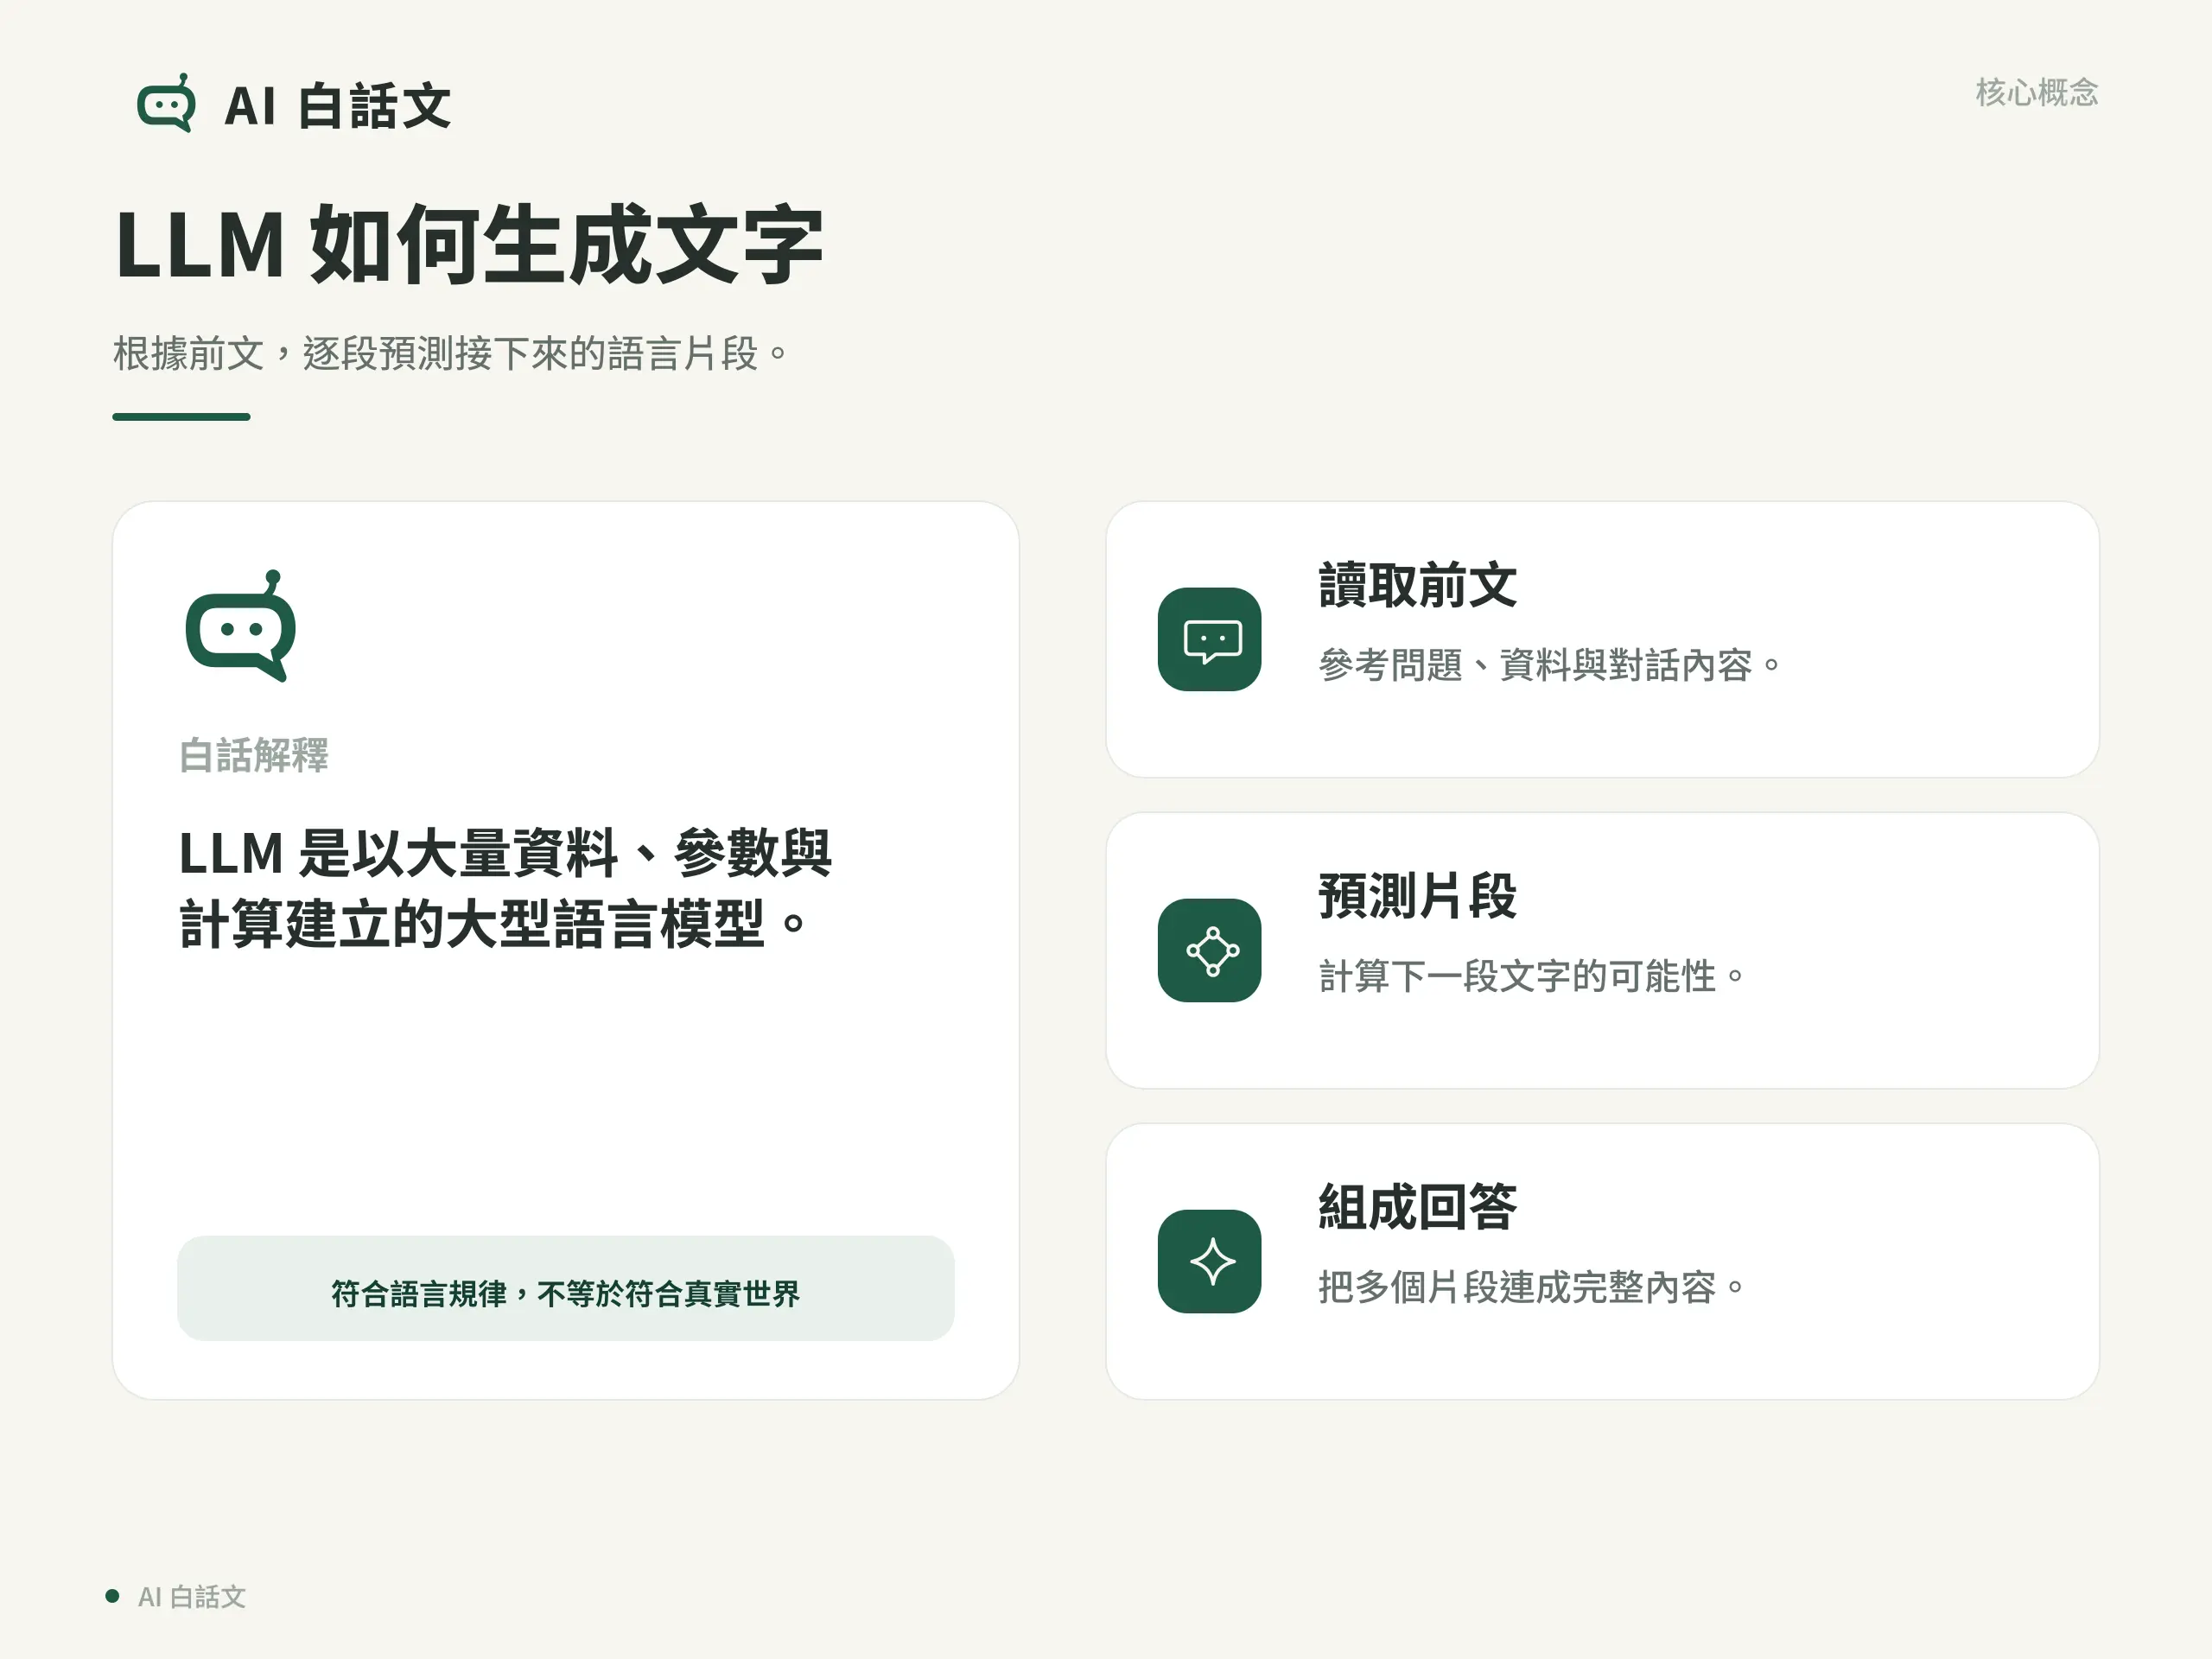
模型不一定每次選完全相同的接法,所以同一問題可能得到不同寫法。只要前文、要求或生成設定改變,答案也會改變。
你不需要先理解複雜的模型架構,就能掌握實用結論:LLM 的核心能力是產生符合語言規律的內容;內容是否符合現實,仍要由資料與查證來保證。
LLM 為什麼看起來什麼都懂?
語言是人類保存知識的重要方式。當模型學到大量文章、說明、對話與程式碼裡的規律,就能在許多主題上組織出像樣的回答。
它也能根據你提供的前文與要求調整表達。例如你要求「用國小生能懂的例子」,它會選擇比較短的句子與生活場景;你要求「整理成給主管看的摘要」,它會改成重點式語氣。
但是,「能產生合理說法」和「真正知道這件事正確」仍是兩回事。LLM 可能:
- 把兩個人物的經歷混在一起。
- 寫出不存在的書名、網址或研究。
- 用過時資料回答今天的價格、法規或職位。
- 因為問題資訊不足,自己補上一個不符合你的假設。
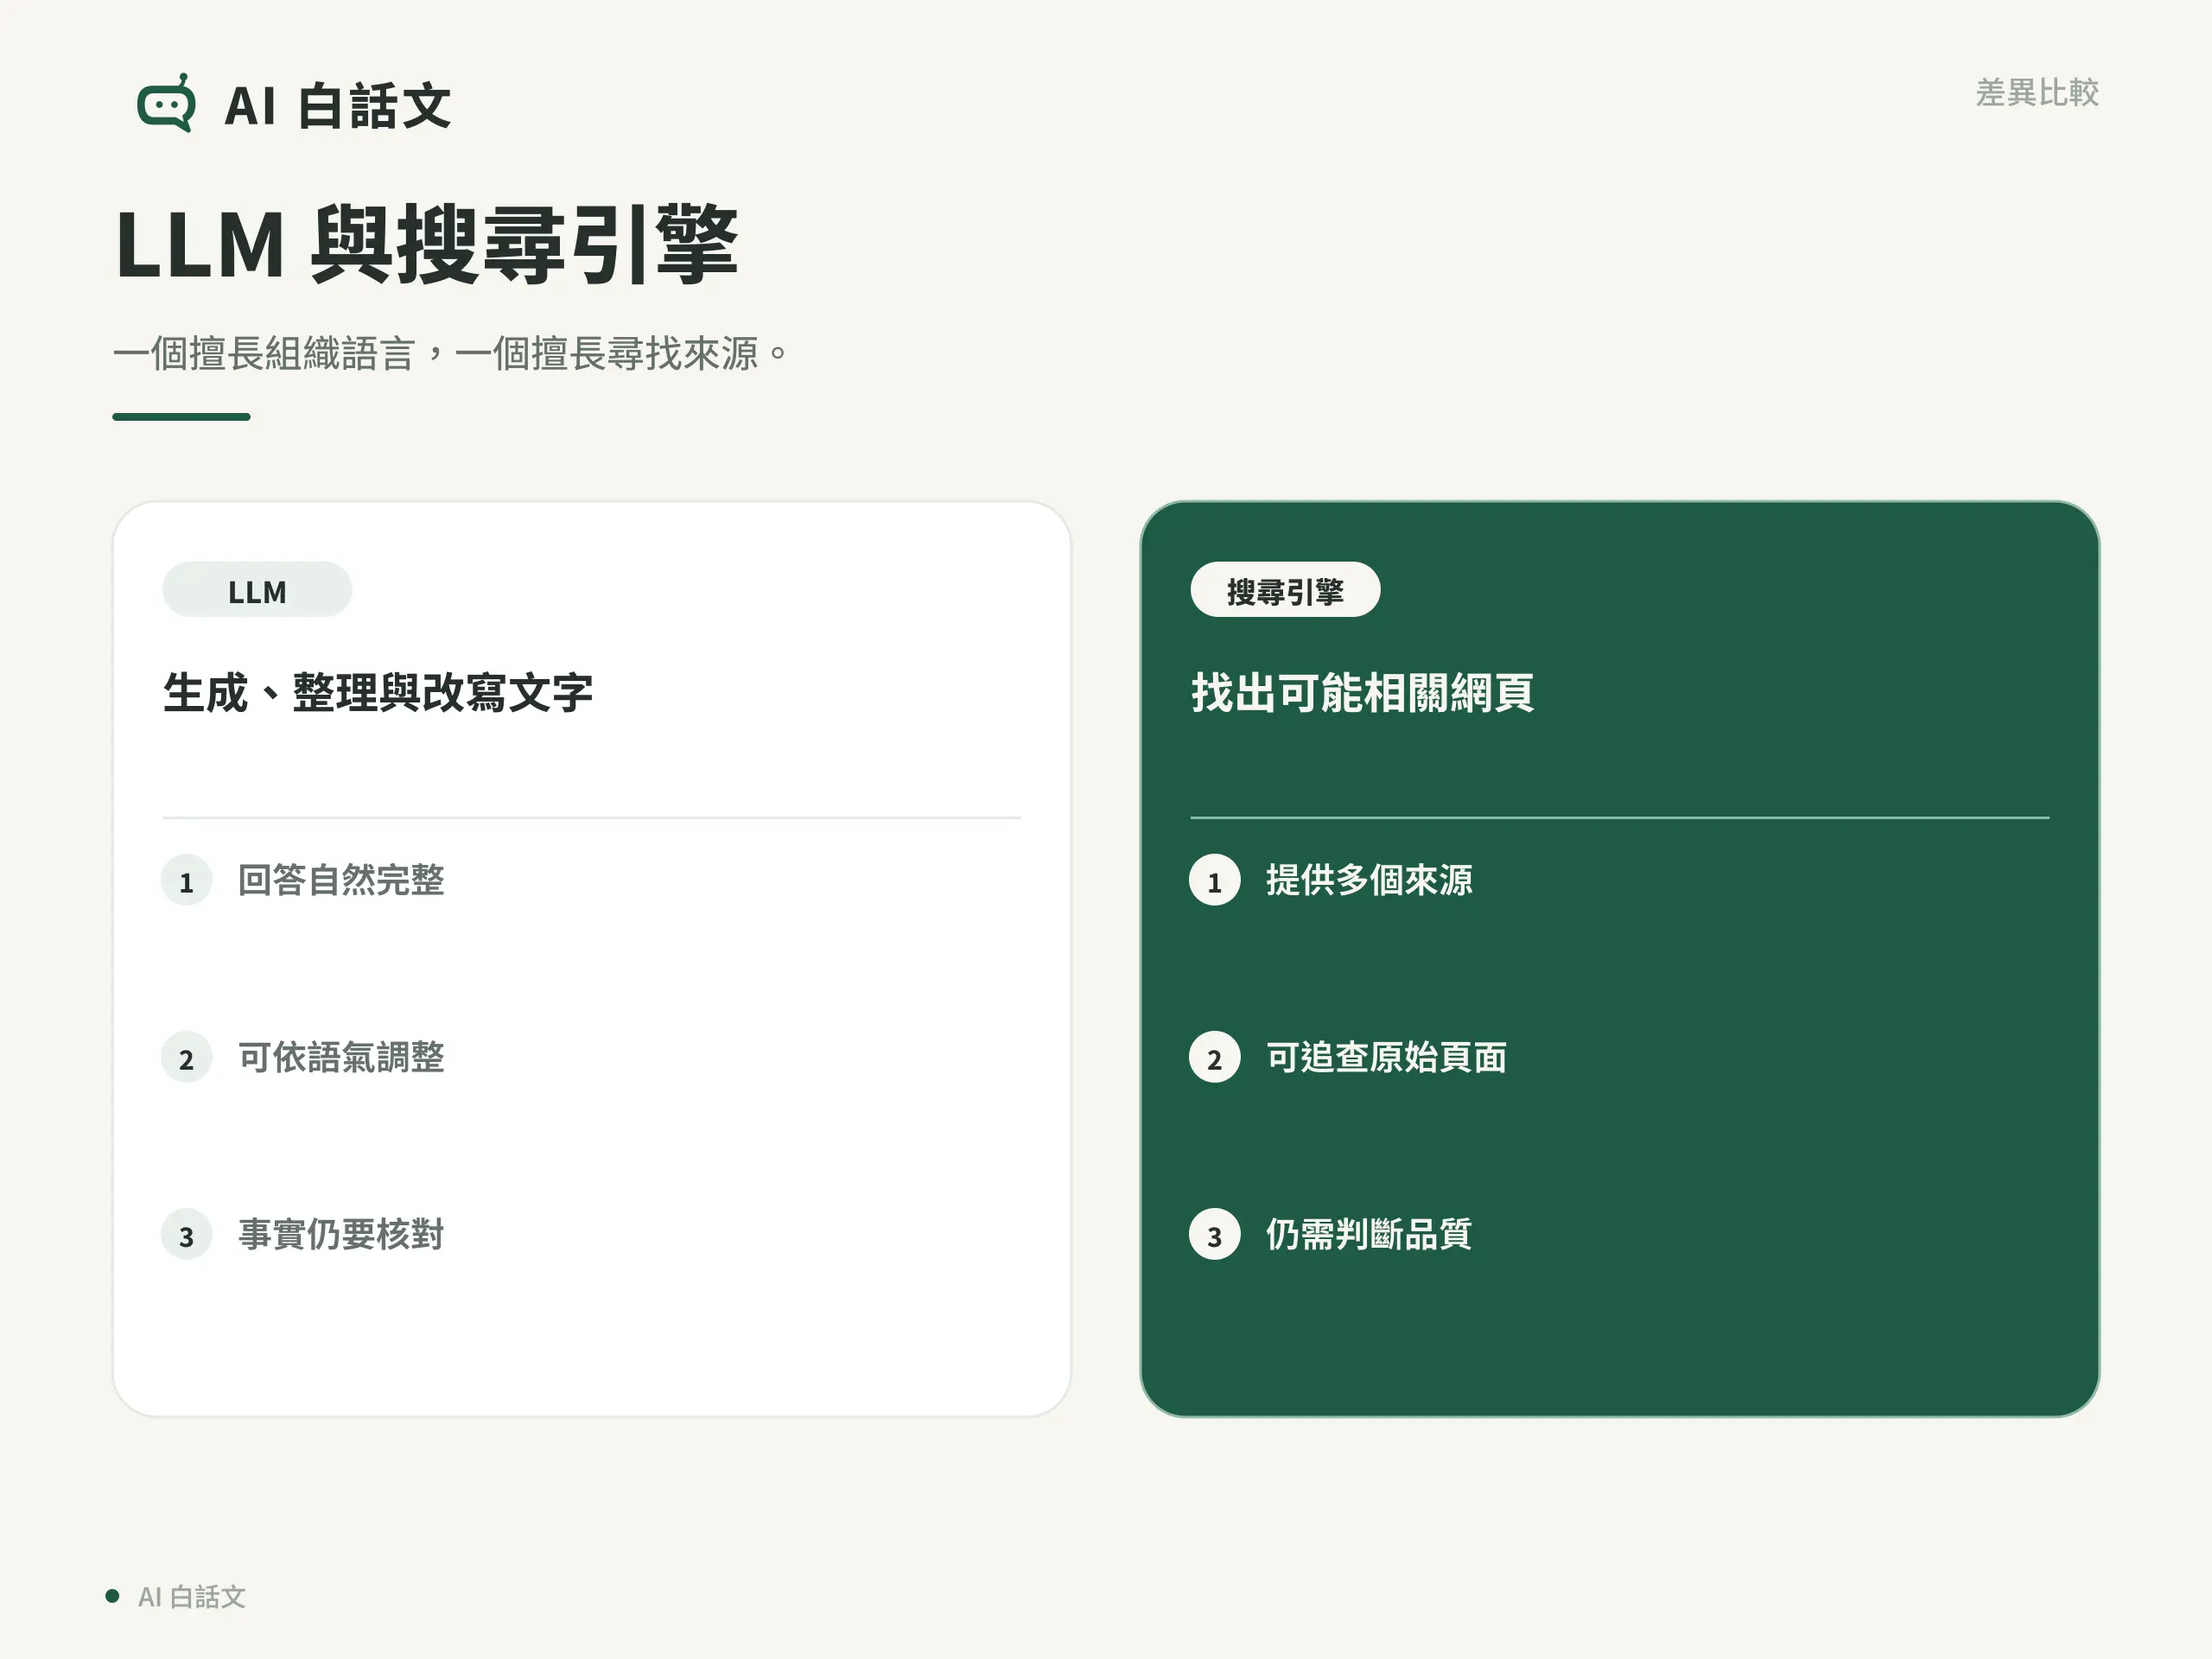
LLM、搜尋引擎和資料庫差在哪?
| 工具 | 主要工作 | 你要注意什麼 |
|---|---|---|
| LLM | 生成、整理與改寫語言 | 流暢不代表正確 |
| 搜尋引擎 | 找出可能相關的網頁與來源 | 仍要判斷來源品質 |
| 資料庫 | 依既定欄位保存與查詢資料 | 資料可能過時或輸入錯誤 |
有些 AI 產品會把 LLM 和網路搜尋、公司知識庫或計算工具接在一起。這能補強能力,但不會讓錯誤完全消失。你仍要看它到底用了什麼來源、來源是否支持結論,以及資料日期是否符合問題。
LLM 擅長哪些事情?
LLM 通常適合語言轉換與整理工作:
- 摘要:從你提供的原文整理重點。
- 改寫:調整語氣、長度、閱讀難度與格式。
- 發想:提出標題、問題、角度與初步選項。
- 分類與擷取:依規則把資料分組,或從文字找出指定欄位。
- 教學對話:根據學習程度解釋概念、出練習題,再針對答案回饋。
這些任務若有原始資料、清楚規則和可檢查的結果,效果通常比「請告訴我所有正確答案」更可靠。
例如原文是「星期五晚上七點讀書會,帶筆記本,星期三前回覆」,你可以要求:「整理成時間、物品、回覆期限三點,不要補資料。」一份可核對的摘要會保留星期五晚上七點、筆記本與星期三期限;若多出地點,就要回到原文檢查,因為通知沒有提供。
使用 LLM 的安全做法
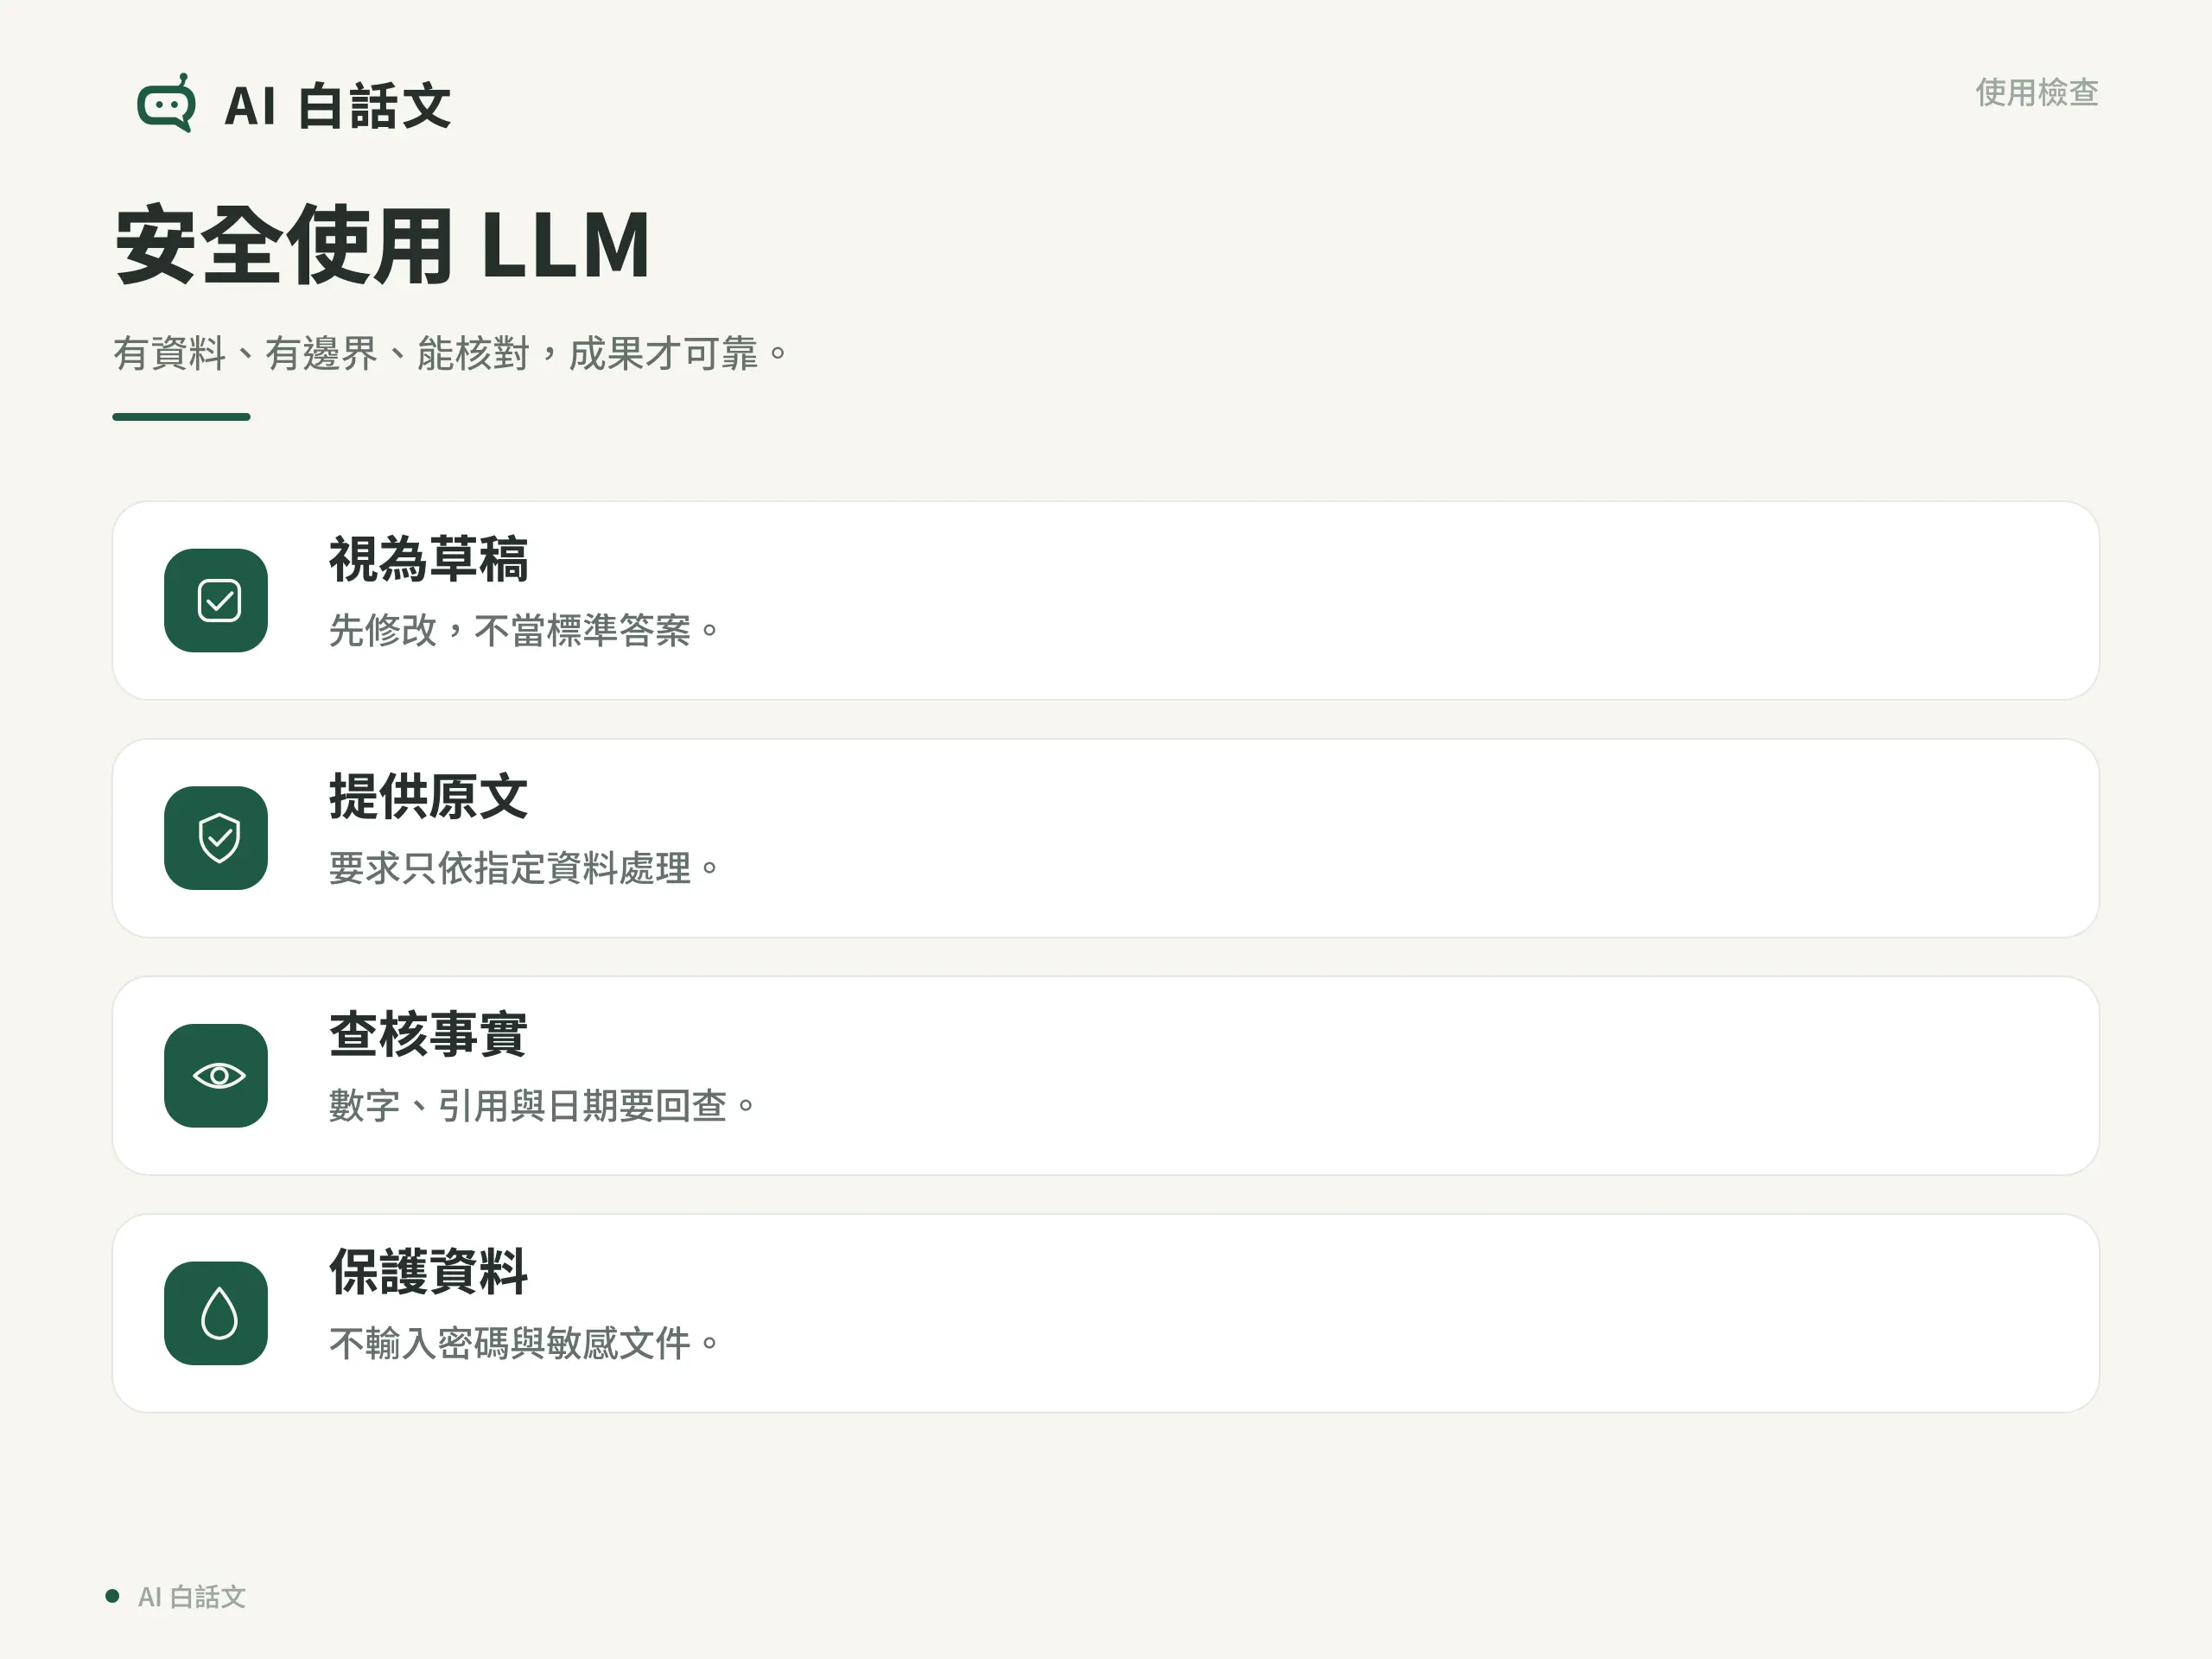
- 把答案視為候選草稿,不是標準答案。
- 重要事實要求來源,並親自點回原始頁面核對。
- 不要輸入不必要的個資、密碼、未公開文件或他人隱私。
- 計算、法規、醫療、金融和今天才發生的資訊,使用專用工具或官方來源確認。
- 要求模型標示不知道的地方,但不要以為一句指令就能保證它誠實無誤。
LLM 和 Token、Prompt 有什麼關係?
Token是模型處理文字時使用的小片段。模型一次能參考的 Token 有上限,所以超長對話或文件可能需要分段、摘要或重新整理。
Prompt就是你交給模型的指令和背景。Prompt 越能說清楚任務、資料範圍和輸出要求,模型越少需要自己猜。
可以把三者連成一條線:你用 Prompt 提供任務與資料,內容被拆成 Token,LLM 再根據這些內容產生回答。
總結
LLM 是從大量文字規律中學會預測和生成語言的模型。它很適合整理、改寫、發想與對話,但不是自帶真相保證的百科全書。懂得分清模型、產品、搜尋和資料庫,你就知道哪些工作可以交給它加速,哪些結論必須另外查證。
參考資料
重點整理
LLM 跟 ChatGPT 一樣嗎?
不一樣。ChatGPT 是一項產品,LLM 是產品背後可能使用的核心模型類型。不同產品還會加入搜尋、檔案、記憶、語音或其他工具。
LLM 真的理解語言嗎?
它能掌握非常複雜的語言關係,實用上可表現出理解能力;但不要因此推論它擁有人類的意識、生活經驗或責任判斷。對使用者而言,檢查輸出比爭論它是否「真的懂」更重要。
LLM 可以查最新資料嗎?
模型本身不一定知道最新資訊。若產品具備搜尋功能,它可以另外查網路;即使如此,也要確認查到的日期、來源與內容是否支持答案。