內容目錄
顯示
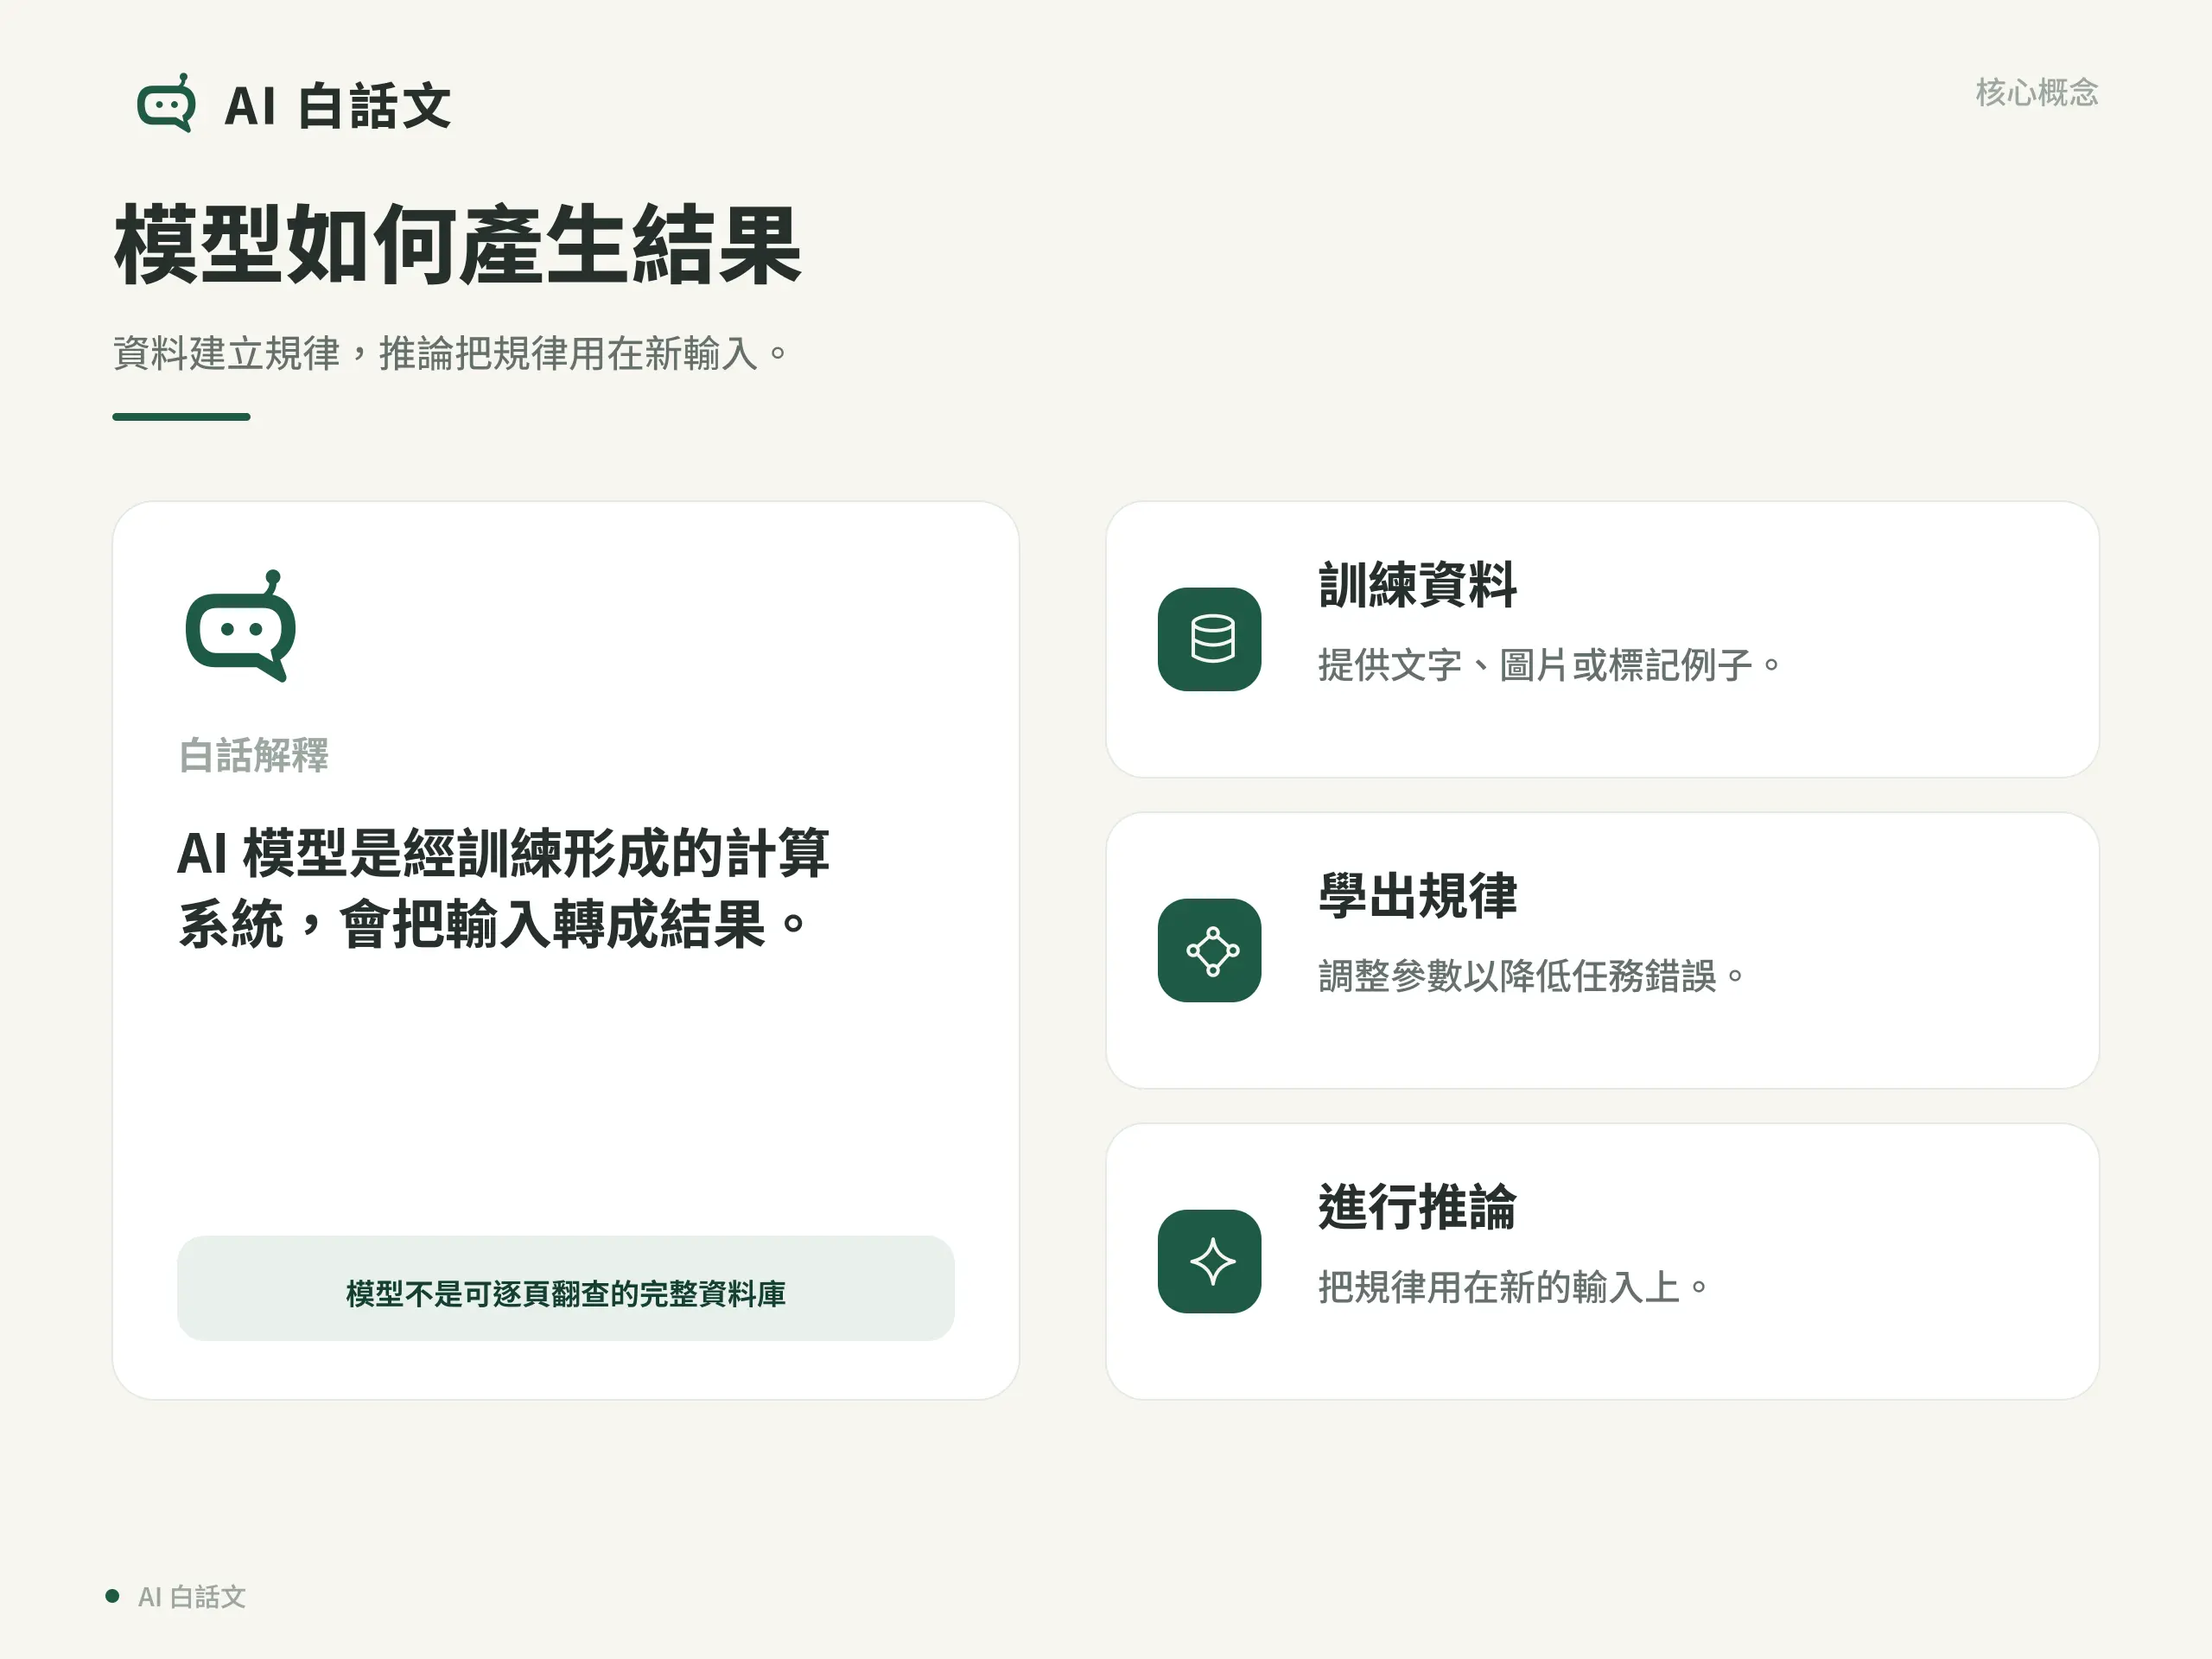
AI 在常見的機器學習做法中,模型是經過訓練後形成的計算系統,會把新的輸入轉成預測、分類或生成結果。它通常先從訓練資料調整出規律,等你真正使用時,再透過「推論」產生這一次的答案。
分不清訓練、訓練資料與推論,很容易把模型誤認成隨時查閱完整資料庫,也難以理解 AI 為什麼會過時、答錯、出現不同答案,或在某些群體與情境表現較差。
AI 模型是什麼?
AI 模型的定義:在常見的機器學習做法中,模型是經過訓練後形成的計算系統,會依內部設定與學到的規律,把新的輸入轉成預測、分類或生成結果。它不是一疊可以直接翻閱的課本,也不是每個問題都有一格標準答案的表格。這些可在訓練中調整的內部設定,通常稱為「參數」。
延伸來源:Google的說明
想像一位學生看過很多「今天的溫度、雲量、濕度」與「下午有沒有下雨」的紀錄。看得夠多後,他可能學到某些組合比較容易下雨。第二天看到新的天氣資料,他就能做預測。AI 模型做的事情相似,只是使用的資料量、計算方式與規律複雜得多。
同一個模型通常擅長某些任務,不代表什麼都行。辨識照片的模型不一定會寫文章;很會接續文字的模型,也不一定能精準計算或知道今天剛發生的新聞。
訓練資料扮演什麼角色?
訓練資料是建立或調整模型時使用的例子,可能包含文字、圖片、聲音、數字,以及人類已經標記好的類別或答案。它是模型學習規律的材料,不等於模型會逐字保存並隨時翻出全部原始資料。
例如要訓練垃圾郵件分類系統,可以準備許多郵件,並標出哪些是垃圾郵件。模型會尋找內容、寄件方式和用詞之間的規律。完成訓練後,它遇到新郵件,就能判斷可能性。
但資料會留下影響。如果訓練資料太舊,模型可能不熟悉新的詐騙手法;如果某一類郵件太少,模型對那一類可能判得較差;如果標記本身錯誤,模型也可能學到錯誤規律。
所以「資料很多」只回答了數量,沒有回答資料是否正確、完整、有代表性,以及是否適合目前任務。
訓練與推論有什麼不同?
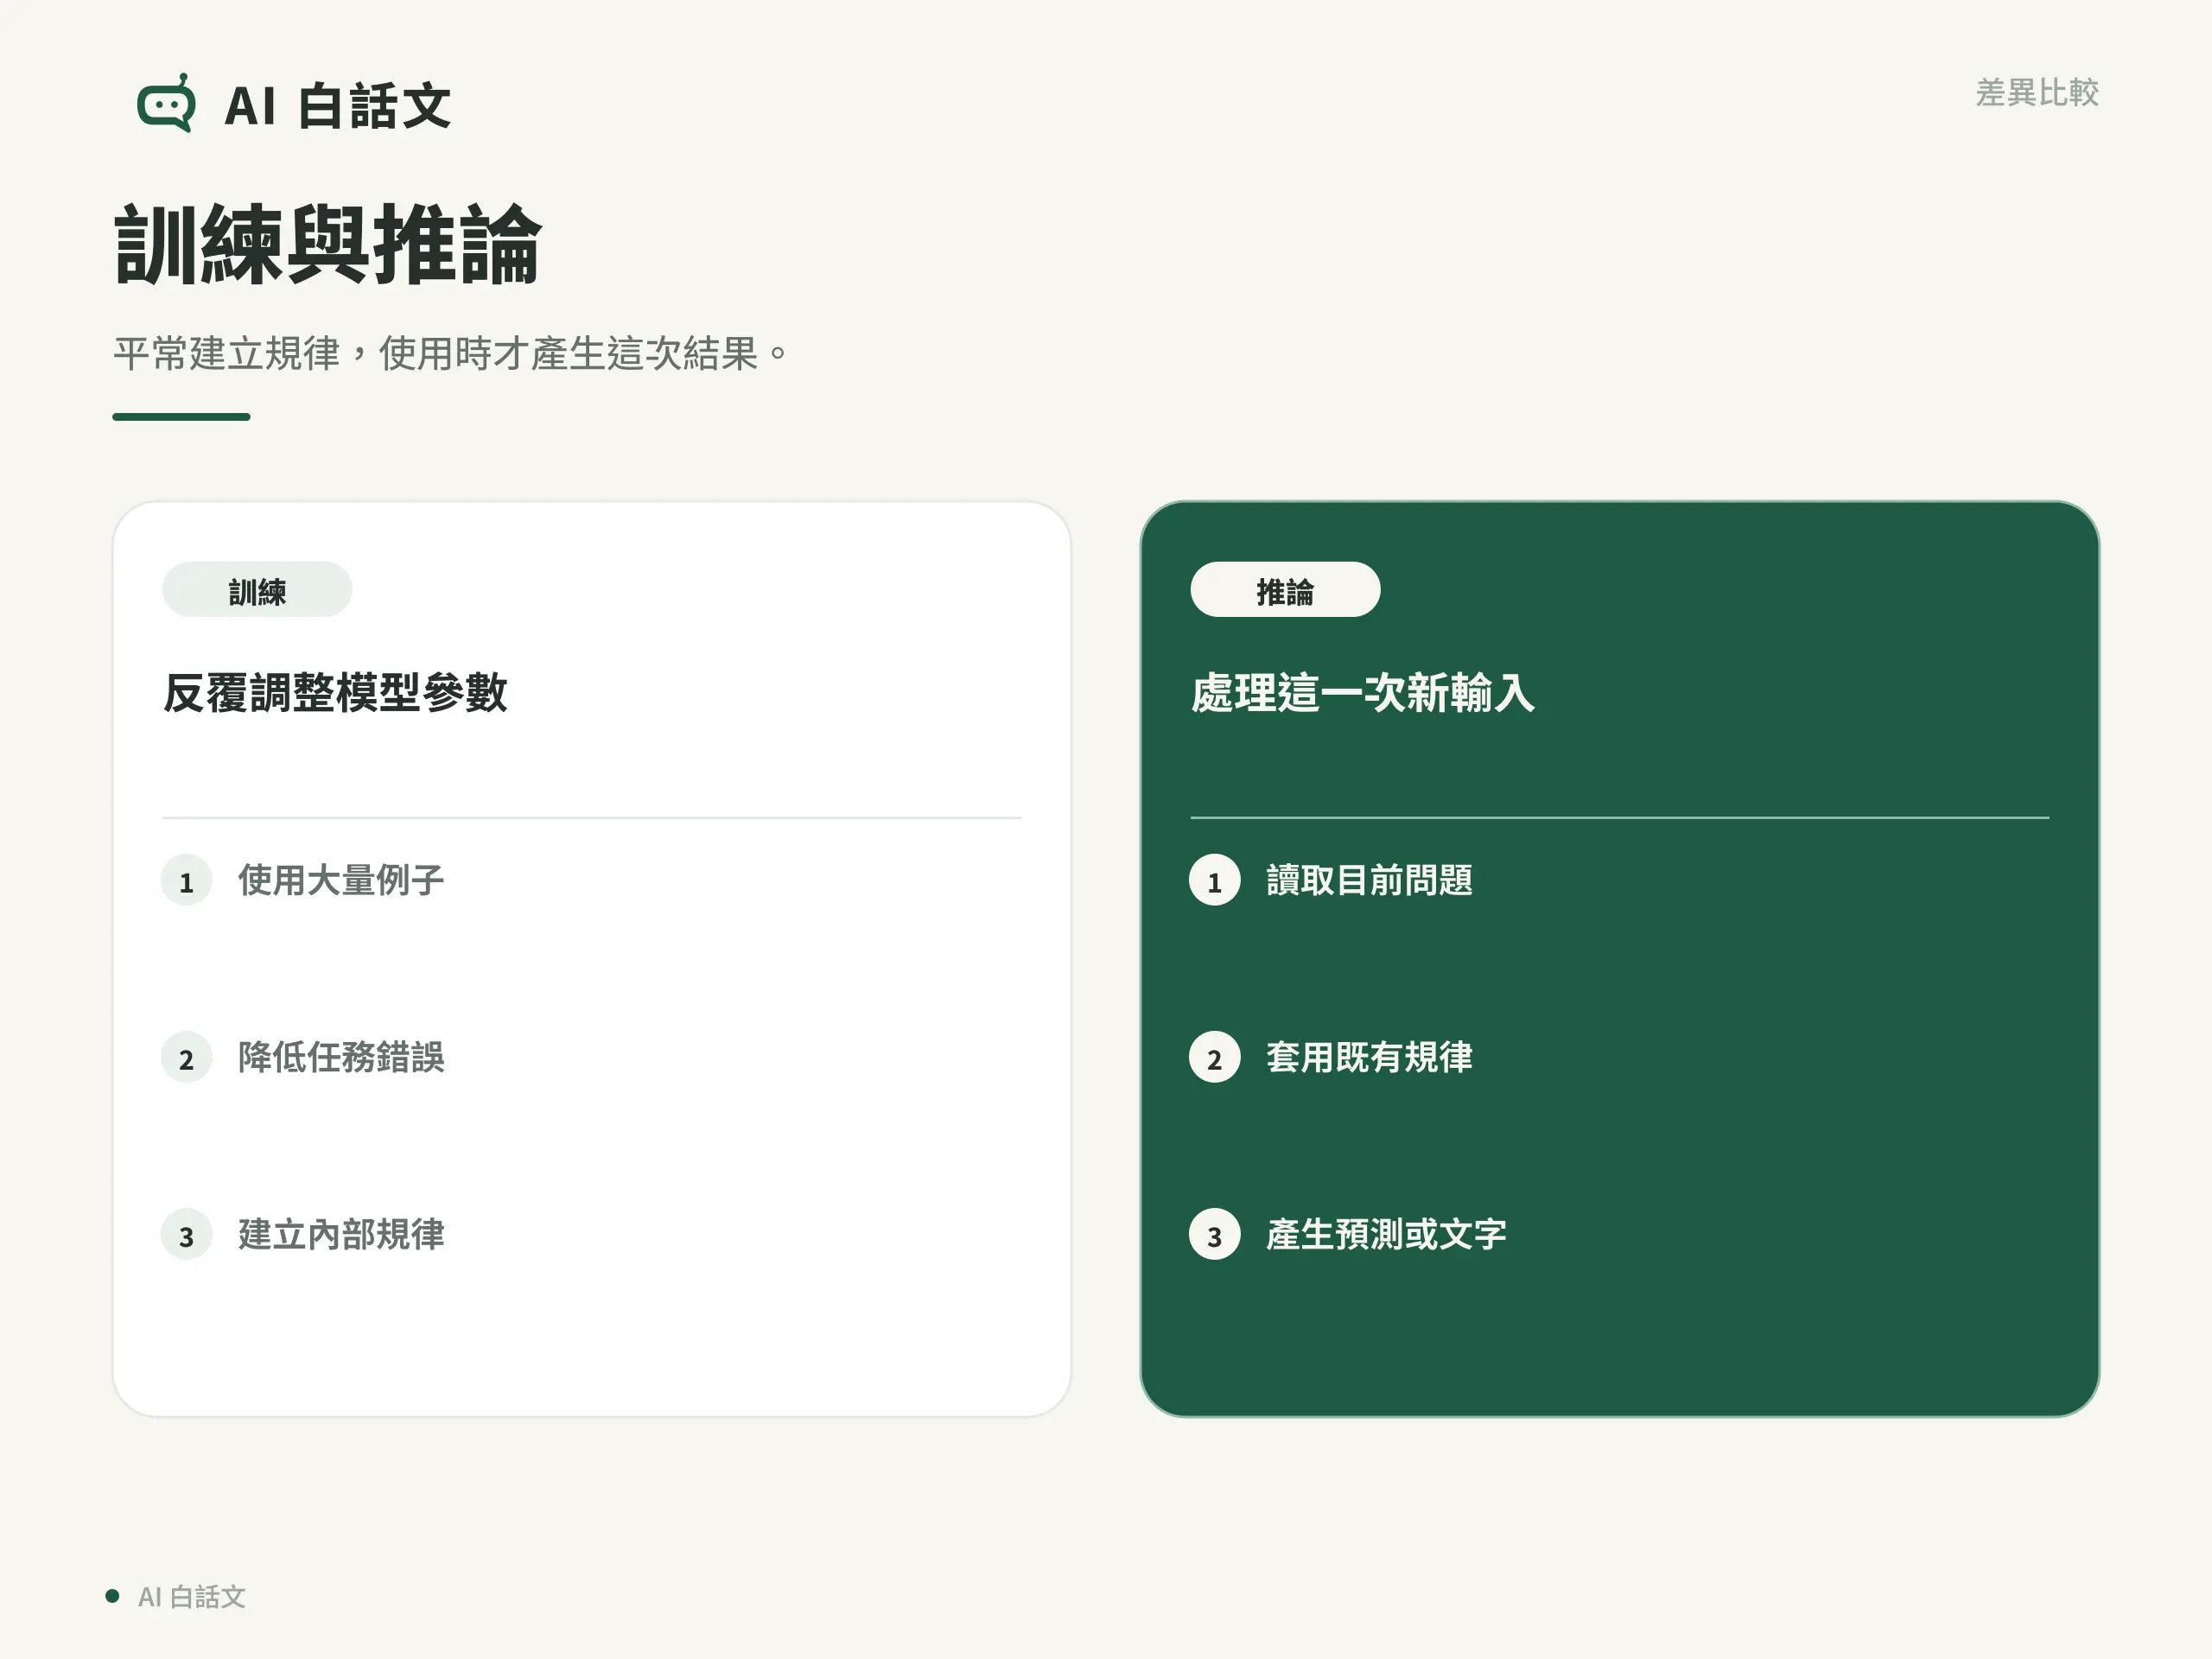
| 階段 | 核心定義 | 幫助理解的例子 |
|---|---|---|
| 訓練 | 利用資料反覆調整模型內部設定,使指定任務的錯誤降低 | 平常讀書、練習與訂正 |
| 推論 | 把新的輸入交給已訓練模型,計算預測或生成結果 | 考試時面對一題新題目 |
你在聊天工具輸入「幫我把這段文字整理成三點」,通常是在要求模型推論。它會依照目前看到的文字和已學到的語言規律,生成整理結果。
這不代表每問一次,整個模型就把你的問題吸收進去重新訓練。平台可能會保留對話、提供記憶功能,或依其政策使用部分資料改善服務,但那是另一個層次的資料處理問題,不能和單次推論混在一起。
AI 如何從規律產生輸出?
不同 AI 的輸出方式不同。分類模型可能判斷一封信比較像垃圾郵件;語言模型則會根據前文,一小段一小段地預測接下來適合出現的文字。
這也是為什麼語言模型可以寫得很順,卻不一定真的知道事實。假設它常看到「某某大學教授發表研究」這種句型,它可能產生一個看似完整的研究引用,但人名、年份或論文根本不存在。句子合理,不等於事情發生過。
輸入也會改變結果。你說「介紹恐龍」和「用國小四年級能懂的方式,以 150 字介紹暴龍,並分成外觀、食物、生活年代三點」,模型收到的線索不同,輸出自然不同。
為什麼同一個模型會有不同答案?
第一,問題可能不夠明確,模型必須猜你的目標。第二,對話前文不同,模型可參考的內容也不同。第三,生成工具有時會保留一些變化,避免每次都只產生完全相同的句子。
這不表示使用者只能碰運氣。你可以用三個方法降低變動:
- 交代清楚對象、目的、限制與輸出格式。
- 提供它必須依據的原始資料,不要求它憑空補齊。
- 先請它列大綱,再逐段完成與檢查,不一次交付大任務。
資料多就一定比較準嗎?
不一定。想像你要學台灣的交通規則,卻收到一百萬份別國的舊資料。數量很大,卻可能不適合你的問題。再想像其中有大量重複、錯誤或只代表少數地區的資料,模型學到的規律也可能偏斜。
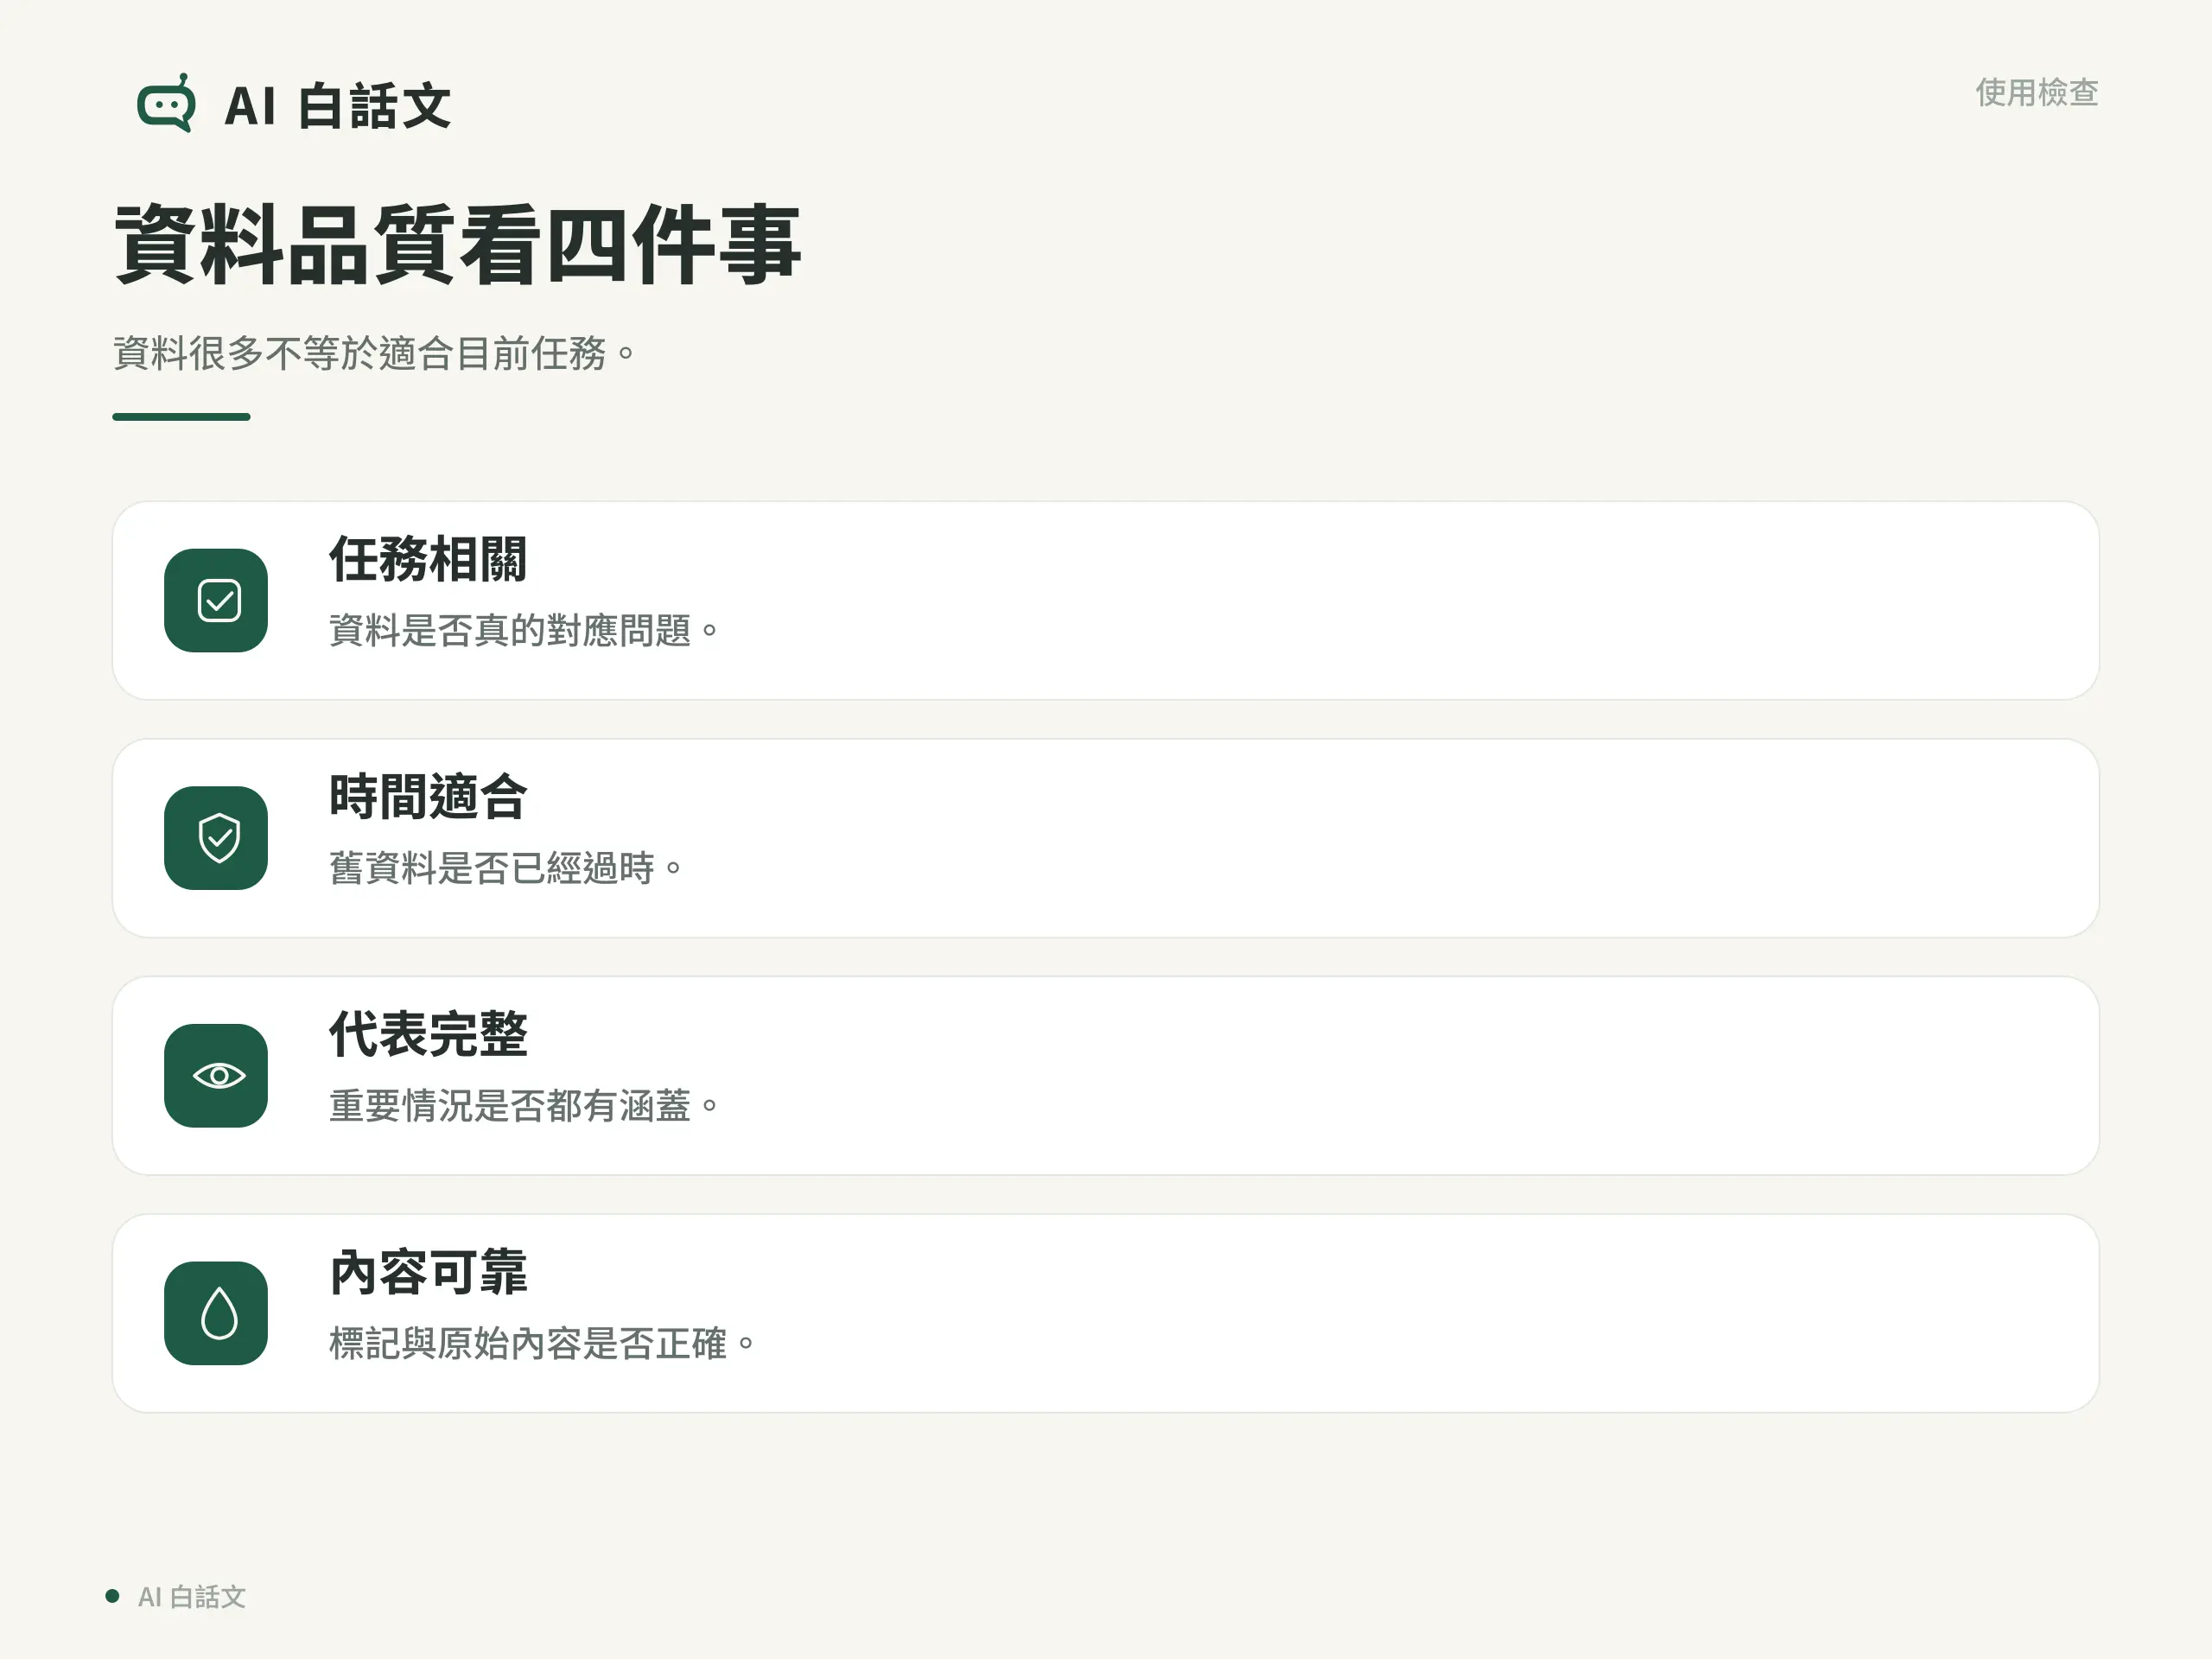
判斷訓練資料,至少要問四件事:資料和任務有關嗎?時間夠新嗎?重要情況都有被代表嗎?標記和內容可靠嗎?
一般使用者無法看到商業模型的全部訓練資料,但仍可從使用方式降低風險:提供可靠的原始資料與問題背景、要求區分已知與推測、遇到重要事實回到原始來源,並以不同案例測試答案。
這個原理如何解釋幻覺與偏誤?
幻覺是模型產生看似合理、實際卻錯誤或無根據的內容。語言流暢是模型的強項,事實正確則需要另外查核。
偏誤是結果長期往某些方向傾斜,例如資料裡某些族群太少,模型對他們的判斷表現較差。這不一定是一句明顯的錯話,也可能是不公平的遺漏或分類差異。
因此,理解模型不是為了讓你自己訓練 AI,而是讓你不會把每個輸出都當成從資料庫查到的標準答案。
總結
本文介紹的 AI 模型,是利用訓練資料調整而成的計算系統;訓練負責建立規律,推論負責把規律用在新輸入。模型產生的是可能的結果,不是自動查證過的真相。當你理解這一點,就會自然地提供背景、拆小任務、檢查來源,也更能理解幻覺與偏誤從哪裡來。
參考資料
重點整理
AI 會記住所有訓練資料嗎?
不能這樣理解。模型會把資料中的規律反映在內部設定裡,不等於保存一套可以逐頁翻查的完整原文。某些模型仍可能重現資料片段,因此也不能反過來說它絕不會吐出相似內容。
AI 每次回答都會重新學習嗎?
一般使用時主要是推論,不是重新訓練整個模型。平台是否保留或使用對話資料,要查看該服務當下的隱私與資料控制政策。
訓練資料越多越好嗎?
數量是條件之一,但正確性、代表性、時效與任務相關性同樣重要。大量錯誤或不合用的資料,可能讓結果更難信任。