內容目錄
顯示
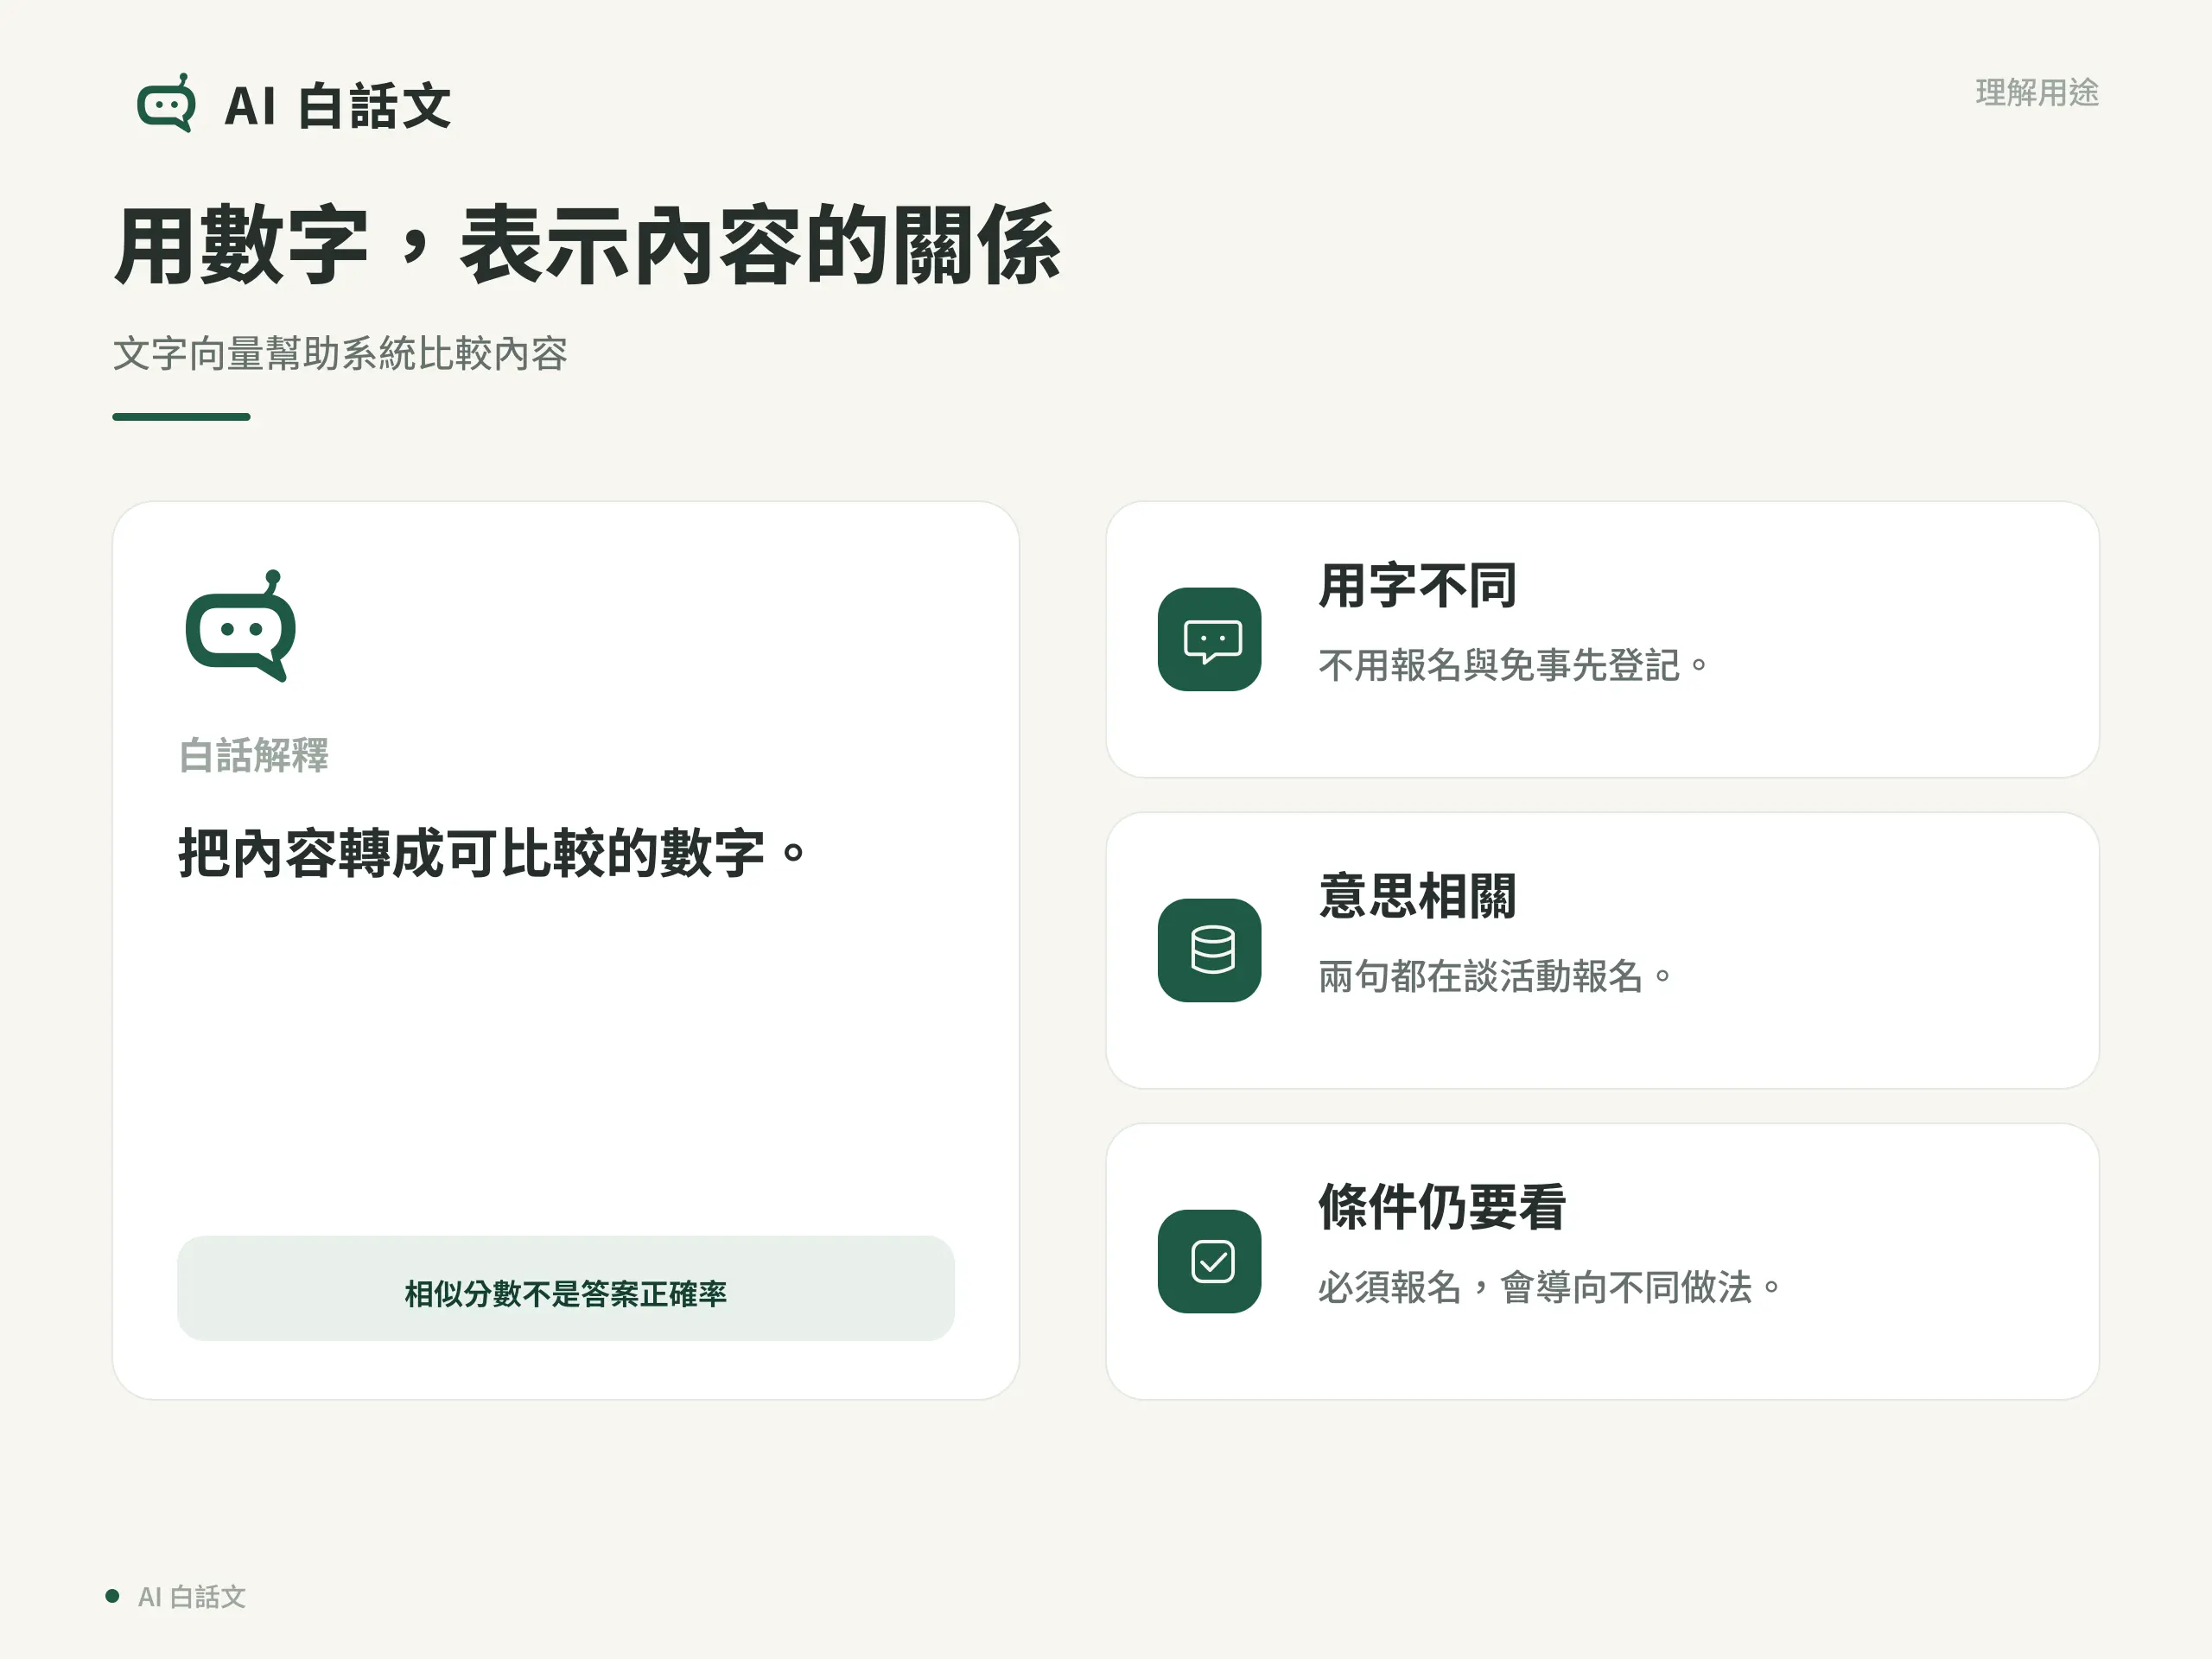
Embedding 是把資料轉成一串數字表示的方法。本文先談文字:這串數字可用來比較兩段文字的關係,例如找出用字不同、意思卻很接近的句子。
這種數字表示常叫做語意向量。「向量」在這裡先理解成一組有順序的數字就好,你不需要先學公式。重點是它能幫忙找相關內容,卻不能直接替你判斷哪一句是真的。
為什麼不能只看文字有沒有一樣?
假設你在找「活動要不要先報名」,文件可能寫成「本活動免事先登記」。兩句沒有使用完全相同的詞,卻談同一個問題。
文字 Embedding 的用途之一,就是讓系統有機會從意思找內容,而不只比對表面字詞。這種做法通常叫語意搜尋,也就是按照文字表達的意思尋找相關資料。
關鍵字搜尋仍然有用。例如訂單編號「A102」就需要準確對上,不能因為「A103」看起來很像就當成同一筆。兩種方式可以互相補充。
數字像位置,但不是一張真正的地圖
你可以想像把句子放在一張「意思地圖」上:談同一件事的句子比較靠近,談完全不同事情的句子比較遠。這只是幫助理解的比喻,實際數字不是經緯度。
負責轉換的 AI,常叫做 Embedding 模型。它產生數字表示,讓系統用計算方式比較關係。你不用替每個字手動編號。
Google 的教學提醒,實際向量裡每個數字代表的意義,通常不像地圖的東西南北那麼直觀。因此不能把其中一個數字直接解讀為「這句有八成可信」。
用三個句子,分清相關與相反
下面都是原創教學句子,不是真實活動公告,也沒有對任何模型測量相似度。
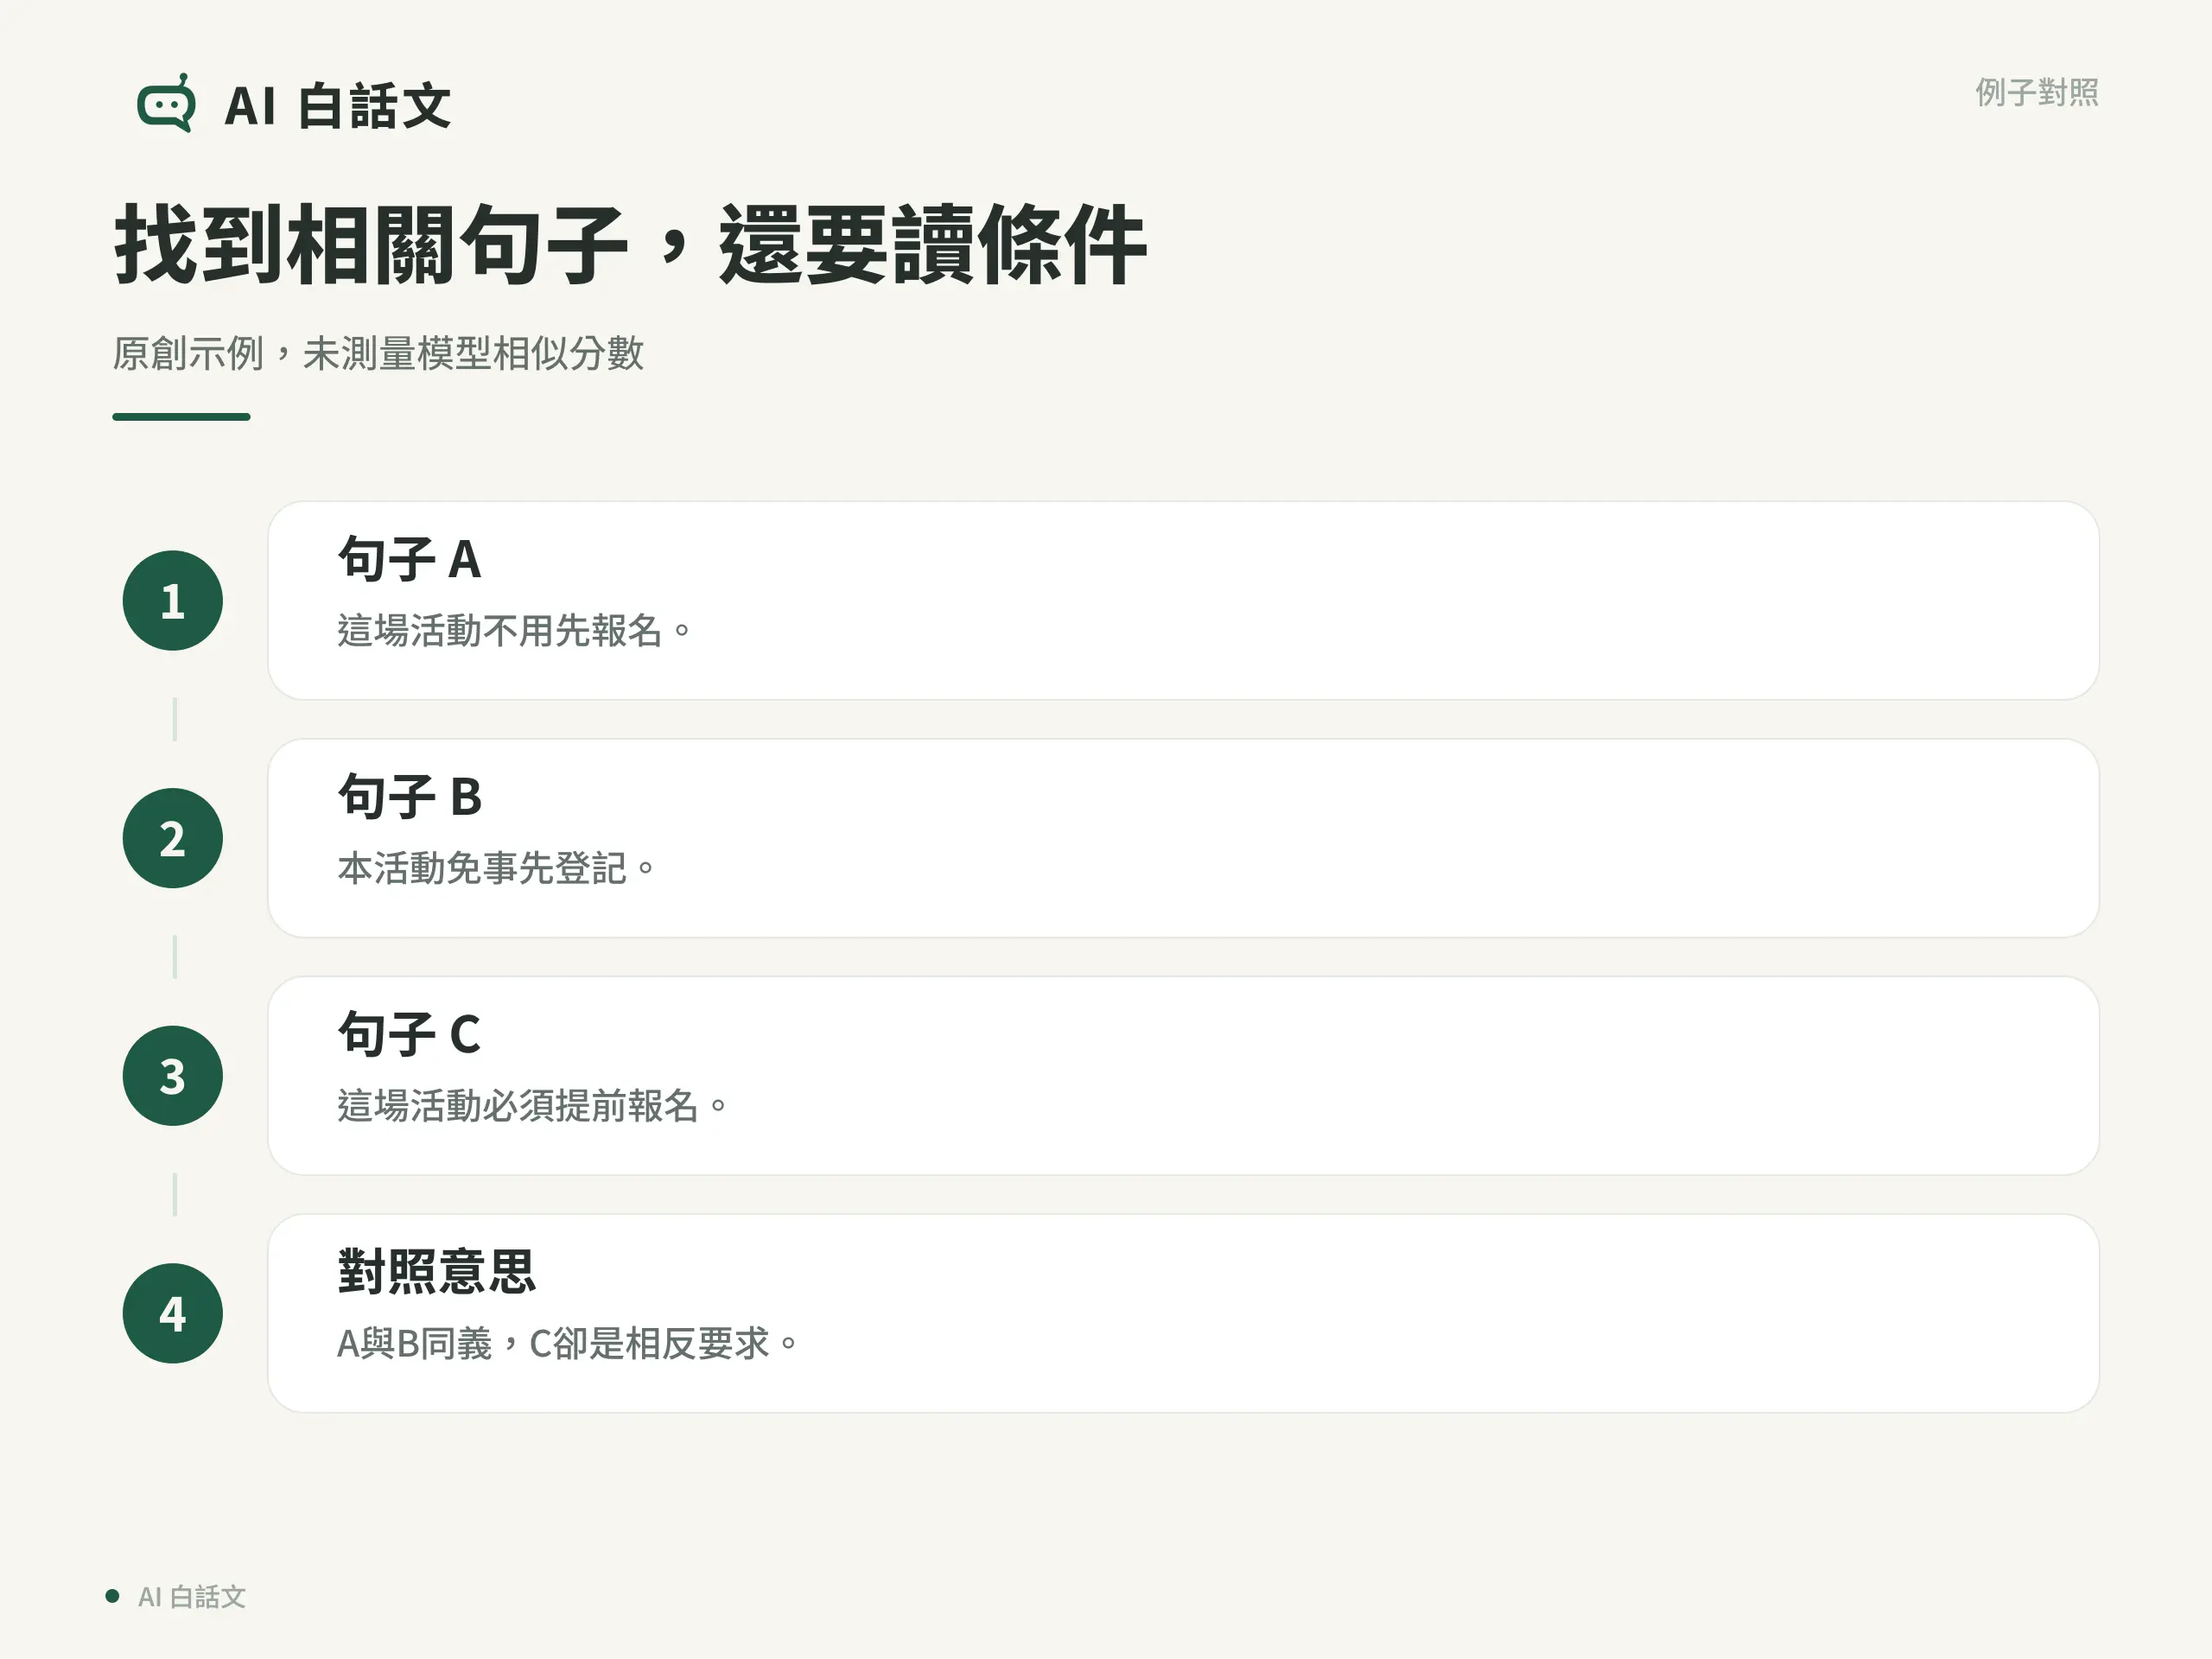
- A:這場活動不用先報名。
- B:本活動免事先登記。
- C:這場活動必須提前報名。
A 和 B 在這個情境表達相同意思,C 卻是相反要求。但三句都在談活動報名,實際搜尋時都有可能成為相關結果。
因此,搜尋系統把 C 找出來,不等於它已經判定 C 和 A 的規定相同。找到候選資料後,仍要讀「不用」「免」「必須」等關鍵條件。
從問題到搜尋結果,中間做了什麼?
以一批活動說明為例,可以簡化成四個動作:
- 把每段說明交給 Embedding 模型,轉成數字。
- 保存數字與對應的原始說明,讓它們可以找回彼此。
- 把「活動要不要報名」這個問題也轉成可比較的數字。
- 比較問題與說明的關係,找出相關段落,再讀原文。
實際應用通常讓問題與文件使用同一個、或明確相容的轉換方式。不能隨便拿兩種不相容模型的數字直接比較,就像不能把兩張比例不同的地圖直接疊起來判斷距離。
這一段流程的成果是找到相關內容,還不是一段完整回答。後續若讓 AI 參考找到的內容整理答案,就可能成為 RAG 流程的一部分。
看到相似結果時,還要檢查什麼?
先看文件是不是你問的活動,再看日期與報名要求。兩份文字可能非常相似,但一份是去年的活動,另一份才是今年的安排。
若搜尋結果有相似分數,也不要把它直接當成答案正確率。分數是在指定比較方法下表示關係,不能證明內容適用或沒有錯。
新手可以先做一個不用工具的練習:讀完 A、B、C,指出哪兩句在這個情境意思相同,哪一句會讓你的下一步行動不同。能分清這件事,就掌握了「找相似」和「讀懂條件」的差別。
總結
Embedding 用數字表示內容,讓電腦比較關係。它能協助找出相關句子,但相近的文字可能有相反規定;最後仍要回到原文,確認對象、日期與條件。
參考資料
重點整理
Embedding 就是把文章摘要成數字嗎?
這個說法不夠準確。它是依模型把內容轉成數字表示,主要用來計算關係;不能像一般摘要一樣直接讀出全文重點。
相似分數很高,代表內容很正確嗎?
不代表。它只反映指定表示與比較方式下的關係,內容仍可能過期、對象不同,甚至結論相反。
Embedding 只能處理文字嗎?
不只文字,也有處理圖片等資料的模型。不同模型支援的資料與比較方式不同,本文只用文字例子解釋核心概念。