內容目錄
顯示
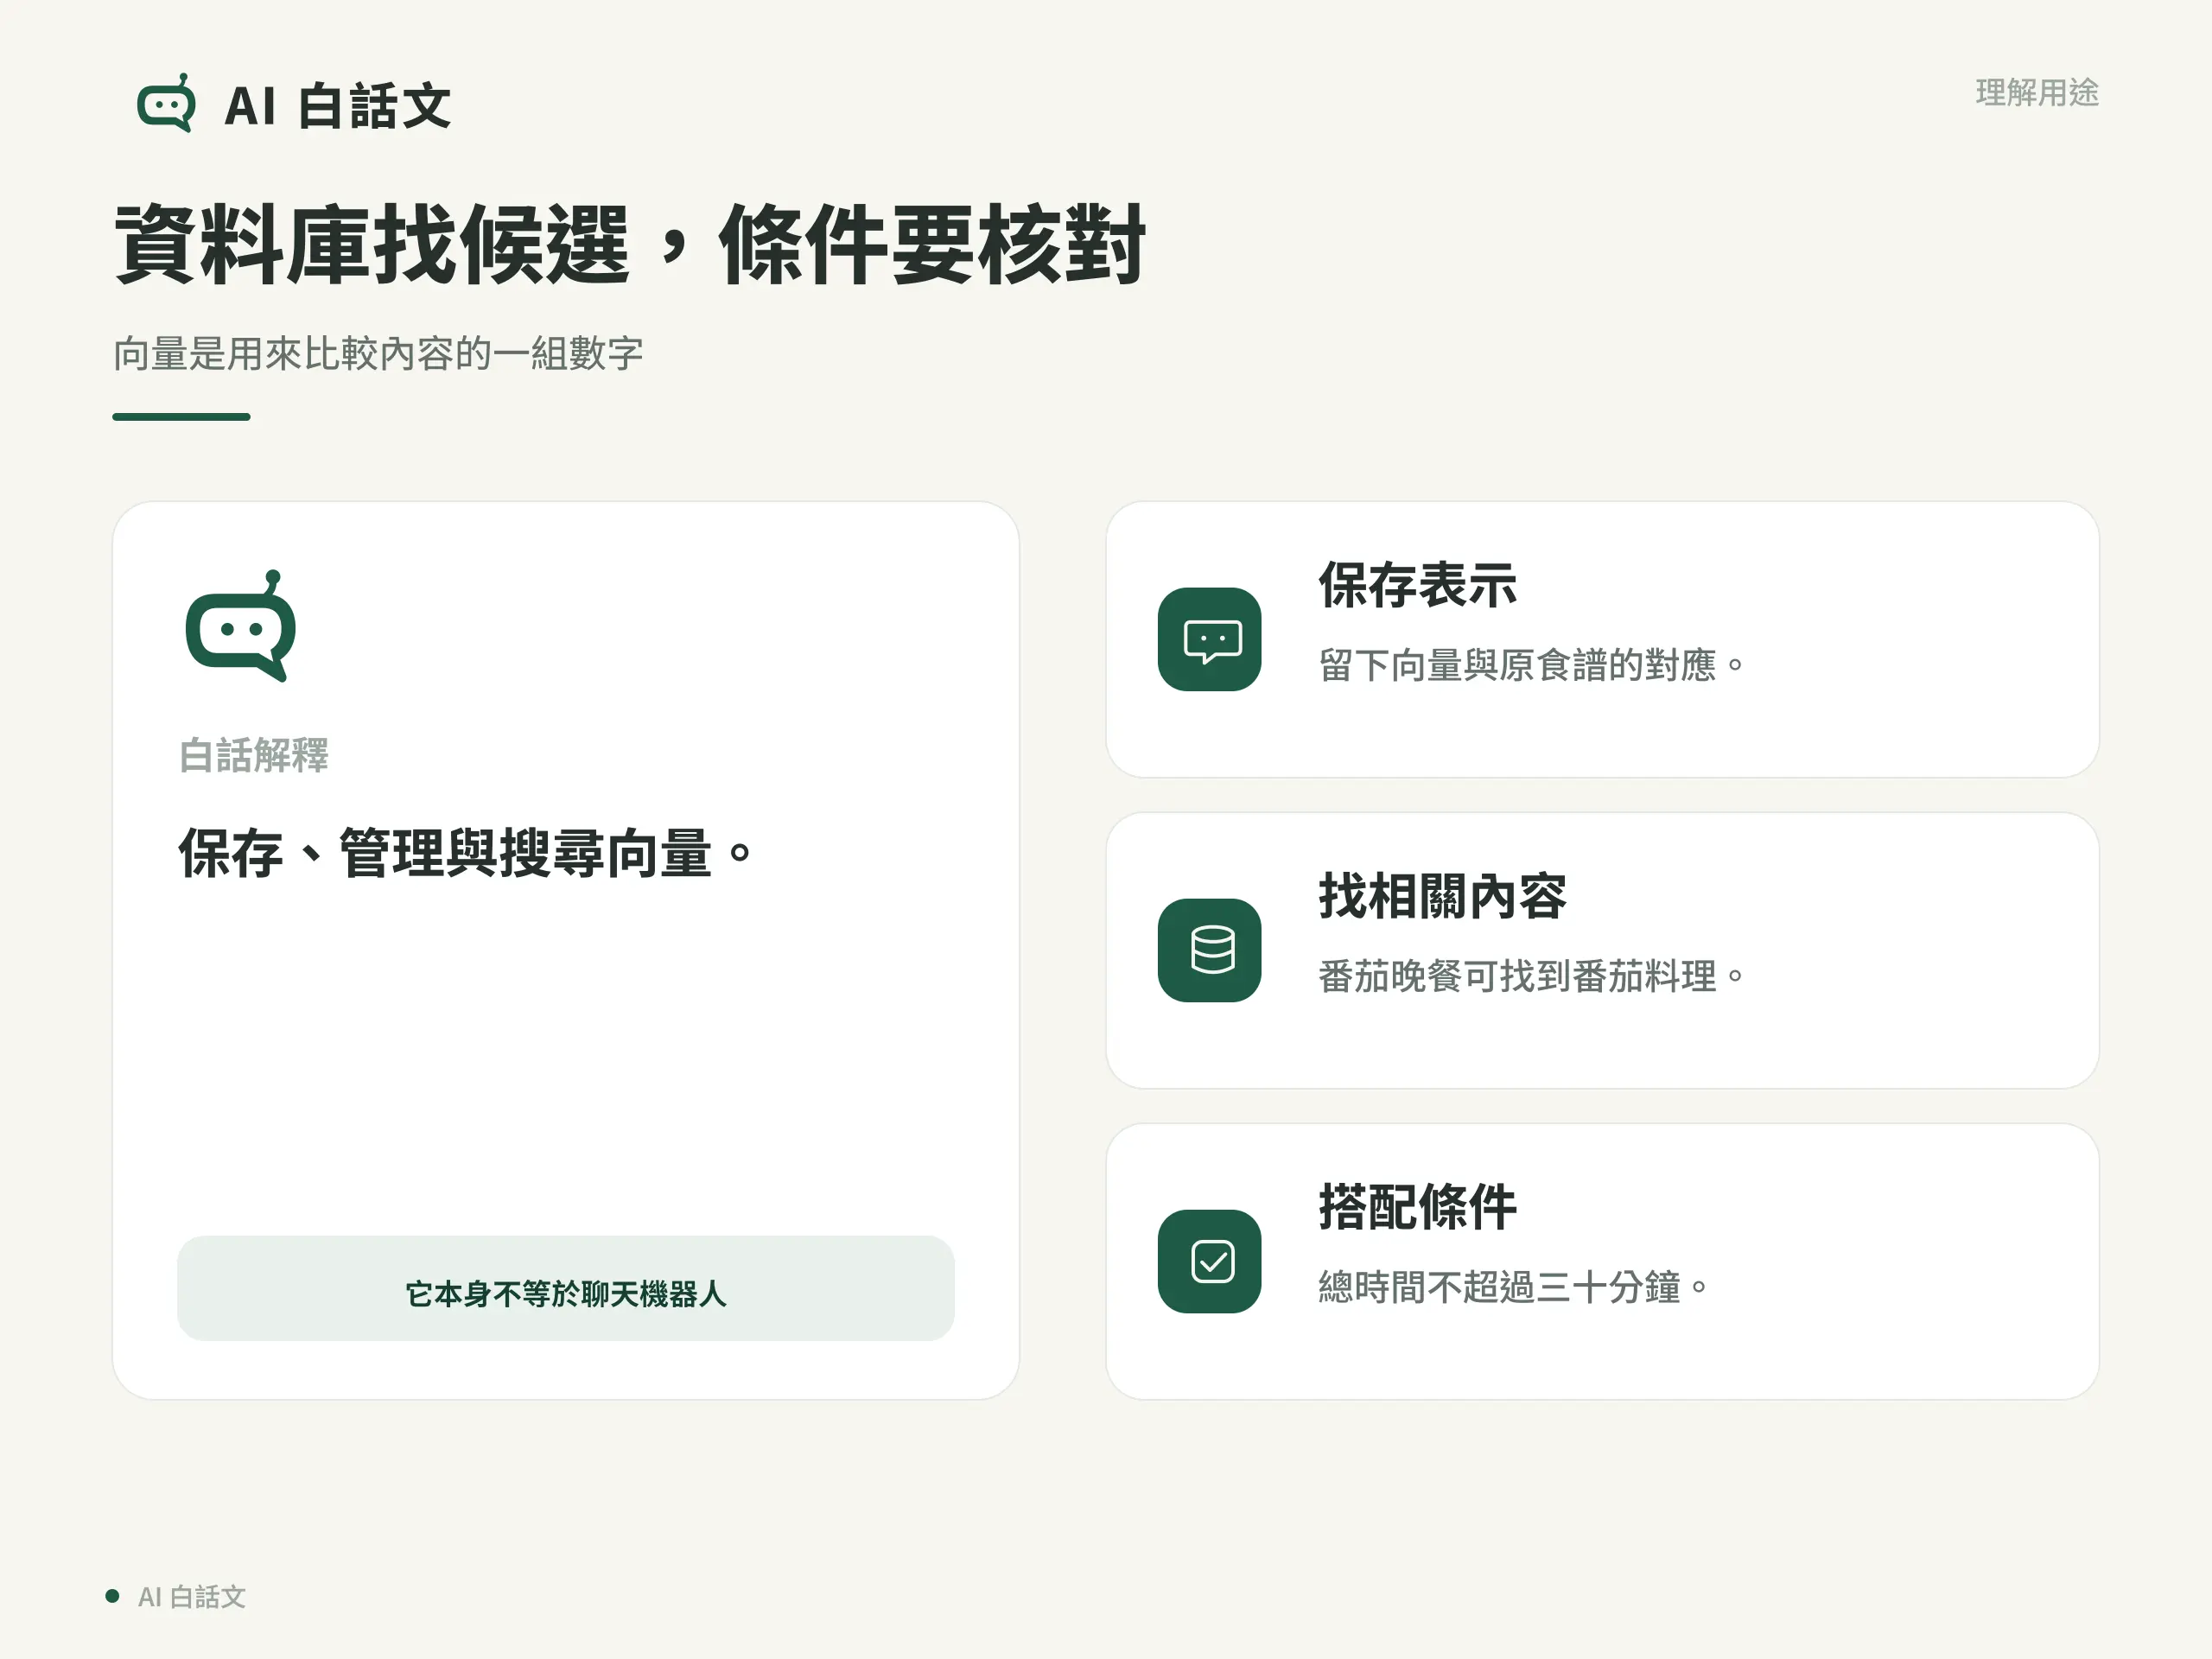
向量資料庫是一種擅長保存、管理與搜尋向量的資料庫。在文字應用裡,向量是一串用來表示內容關係的數字;系統可用它找出和你的問題相關的資料。
例如你想找「半小時內能煮好的番茄晚餐」,資料裡可能寫的是「番茄義大利麵」,沒有完全相同的句子。向量搜尋能協助找相關食譜,但是否真的在半小時內,仍要看食譜的時間資料。
先把兩個陌生詞拆開
資料庫可以先想成有組織地保存與查找資料的地方。向量則是模型為內容產生的一組數字,方便系統比較不同內容之間的關係。
把文字轉成這種數字表示,叫做 Embedding。向量資料庫負責保存與搜尋這些表示,並保留通往原始資料的對應關係。
這裡的比喻像是「能按照內容關係找卡片的資料櫃」,不是 AI 的人類式記憶,也不是把文件放進去後就會自行理解所有規定。
從三份食譜找出候選內容
以下是原創的虛構教材,時間只用來示範搜尋條件,不是實際烹調實測:
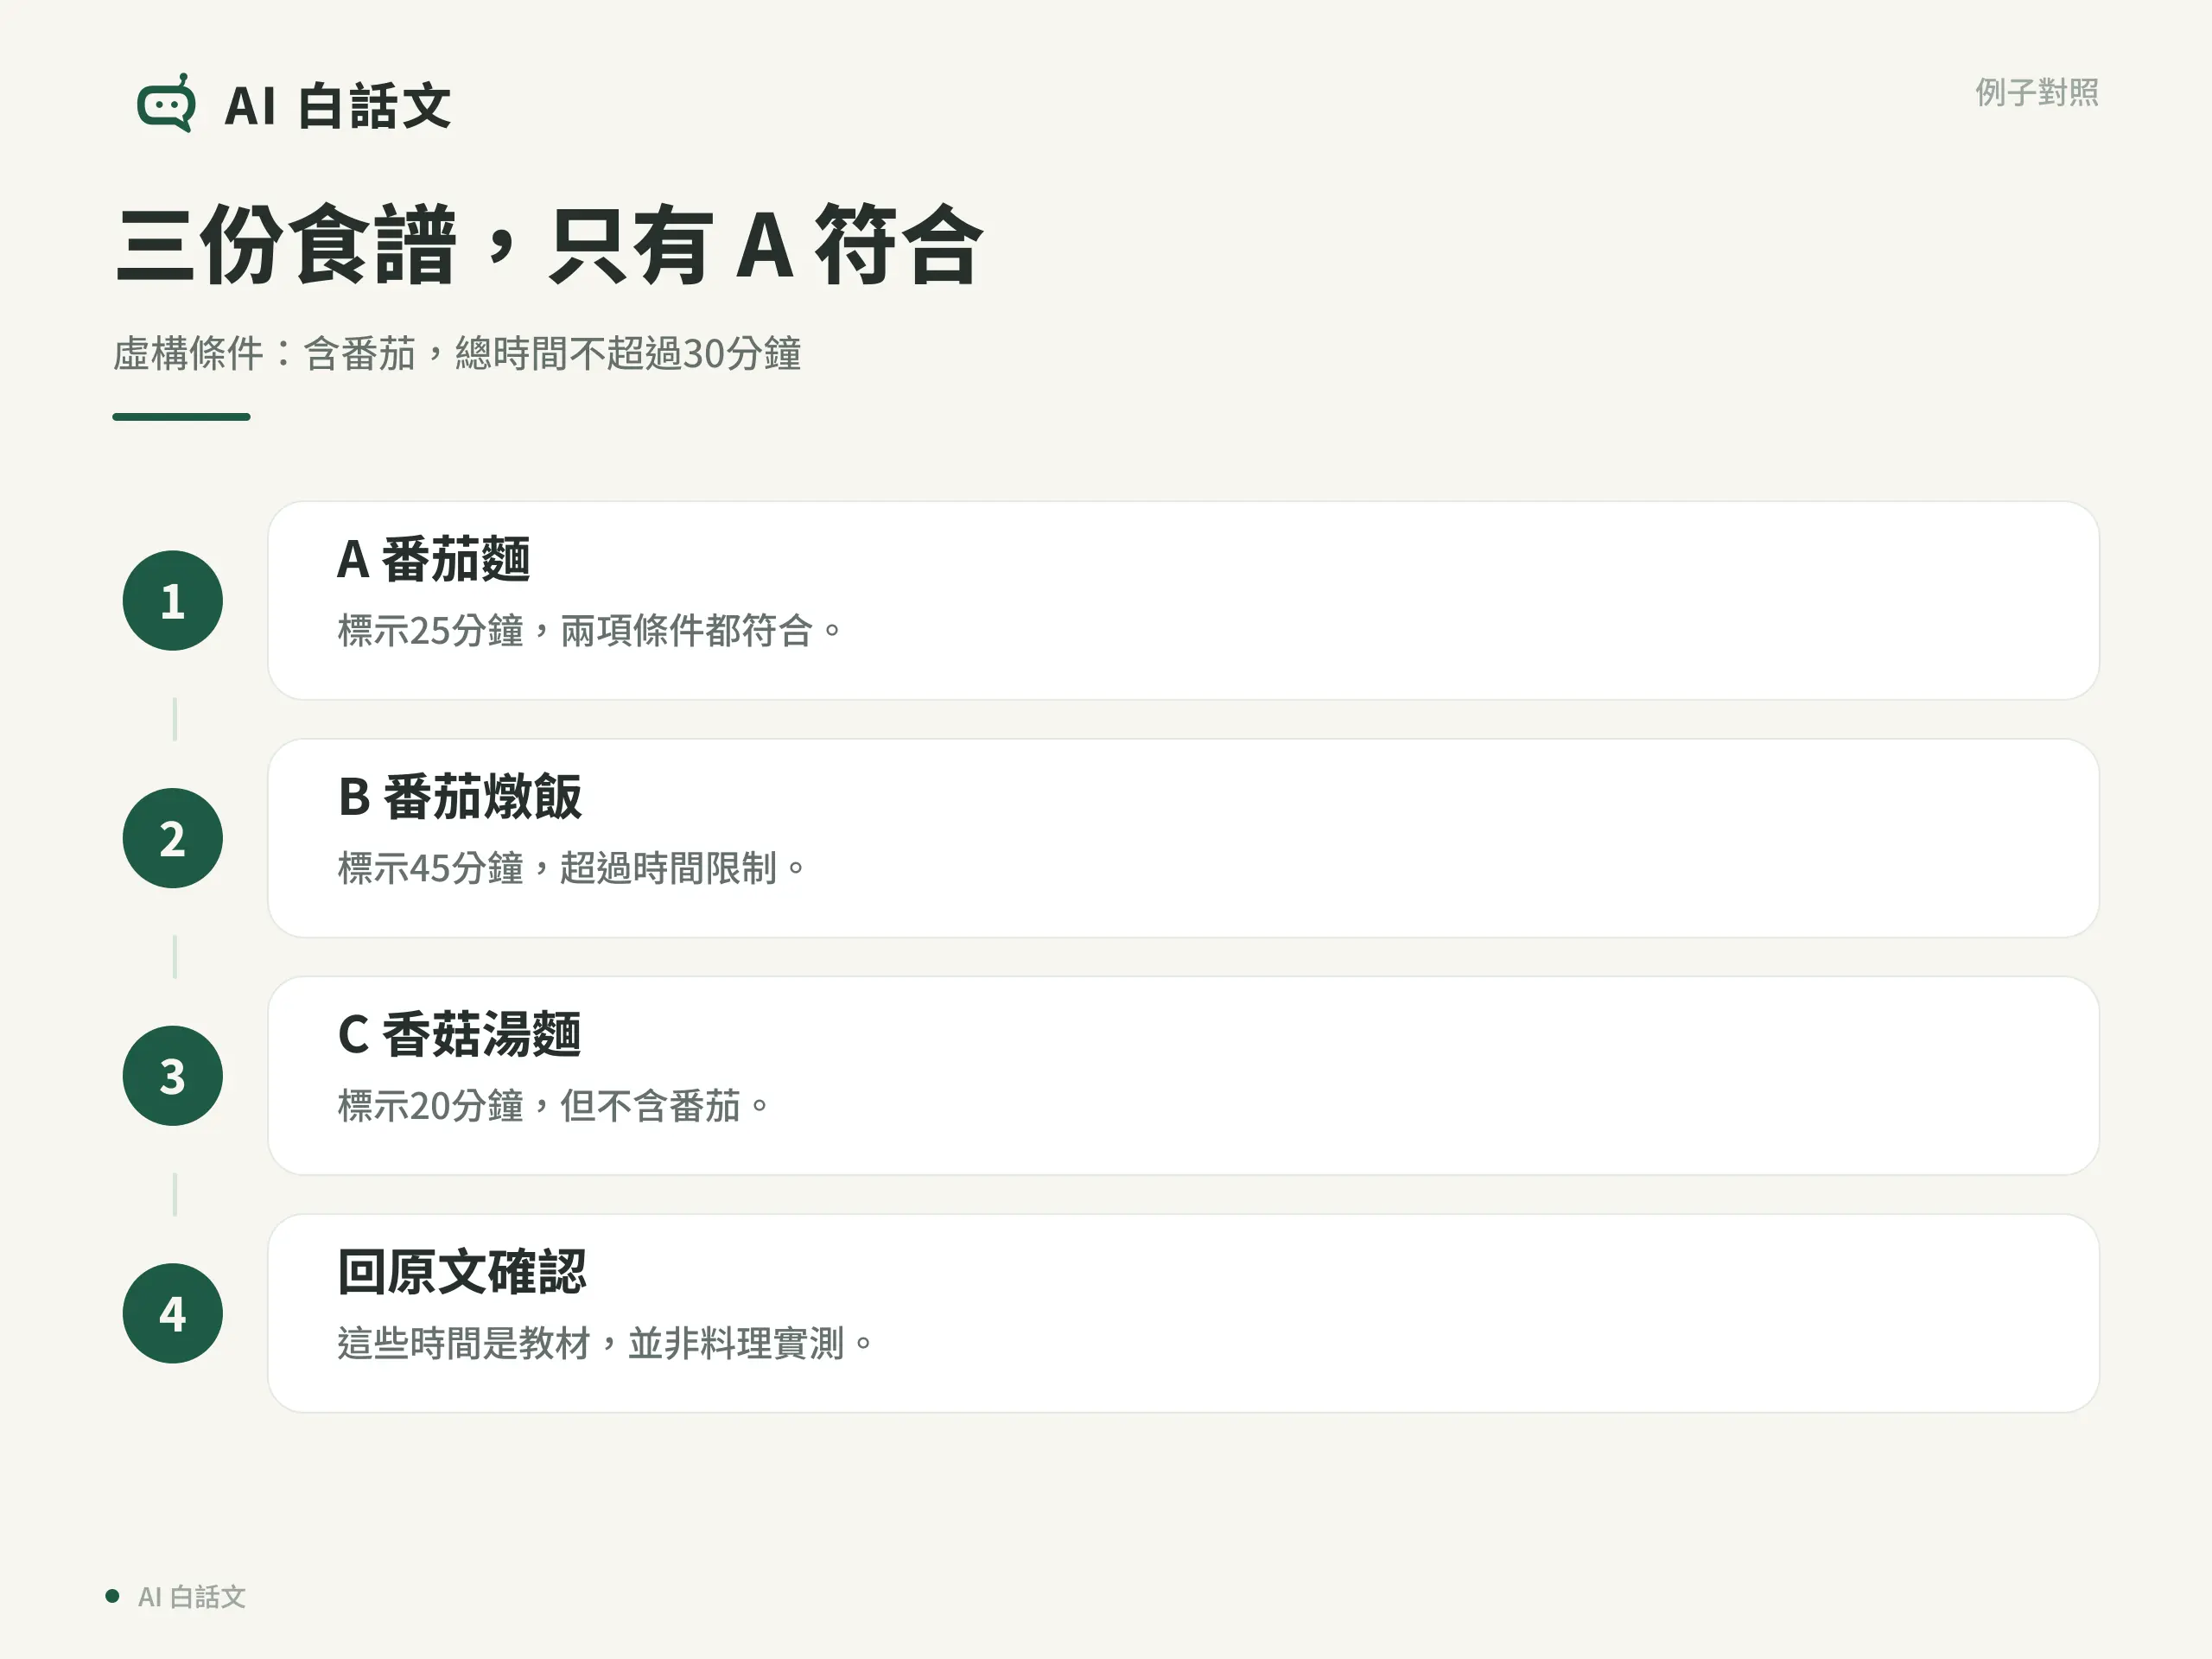
- A,番茄義大利麵:含番茄、麵條與起司;標示總時間 25 分鐘。
- B,番茄燉飯:含番茄、白米與起司;標示總時間 45 分鐘。
- C,香菇湯麵:含香菇與麵條,不含番茄;標示總時間 20 分鐘。
你問「想用番茄做半小時內完成的晚餐」。相似搜尋可能先找到與番茄料理相關的 A、B;但只看主題,仍無法排除要 45 分鐘的 B。
這些只是可能被找出的候選示例,不是對特定資料庫測出的排序。實際結果會受到資料、模型與搜尋方式影響。
意思相近,和符合條件,是兩件事
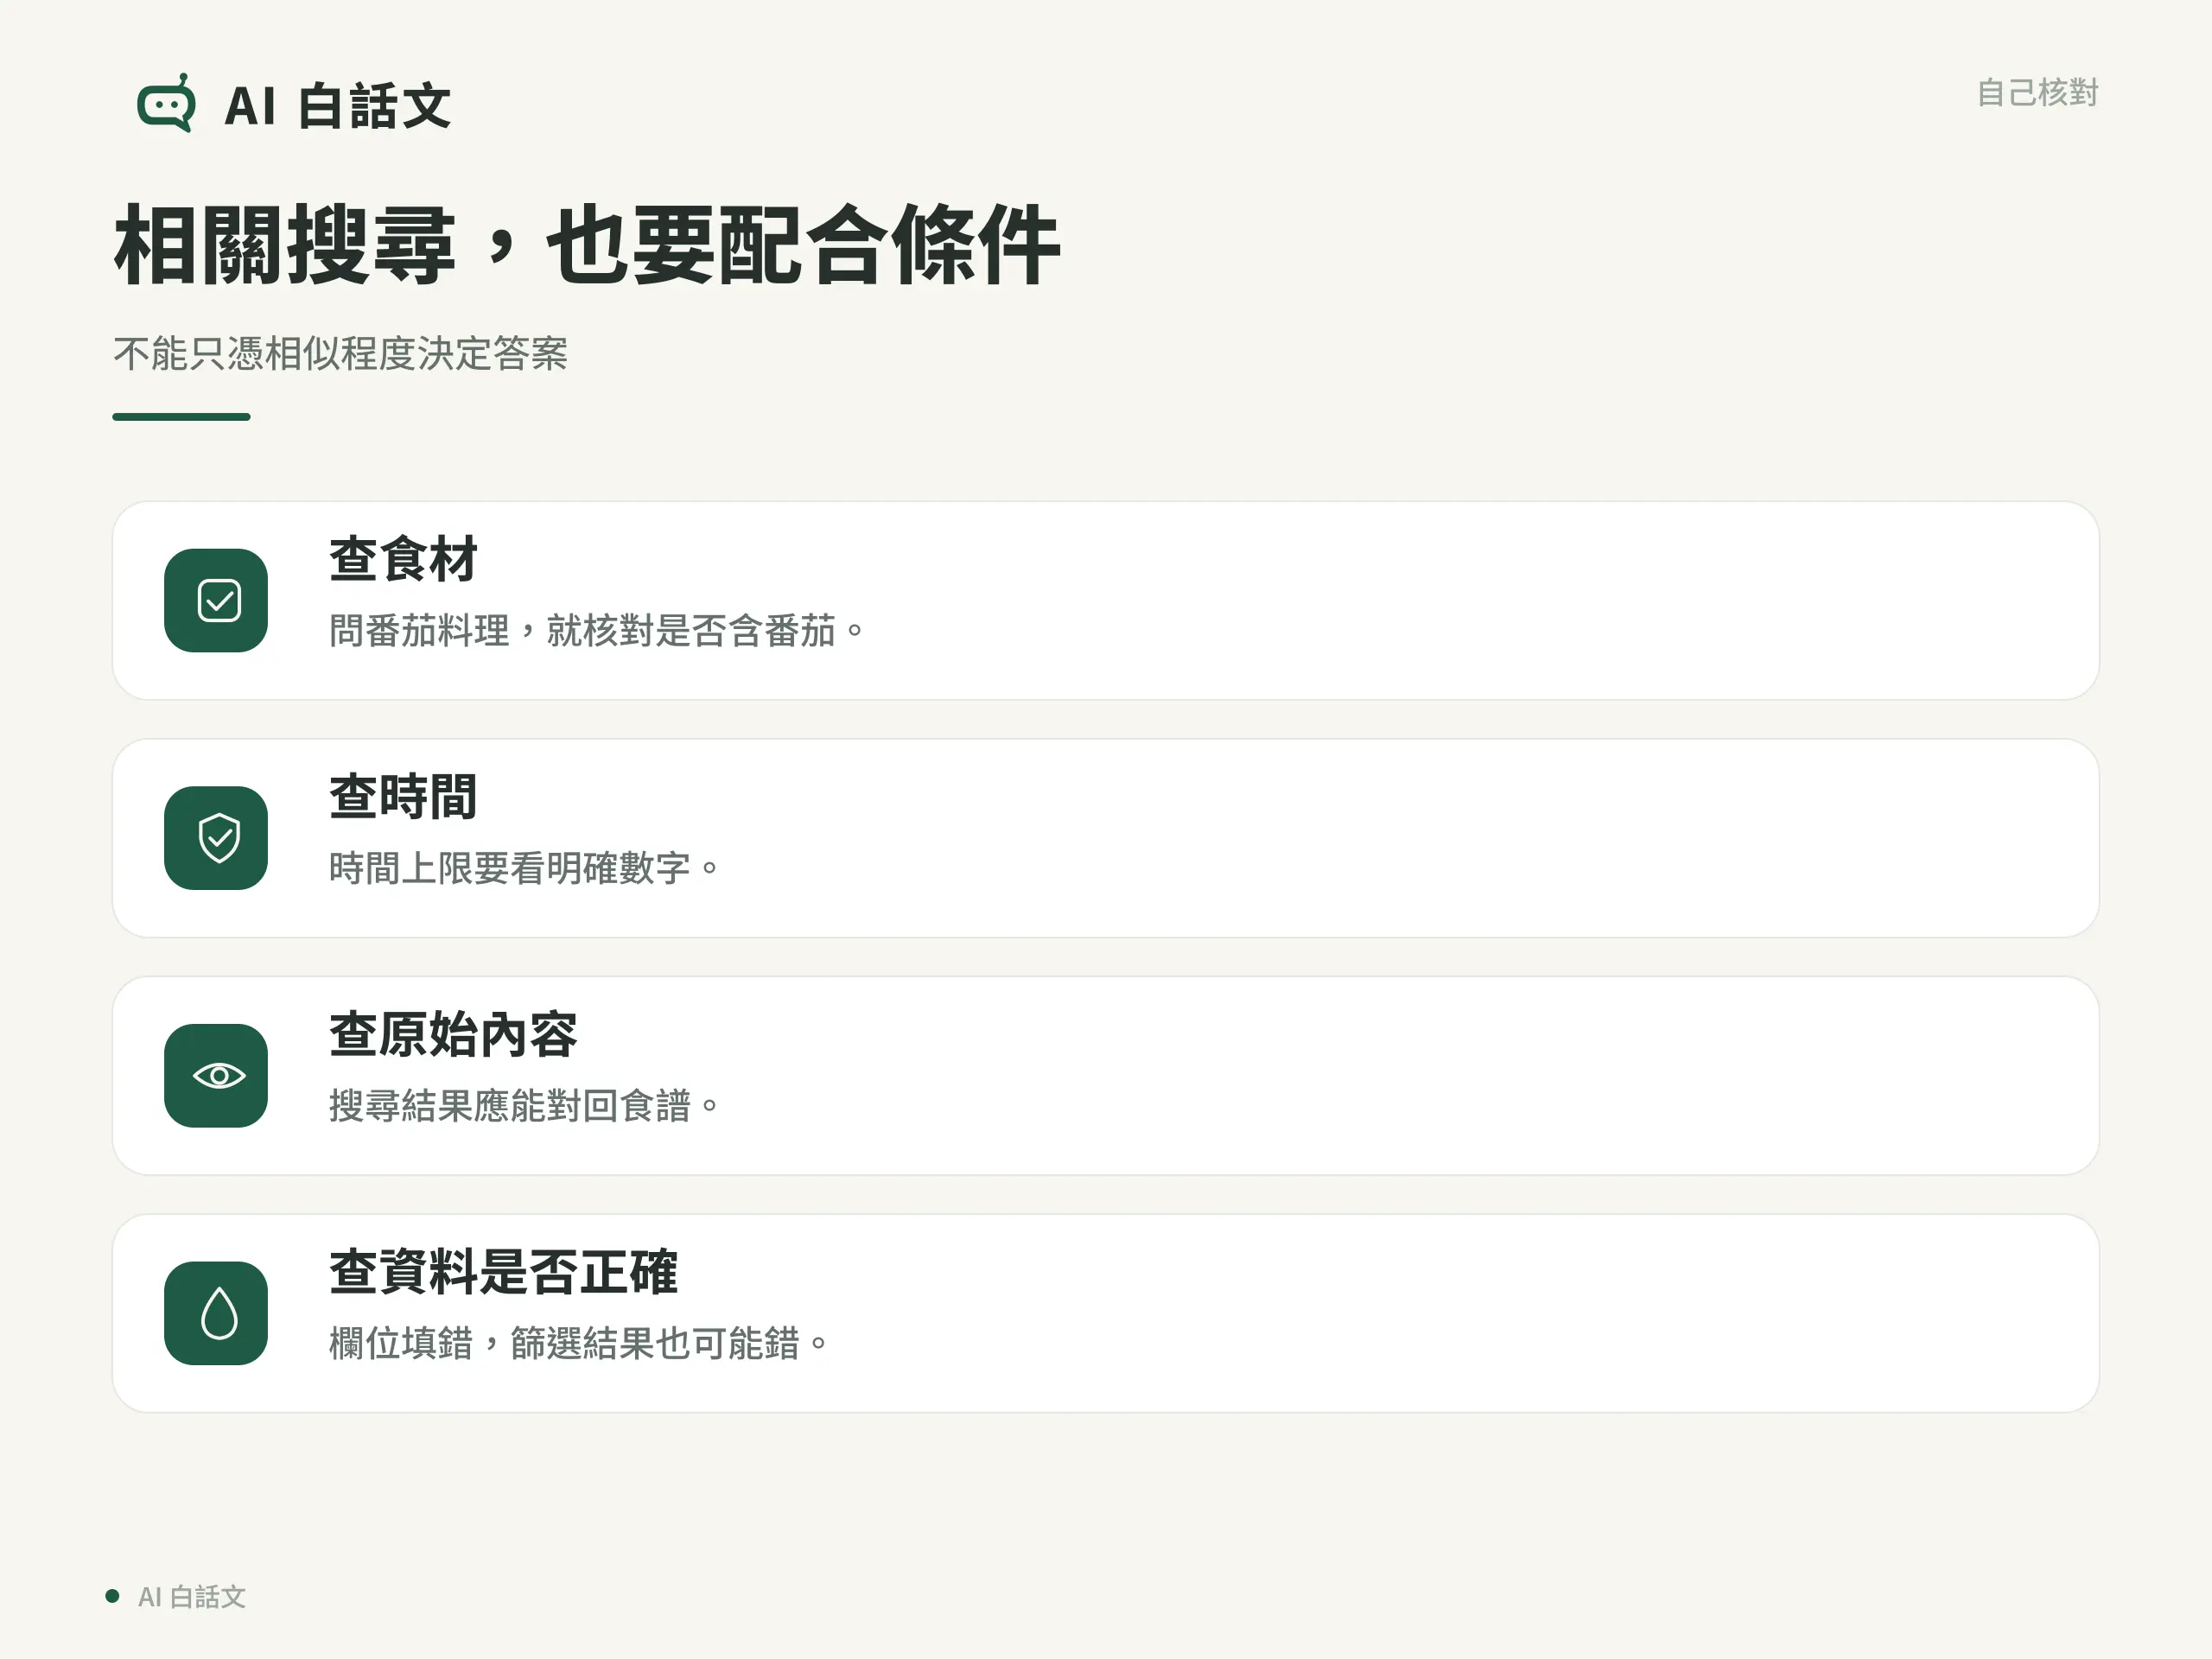
本例有兩個明確條件:含番茄,而且標示總時間不超過 30 分鐘。依這份虛構清單逐項核對,A 符合;B 超時;C 雖然快,卻不含番茄。
若資料保存了「是否含番茄」「總時間」這些欄位,系統便能用欄位篩選,搭配相似搜尋縮小範圍。這些附帶欄位有時叫做中繼資料,在這裡就是幫助描述與篩選食譜的資訊。
Pinecone 的說明也區分向量搜尋與附帶資料的過濾。重點是:不能用「很相似」代替「符合三十分鐘內」這種明確條件,欄位本身也必須填對。
它在 AI 問答裡負責哪一段?
以食譜助手為例,可以把工作分成三件事:
- Embedding 模型:把食譜與問題轉成可比較的數字表示。
- 向量資料庫:保存表示、找出相關食譜,並依支援的欄位條件篩選。
- 回答用的 AI:讀取找到的食譜,整理成你看得懂的建議。
資料庫找出 A,並不等於已經寫好一份料理建議。如果後面再讓 AI 根據 A 的原文回答,這種「找資料後生成回答」的做法,可以用來構成 RAG。
三者各有分工,不能把 Embedding、向量資料庫與 RAG 當成同一個東西的三種名稱。
一般使用者需要自己架一個嗎?
如果你只是問一份短食譜,通常先把內容提供給能讀取它的工具,就能練習依據資料問答。要從很多份資料反覆找相似內容時,這類搜尋能力才比較容易顯出用途。
你不必先選資料庫品牌,才能學會用 AI。使用已有知識庫功能的工具時,先檢查它找出的食譜是否正確、時間是否符合、能否打開原文,比記住一串資料庫名稱更直接。
再好的搜尋系統,也無法讓寫錯的 25 分鐘變成真實時間。真實使用時仍要看食材份量、步驟與自己的準備情況;這也是為什麼本例的數字只能用來練習條件比較。
總結
向量資料庫幫忙管理並找出相關內容。用食譜例子記住它的邊界:主題相近可以幫你找候選,但是否含番茄、是否超過時間,仍需要明確資料和條件核對。
參考資料
重點整理
向量資料庫本身會像聊天機器人一樣回答嗎?
它的核心工作是管理與搜尋向量及相關資料。若要寫出自然語言回答,通常還要和能生成文字的 AI 等其他元件搭配。
相似搜尋能取代所有關鍵字和條件搜尋嗎?
不能。編號、日期、金額或時間上限等明確條件,仍需要精確比對或欄位篩選。實際系統常會搭配不同搜尋方式。
向量資料庫和 RAG 是同一件事嗎?
不是。向量資料庫可協助找資料,RAG 則是取得相關資料後再生成回答的流程;RAG 也不一定只用向量搜尋。