內容目錄
顯示
AI 偏誤是 AI 的結果反覆偏向某些群體、情境或觀點,讓其他人的需求或經驗被忽略。這種傾向可能來自資料、設計,也可能被使用者的問法放大。它和偶爾一次的隨機錯誤不同,也不一定會以明顯歧視文字出現。
一個系統的整體準確率看起來很好,仍可能對某些年齡、地區、語言或背景的人經常判錯。若 AI 被用在求職、教育、信用、醫療或資源分配,偏誤可能直接影響人的權益。
AI 偏誤是什麼?
AI 偏誤的定義:它是結果反覆出現某種偏向。一次回答不合用,還不足以判定整個模型有同樣的偏誤;要進一步比較不同情境與資料。
假設一個辨識制服的系統,大多使用同一國家、同一年齡學生的照片訓練。它在測試資料上表現很好,到了不同地區、不同制服款式的學校,卻經常辨識失敗。這可能不是因為那些學生特別難辨識,而是資料代表性不足。
再例如,請 AI 列出「成功企業家的典型特徵」。如果資料長期集中在某些產業、國家與性別,它可能把這些常見樣本誤寫成成功的必要條件,忽略沒有被充分記錄的人。
偏誤和幻覺有什麼不同?
| 問題 | 主要特徵 | 例子 |
|---|---|---|
| 幻覺 | 內容錯誤、無根據或不存在 | 捏造一篇論文 |
| 偏誤 | 結果反覆偏向某些群體或觀點 | 求職篩選對某類背景的人較不利 |
兩者可以同時發生。AI 可能捏造事實,也可能用帶偏向的方式解釋。查核來源能處理部分幻覺,但要找偏誤,還需要比較不同群體、不同問法和被遺漏的觀點。
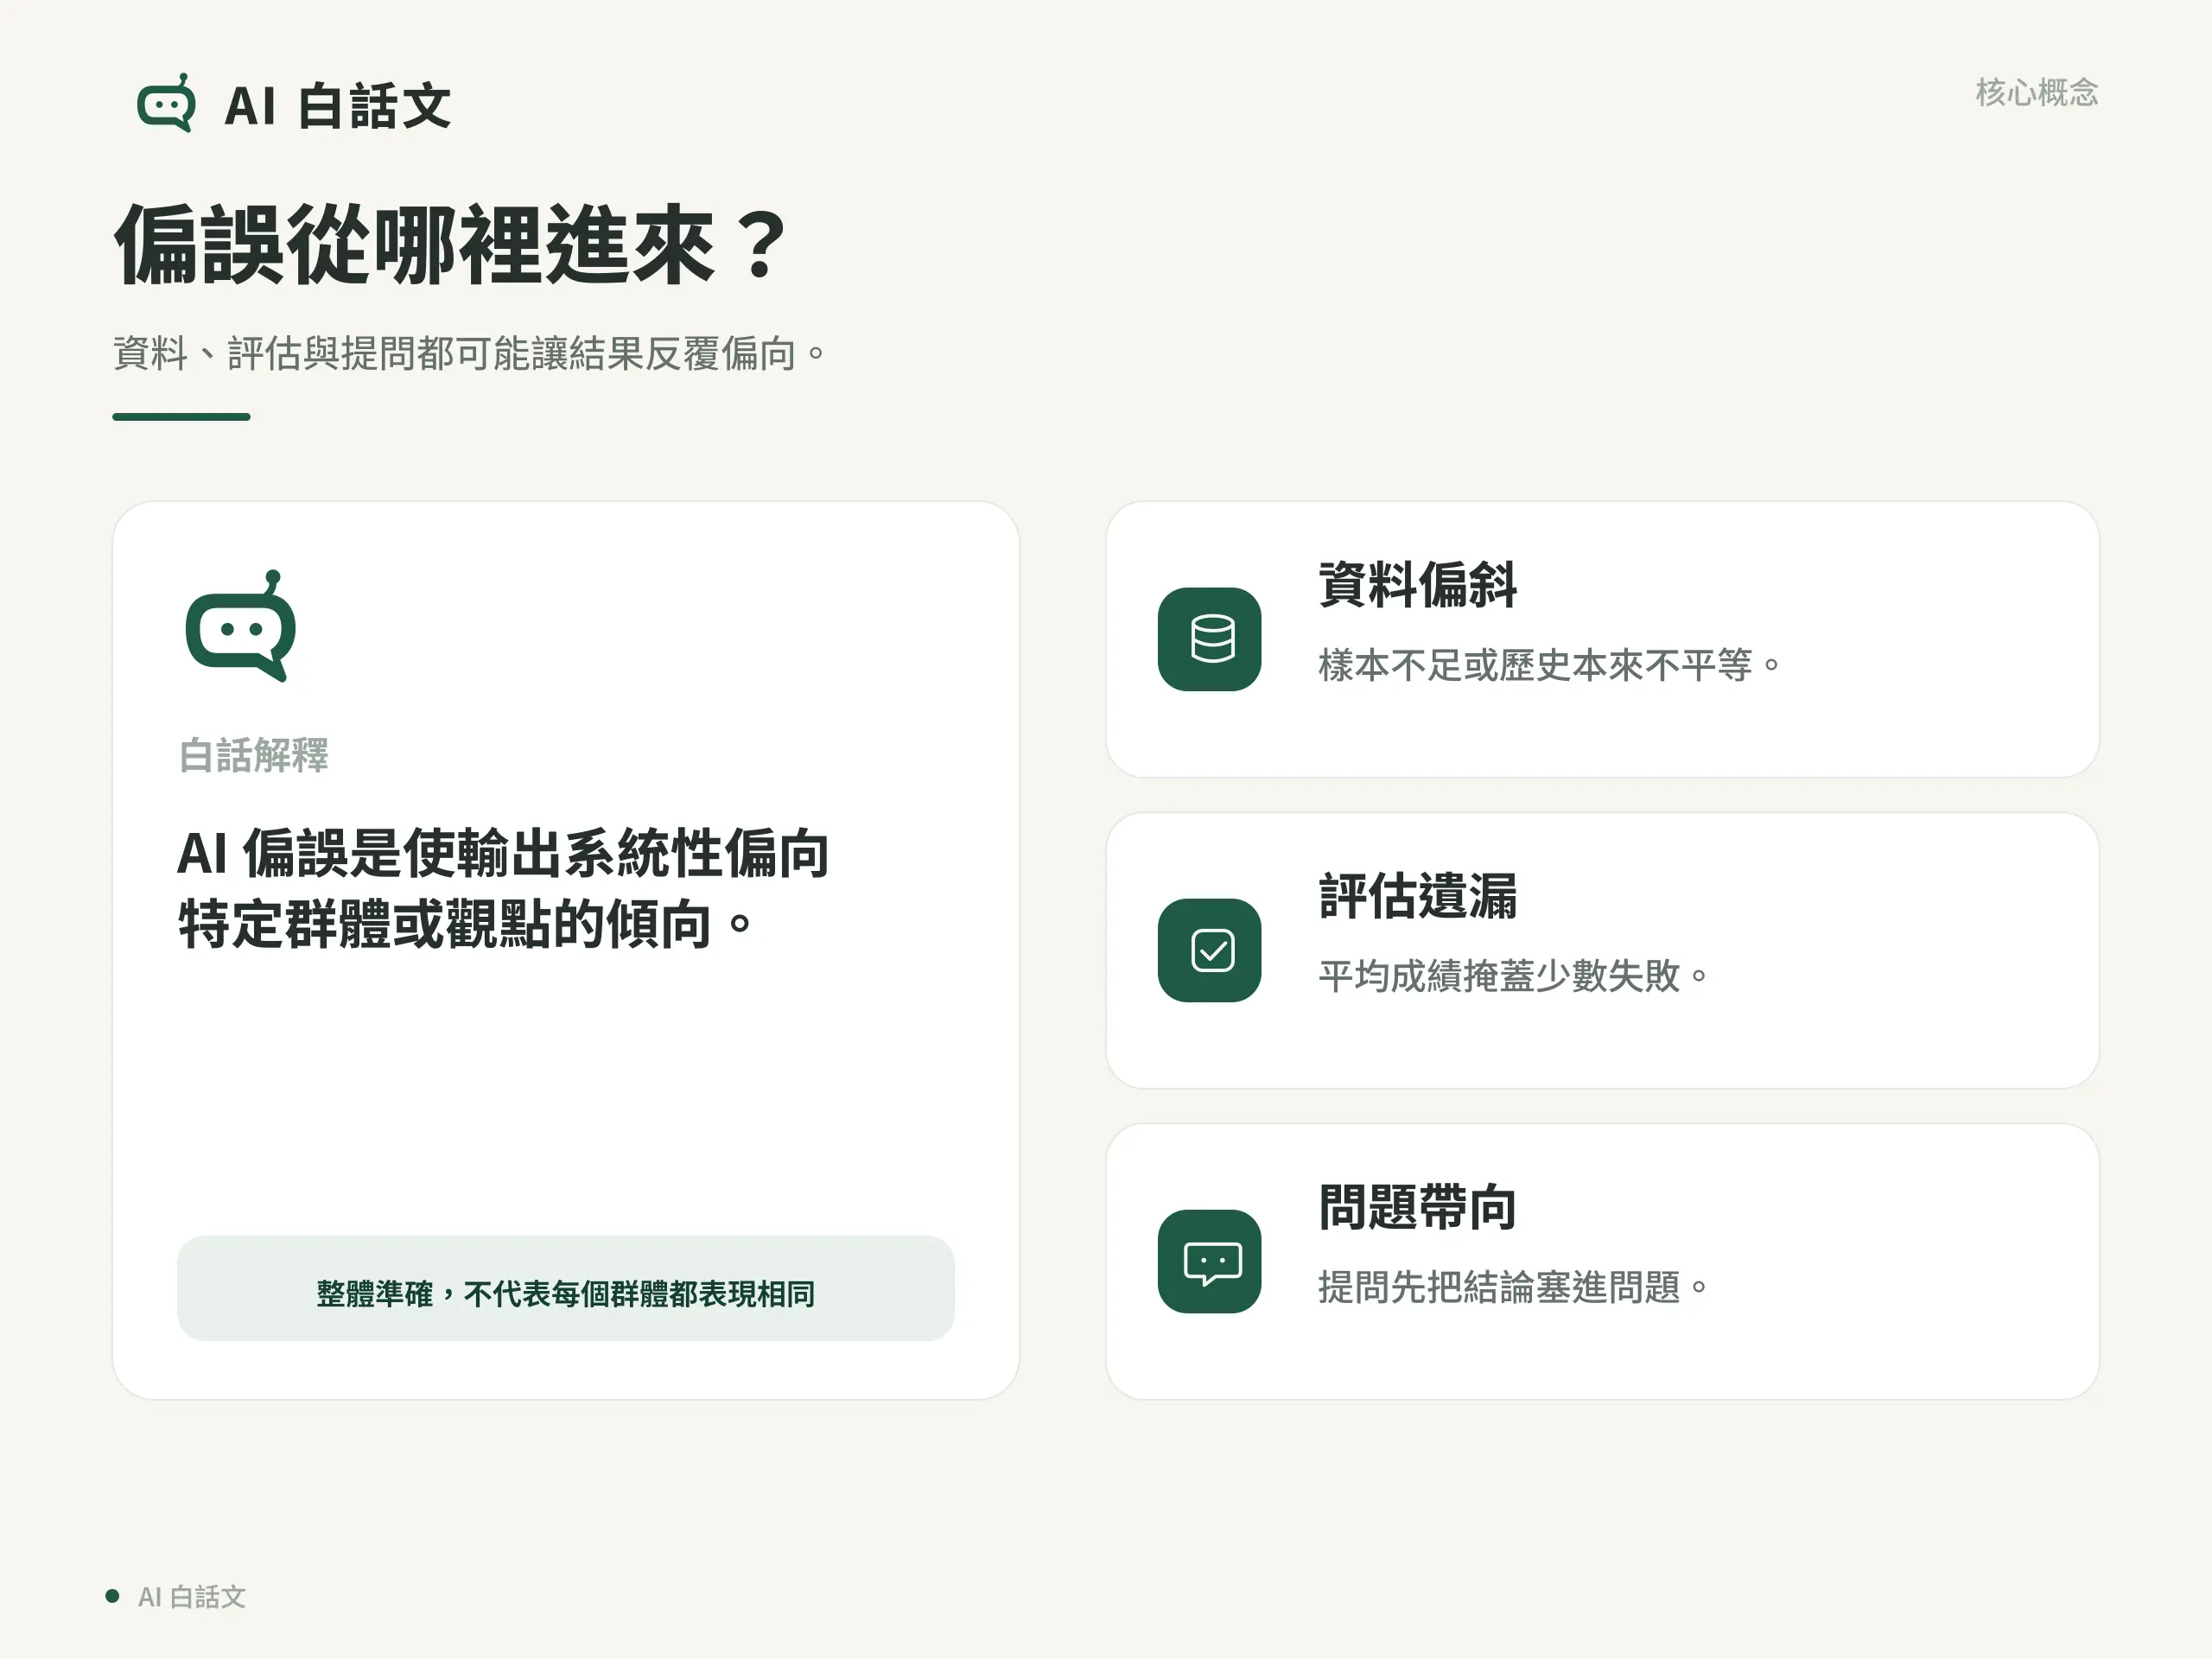
偏誤可能從哪裡來?
歷史資料
資料記錄的是過去世界,不一定代表理想或現在的狀況。若過去本來就有不平等,模型可能把它學成規律。
樣本不足或失衡
某些地區、語言、年齡或情境資料太少,模型對它們的表現可能比較差。大量資料不代表每個重要群體都有足夠代表。
標記方式
人要先決定什麼叫「好」「危險」「適合」或「成功」。標準若含模糊主觀判斷,偏向就可能進入資料。
設計與評估
如果只看整體平均,就可能掩蓋少數情況的失敗。Google 的公平性教材也提醒,要檢查重要子群體,而不是只看總成績。
使用者提問
問題本身可能先假設一個立場。例如「為什麼遠距工作一定讓效率下降?」已經把結論塞進問題。AI 若順著回答,會讓偏向看起來更合理。
一般使用者怎麼降低偏誤?
先找出問題裡的假設
把「為什麼 A 比 B 好?」改成「比較 A 與 B 在不同情境的優點、缺點和所需證據」。
要求列出被忽略的觀點
可以問:「這個答案主要代表哪些人的經驗?哪些地區、族群或情境可能不適用?」這不能保證消除偏誤,但能幫你找盲點。
比較同一問題的不同寫法
把人名、性別或地區替換後再問,觀察建議是否不合理地改變。這是簡單的對照測試。
看資料,不只看文字
如果 AI 說「大多數人」「通常比較好」,要求提供樣本、地區、期間和原始來源。沒有資料就把句子改成假設,不要當結論。
找真正受影響的人檢查
AI 可以列出可能觀點,但不能代替當事人的經驗。涉及校規、無障礙、族群文化或工作制度時,要讓受影響的人參與。
完整例子:週末活動漏掉了誰?
假設你請 AI 想團體活動,它只列出登山、跑步和健行。這不代表活動本身不好,但答案可能預設每個人都能長時間走路。以下是用來找出遺漏需求的教學示例,並非模型實測。
參加者的體力不同,請同時列出室內與戶外活動。每項說明是否需要長時間走路、可能有哪些費用;不知道實際金額就寫待確認,不要預設所有人都適合運動。
檢查方向可以是:室內下棋或讀書分享通常不需要長時間走路,但要確認場地與費用;戶外短程散步則要確認路面、距離、休息點及參加者意願。這些是待討論的選項,不是替所有人決定行程。
最後把選項交給實際參加的人確認。補上不同需求可以改善這次回答,卻不能據此宣稱模型從此沒有偏誤。
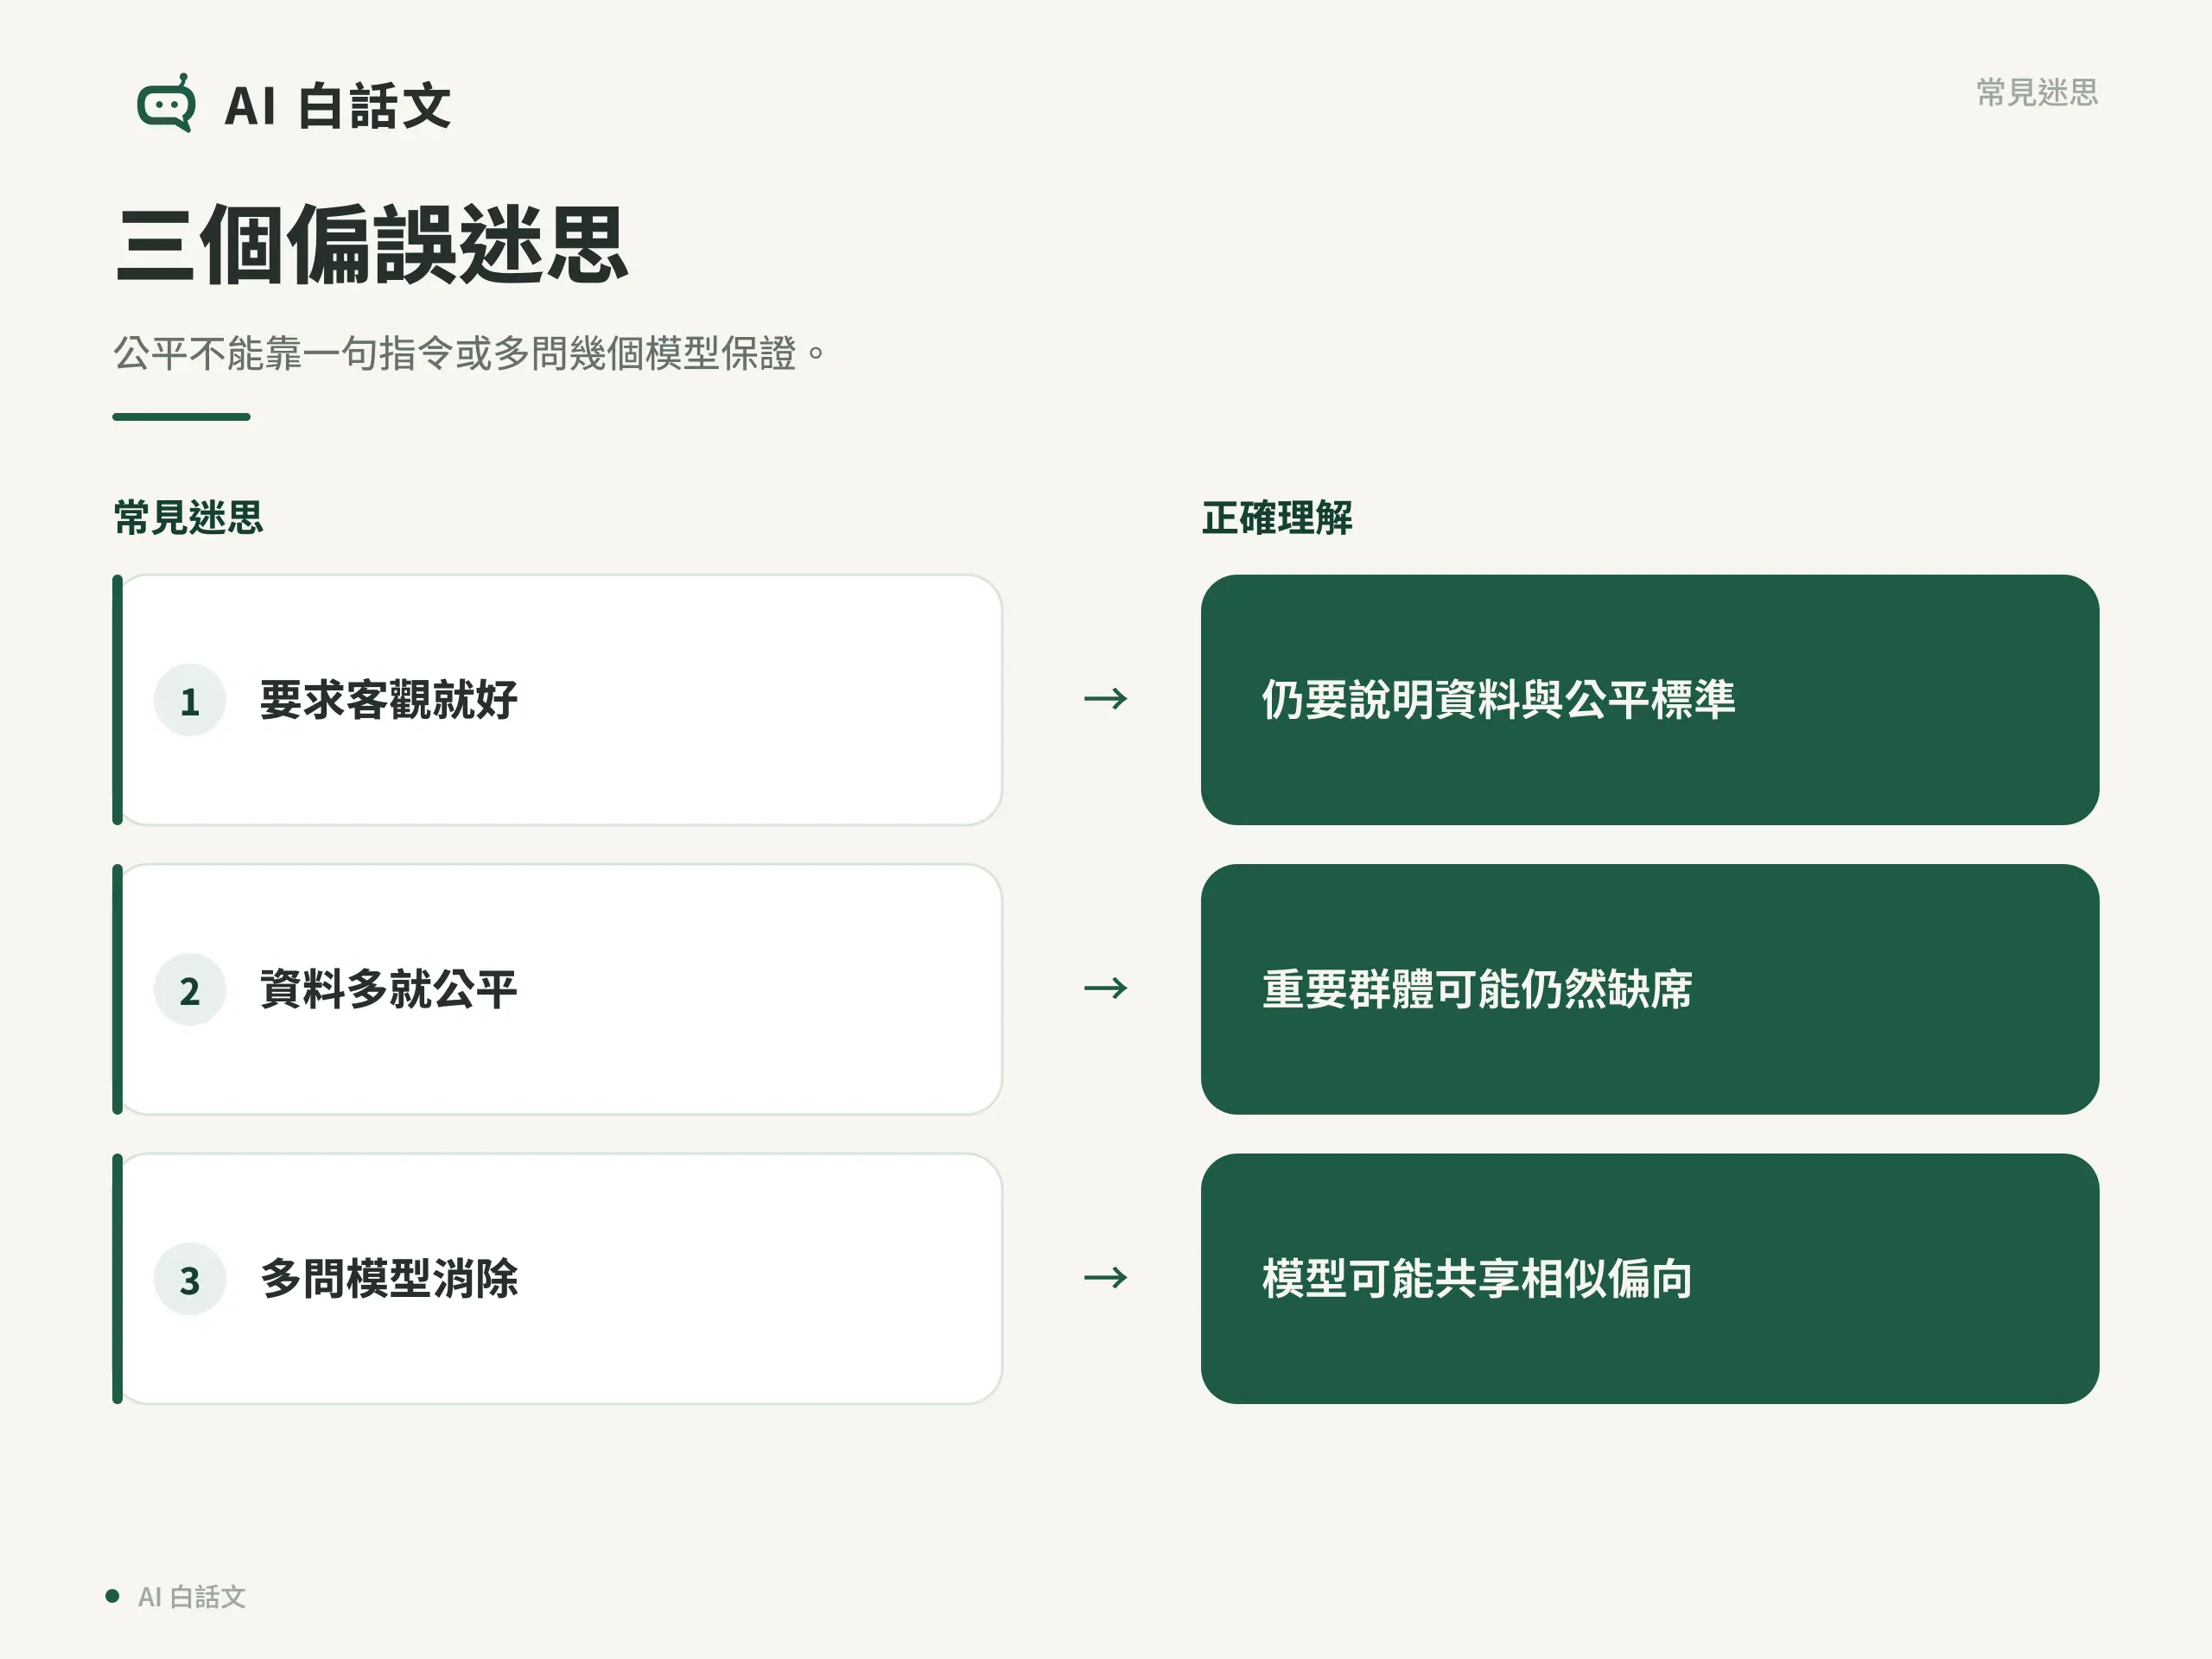
「要求客觀」為什麼不夠?
客觀不是一句指令就能產生的狀態。模型不知道你要依據哪一套資料、如何衡量公平,也不知道哪些群體在資料中缺席。
可以把提示詞,也就是你交給 AI 的要求,寫得更具體:
請把事實、資料來源、推論與價值判斷分開。列出這份資料的地區、期間和樣本限制;至少提出兩種合理解釋,並說明還缺哪些證據才能判斷。
這仍然不是中立保證,但至少讓答案更容易被檢查。
涉及別人的機會時,更要問依據
例如 AI 建議某位同學不適合擔任組長,你要追問:依據是實際合作表現,還是只憑性別、年齡或背景推測?沒有充分資料,就不能拿這段回答替一個人貼標籤。
求職、升學等重要決定也一樣。AI 可以協助整理資料,但真正受影響的人應有機會說明情況,負責判斷的人仍需檢查依據。
總結
AI 偏誤可能進入資料、標記、設計、評估、提問和人的使用方式。降低偏誤的重點不是叫 AI「保持中立」,而是拆出假設、查看資料範圍、比較不同群體、測試不同問法,並讓受影響的人和負責的人參與重大決策。
參考資料
重點整理
AI 能完全中立嗎?
很難把「中立」當成單一、永久的狀態。不同情境對公平的定義可能不同。使用時可以先看看答案漏了誰、依據是否只包含一群人,再補上不同情境的資料並核對。
要求 AI 客觀就會客觀嗎?
不會自動達成。要提供資料範圍、區分事實與判斷、要求限制和多種觀點,再由人檢查。
多問幾個模型能消除偏誤嗎?
不同模型可提供比較線索,但可能共享相似資料和主流觀點。多問不是消除偏誤,仍要回到來源、樣本和受影響群體。