內容目錄
顯示
測試時計算(Test-Time Compute)是 AI 模型在處理當前問題時使用的運算。討論「增加測試時計算」,通常是指讓模型在回答當下,多做一些比較、計算或檢查。
這裡的「測試時」不是學校考試,也不只指開發人員測試軟體。你把一題交給訓練好的模型處理,就進入這個階段。
先分清訓練與回答當下
模型是 AI 處理資料的核心。訓練會利用資料調整模型內部的數值;推論則是使用已訓練好的模型處理新輸入、產生結果。
測試時計算談的是後者用了多少運算、怎麼使用。你要求它多比較一個方案,通常不等於重新訓練模型。把長期練習和這次作答分開想,就比較容易理解。
完整例子:單價低就比較便宜嗎?
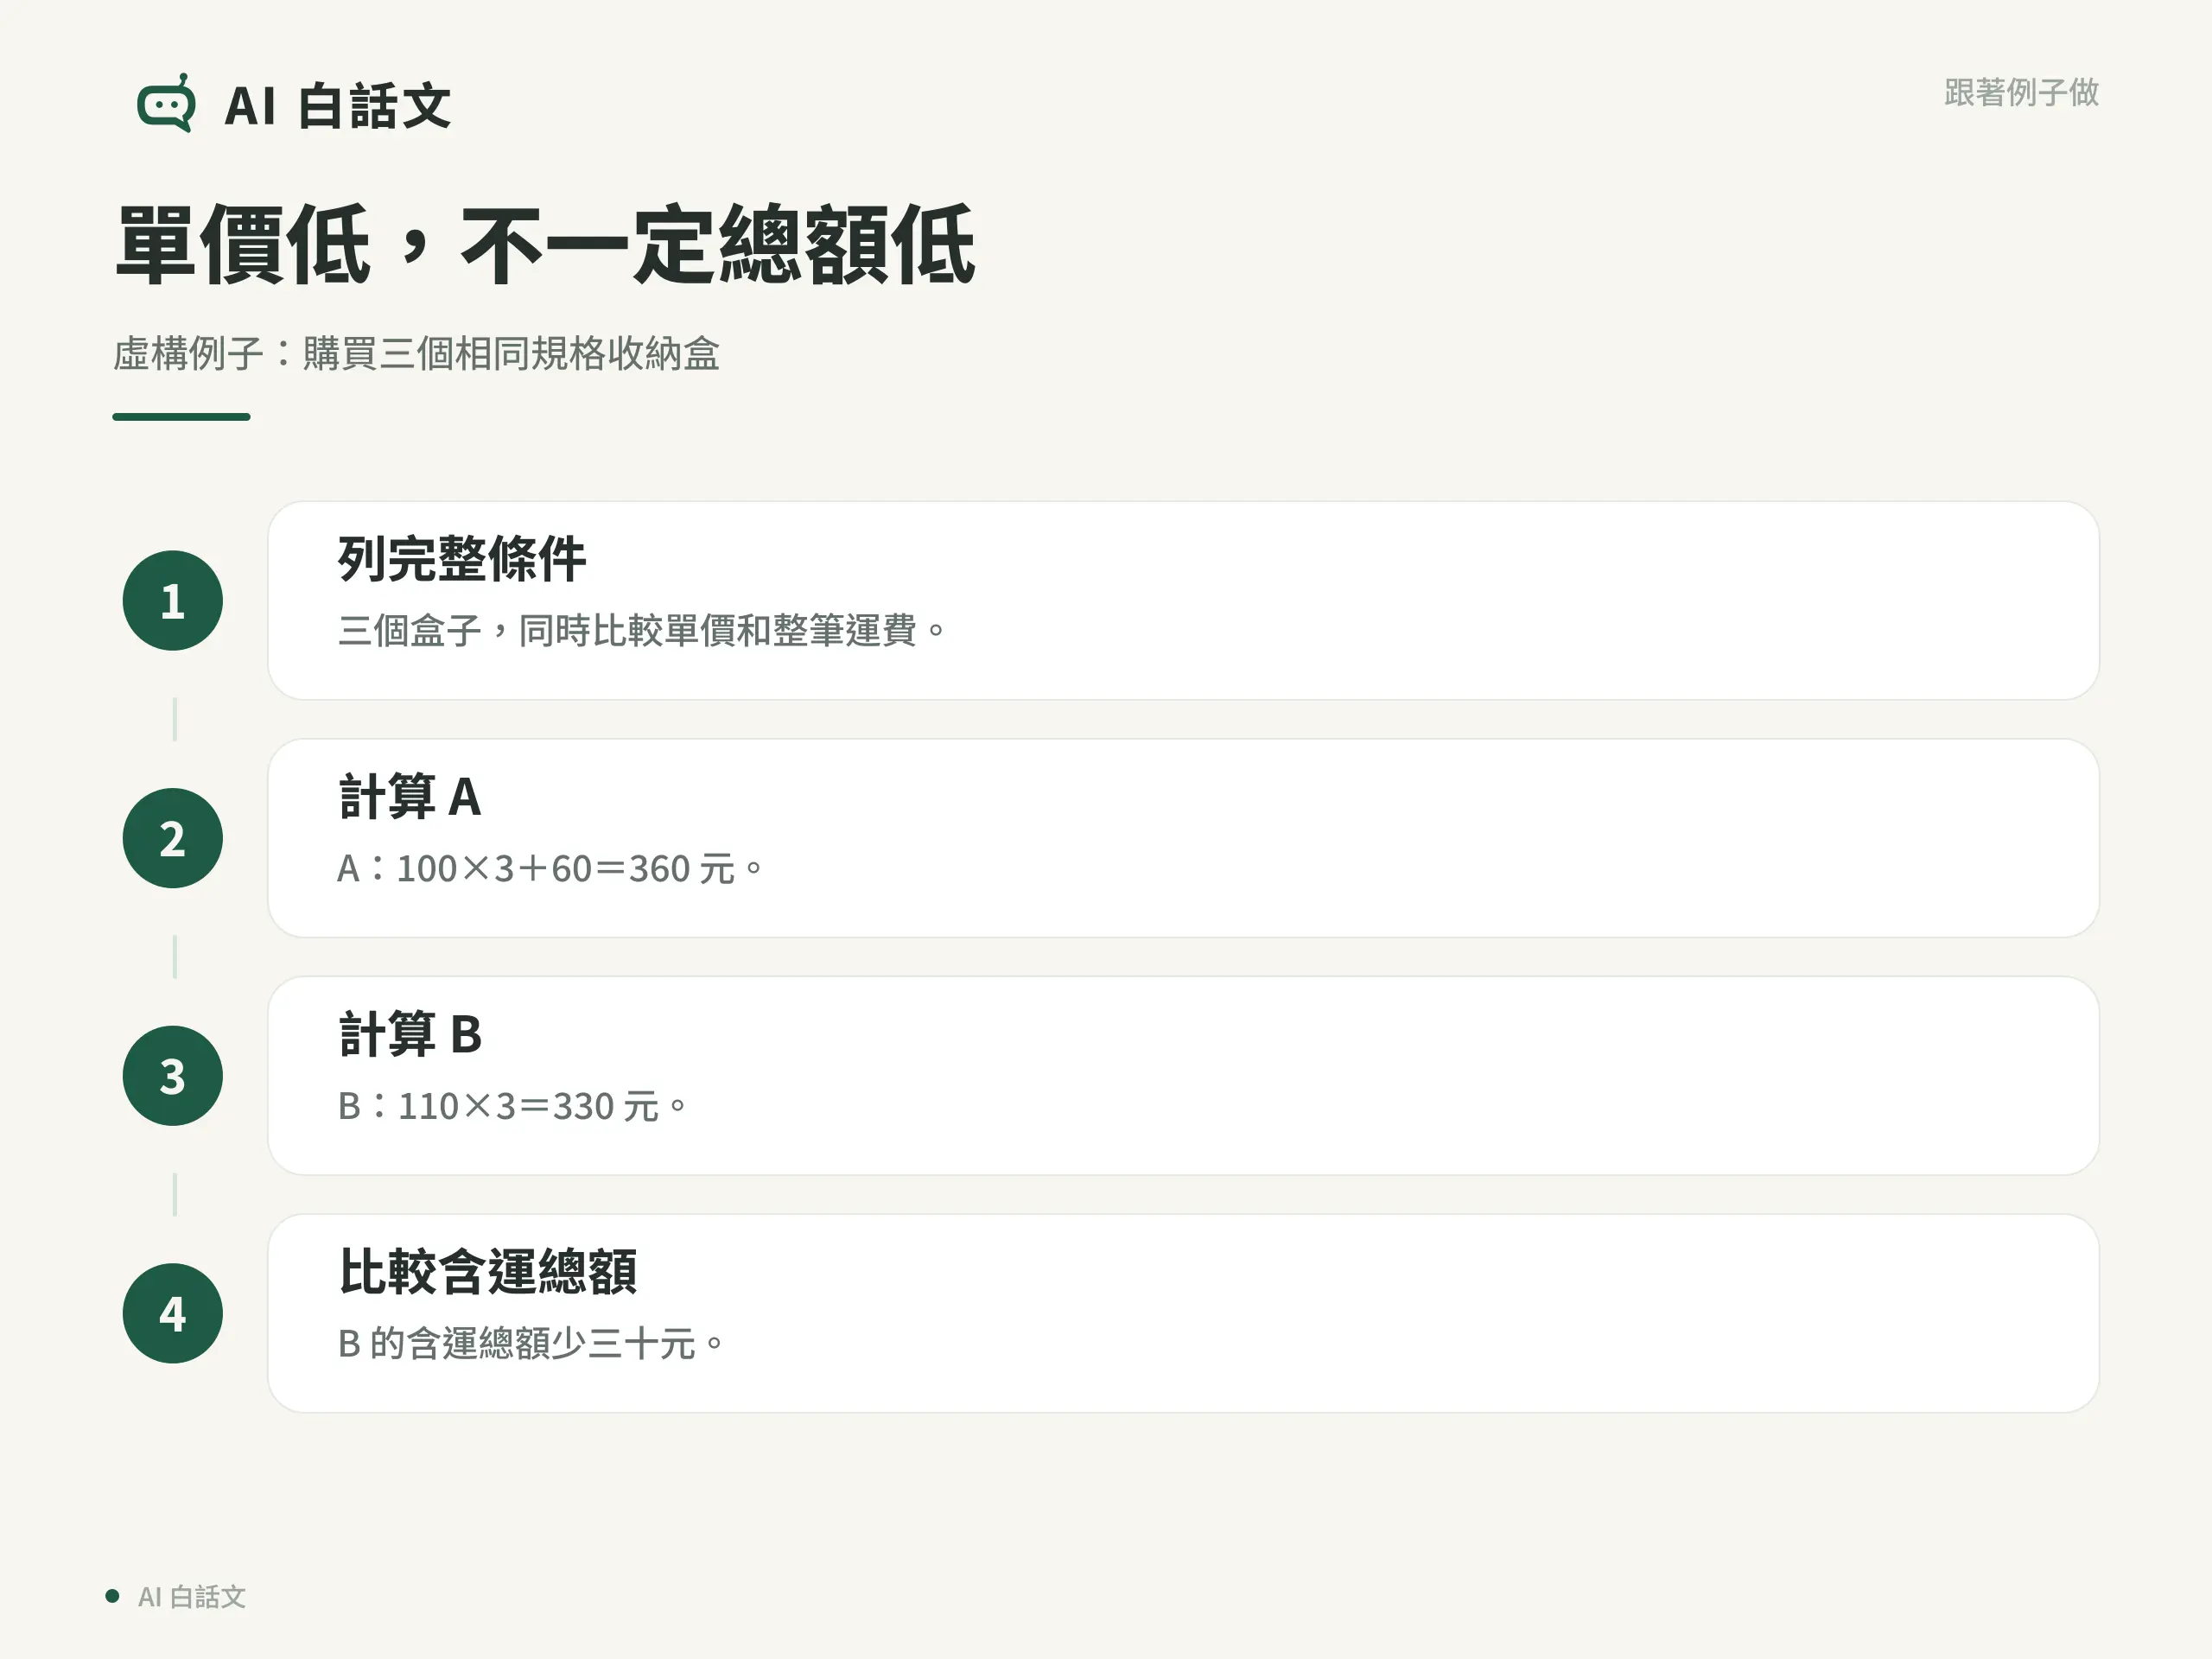
以下商店與價格是虛構教學資料。你要買三個相同規格的收納盒:A 店每個 100 元,整筆運費 60 元;B 店每個 110 元,免運,兩家都沒有其他折扣或費用。
只看單價會覺得 A 便宜。但如果多做一步含運費計算,結果會是:
- A:100×3+60=360 元。
- B:110×3=330 元。
- B 的總費用少 30 元。
這是解題示例,不是模型效能測試。它說明額外檢查可以用在哪裡,不能用來宣稱某產品多算後一定改善。
額外運算可以花在哪裡?
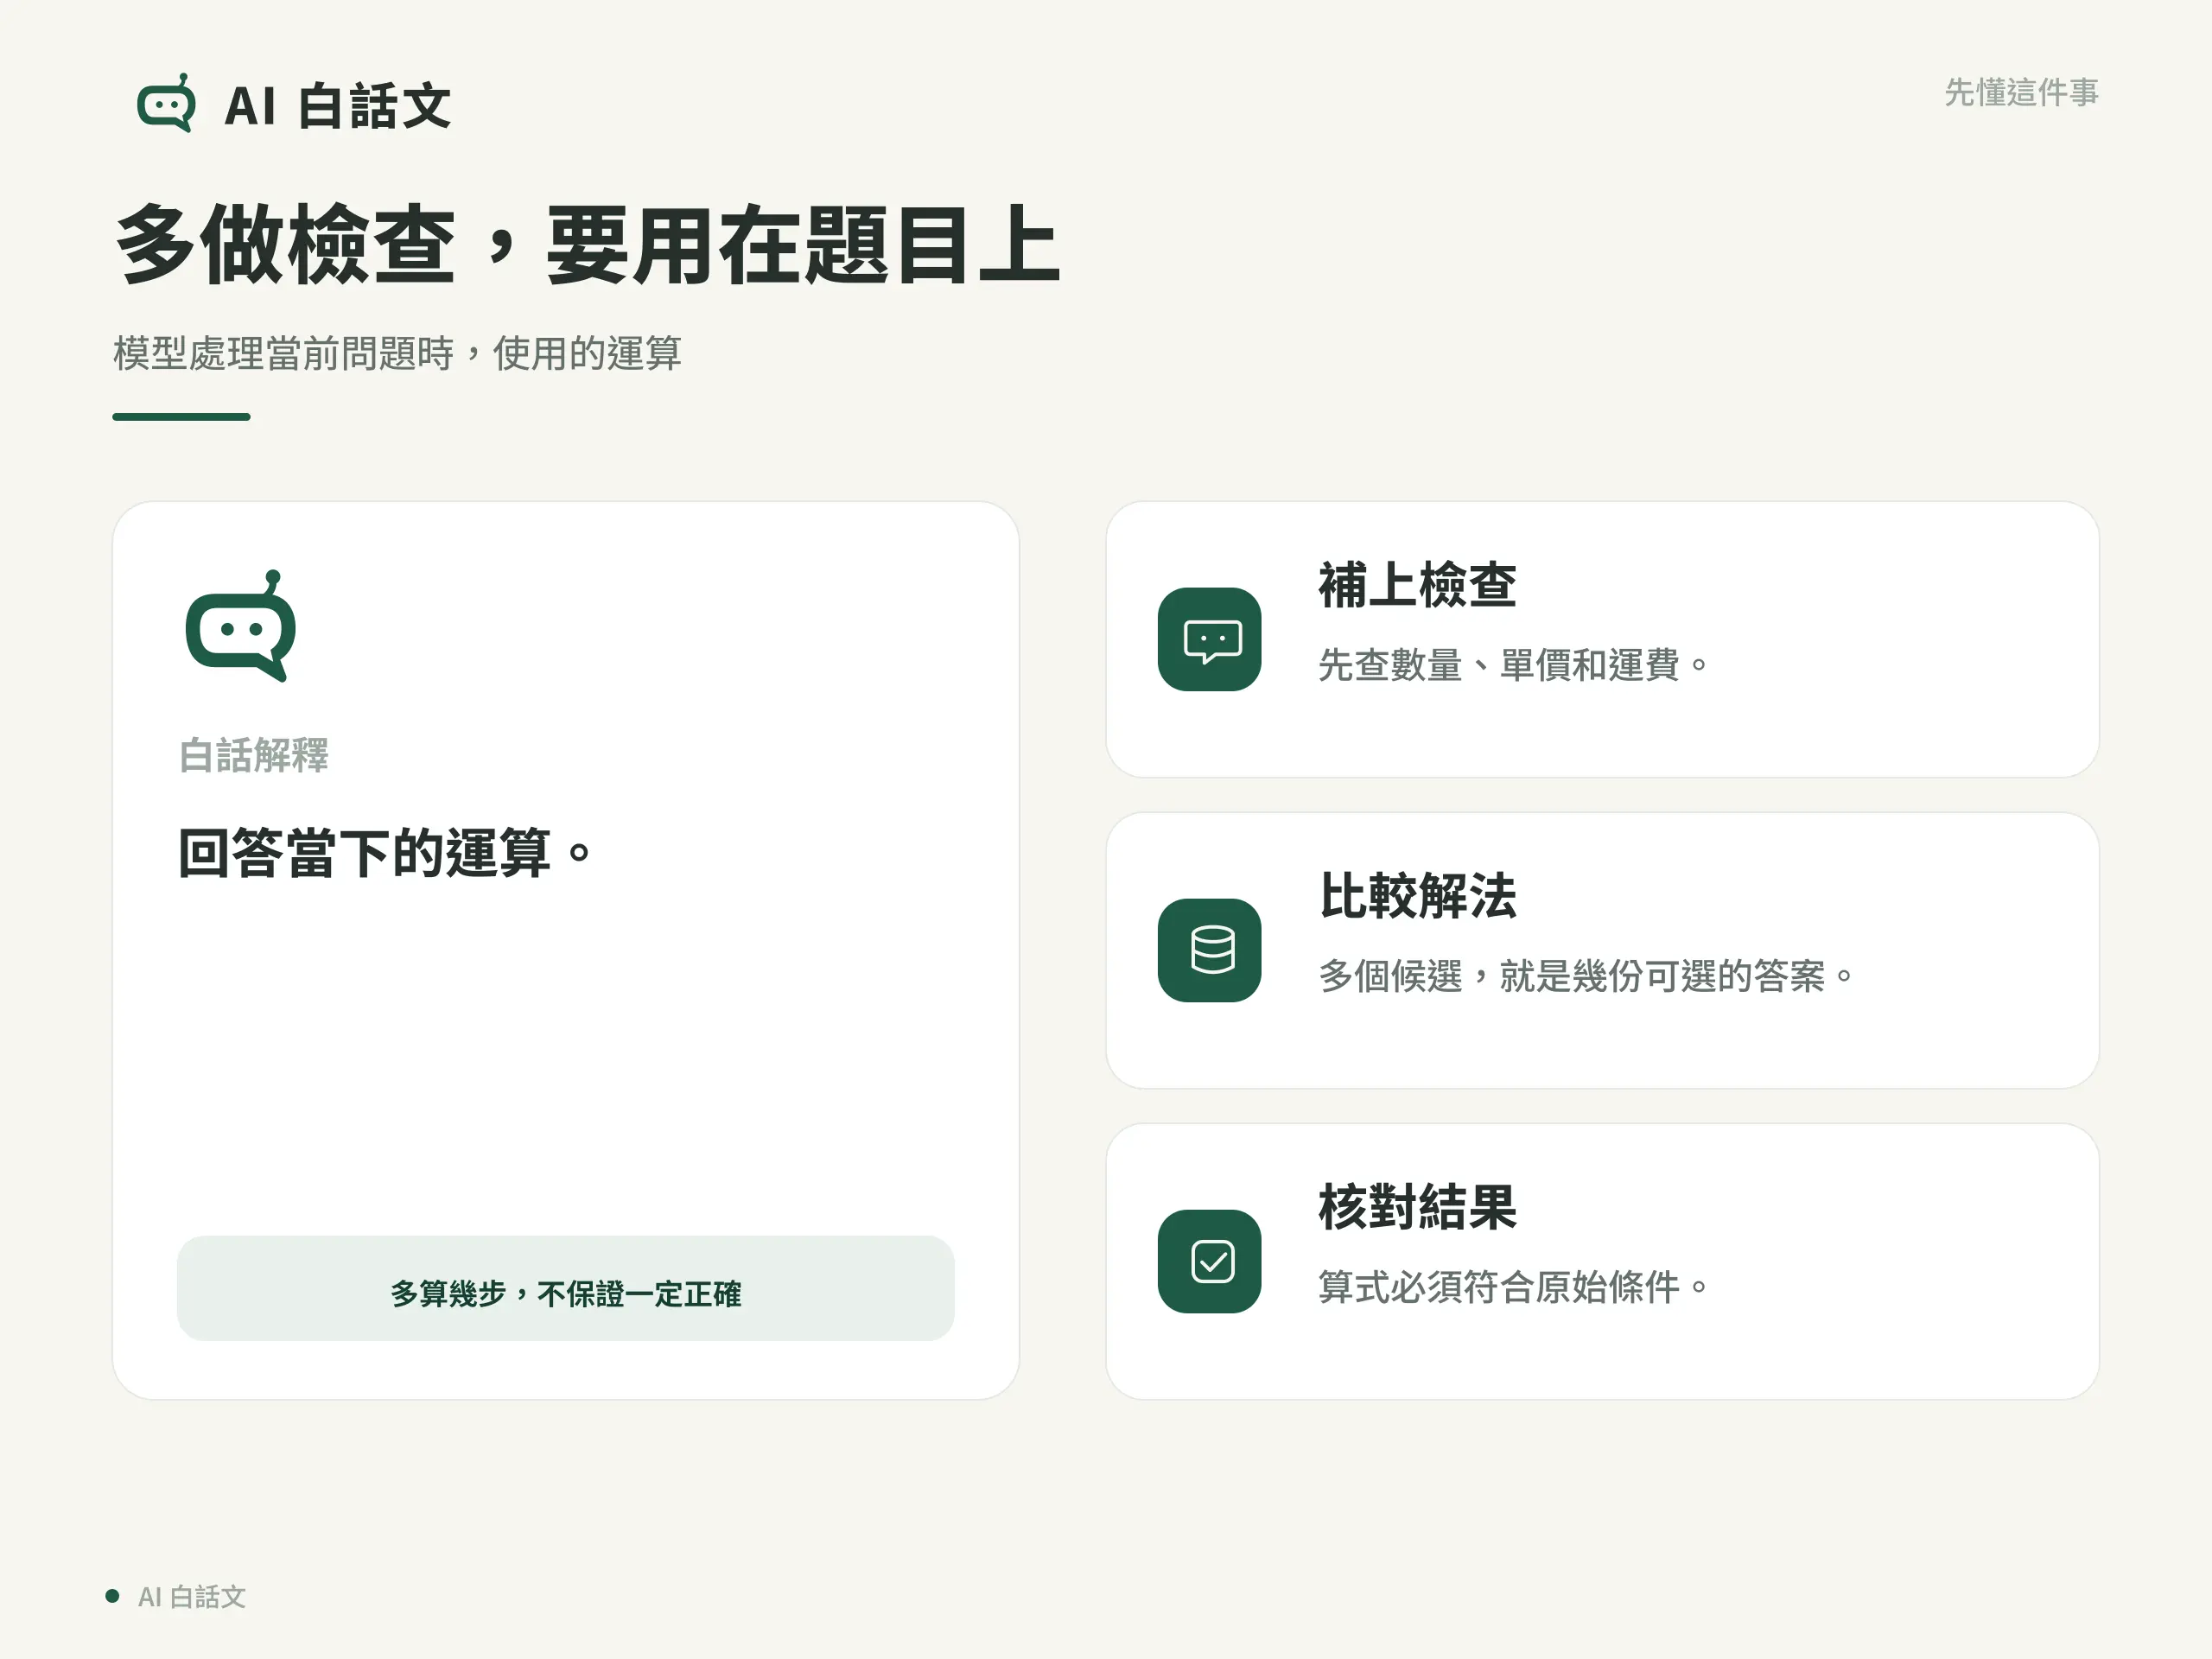
可以沿著目前解法補檢查,例如確認有沒有漏掉運費;也可以產生不同候選,也就是幾份暫時可選的解法,再比較結果。
有些系統還會依規則或其他檢查方法挑答案。新手先看它是否用完整條件得出可核對結果,不必先學會系統如何分配所有內部資源。
本題真正需要的是把運費算進去;多寫一大段購物心得,沒有解決比較總額的問題。
是不是算越多就越好?
不一定。相關研究發現,增加運算的效果與題目難度、使用方法有關,不能把某次研究結果套成所有模型的固定保證。
假如題目忘了提供運費,反覆計算也補不出真實金額。比較好的下一步是指出資料不足,請你補充,而不是猜一個數字繼續算。
一般使用者怎麼選擇?
把一句話改成禮貌語氣,可以先用一般模式。需要比較多個條件、計算多筆金額,或發現答案常漏項目時,再比較較深入的模式是否有幫助。
同一份資料下,觀察答案是否完整、計算是否正確,以及等待和用量是否可以接受。模式名稱、限制和費用依工具當前標示,不必把別人的方案當成自己的。
哪些現象不能拿來證明運算效果?
等待更久可能與服務忙碌或網路有關;回答更長也可能只是多寫了文字。這些都不能單獨證明內部多用了多少有效運算。
回到本例,無論答案長短,都要能對上 360 元、330 元和差額 30 元。若沒有新的有用檢查,就不必一直增加版本或要求更長的回答。
總結
測試時計算發生在模型回答問題的當下。增加運算可能幫助比較與查錯,但要把力氣用在題目需要的地方;先確認資料完整,再看答案是否真的更容易核對。
參考資料
重點整理
測試時計算是重新訓練 AI 嗎?
通常不是。它指模型處理當前輸入時的運算;訓練則會利用資料調整模型內部數值。
等得越久代表答案越準嗎?
不代表。等待可能受網路、服務忙碌或不同處理方式影響,仍要檢查答案本身。
每次都應該選最深入的模式嗎?
不一定。先用能完成任務的模式,再依漏條件、計算錯誤等實際結果比較是否需要增加處理。